Jevのconfidence閾値を決めるには?手元のデータで評価する手順
実行可能なPythonスクリプトでJevのconfidenceを評価します。自動処理した判断の誤り、自動処理率、フォールバックを測り、用途に合う閾値を選ぶ手順を解説します。
 Ofox
Jevのconfidence閾値は、ラベル付きデータを使い、自動処理に回した判断の誤りと、自動処理できたトラフィックの割合を測って決めます。安心できそうという理由だけで0.8や0.9を選んではいけません。質問、モデルのバージョン、入力母集団、フォールバックの動作が決まって初めて、閾値に意味が生まれます。
このチュートリアルでは、オフラインの評価スクリプト、正解が分かっている合成テストデータ、保存済みのJevログからホールドアウト評価へ進む手順を用意しています。対象は、問い合わせの振り分けなどのChoice型の分類質問です。実APIの呼び出しやJevの精度測定は行わず、重大な影響を伴う自動判断の安全性を検証するものでもありません。まだ応答を収集していない場合は、Jev APIガイドから確認してください。
どの数値に閾値を適用するのかを理解する
公式APIでは、回答の確率とconfidenceを区別しています。選択肢がn個あるChoiceのconfidenceは、公式には(n × p_max − 1) / (n − 1)で計算されます。選択肢が3個で、最大確率が0.8なら、confidenceは0.7です。同じ数値の閾値でも、どちらのフィールドに適用するかで意味が変わります。TypeSafeのconfidenceリファレンスを参照してください。
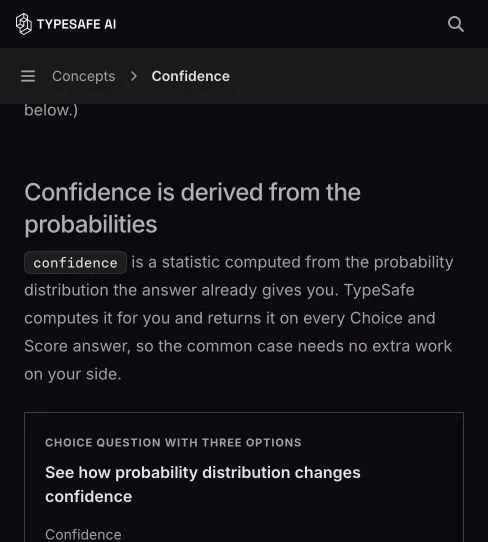
2026年10月2日に撮影した公式ドキュメントです。フィールドの定義を示すものであり、その閾値が手元のデータで有効だという証拠ではありません。
Scoreでは、順序のあるレベル間の距離を考慮した別の計算を使います。Noulはyesの確率を返しますが、独立したconfidenceフィールドはありません。3種類をすべて「確信度」という1列にまとめ、共通の境界値を適用しないでください。このチュートリアルのCSVが受け取るのは、固定した1つの質問に対して返されたChoiceのconfidenceです。
そのうえで、2つの概念を分けて測定します。校正は、予測確率が事例の集まりで観測された結果と対応しているかを問います。選択的な評価は、選んだ閾値以上で自動処理した判断が、どれだけ間違っていたかを問います。ほとんどの入力をフォールバックに回せば、確率の校正が悪くても、自動処理した部分の誤り率だけは良く見えることがあります。
結果を見る前に合格基準を定義する
問い合わせをbilling、technical、otherへ振り分けるアプリケーションを考えます。正しい分類とは、独立に付けたラベルと一致することです。情報が足りない、内容が矛盾している、分類対象外であるといった問い合わせをどう扱うかも、正解ラベルを作る段階で決めます。そうしないと、人間の確認者にも根拠を示せない答えをモデルが推測したことに、点を与えてしまいます。
許容できる最大誤り率、自動処理に回す最小の件数や量、遅延の上限、個別に確認が必要な誤りを記述してください。これらはアプリケーション側の判断であり、Jevから与えられる数字ではありません。どちらもラベルを返すからといって、取り消せる窓口への振り分けと、取り消せない操作を同じ合格基準にしてはいけません。
例を含むラベル付け基準を用意し、モデル出力を評価する前に確認者間の不一致を解消します。可能なら、ラベル付け時には予測結果を見せないでください。先にモデルの答えを読むと、「正解データ」が独立した証拠ではなく、モデルへの同意にすり替わることがあります。
開発用、検証用、最終テスト用を分ける
質問やカテゴリの定義を改善するには開発用データを使い、候補の閾値を比較するには検証用データを使います。最終ホールドアウトテストの前に、質問と閾値の両方を固定してください。最終テストを見ながら境界値を調整し続けると、そのデータも事実上の検証用データになります。
関連する行の間で情報が漏れ得る場合は、会話、顧客文書、テンプレートの系統といった単位で分割します。通常のトラフィックと重要な境界事例の両方を含めますが、境界事例を意図的に多く集めたなら、その結果は分けて報告してください。言語や入力長の区分も記録し、良い平均値によって未対応の集団が隠れないようにします。
この件数なら安全に導入できるという普遍的なサンプル数はありません。特に、自動処理した数件で誤りがゼロでも、分かることはわずかです。統計的な目安として、独立した試行で観測誤りがゼロなら、「3の法則」により誤り率の95%上限をおよそ3 / accepted_countと見積もれます。これは計画のための近似であって認証ではありません。事例間の相関、選択バイアス、分布の変化があると、この解釈は成り立たなくなる場合があります。厳密な推定には、評価責任者と適切な区間推定・標本設計を選んでください。
固定した質問の応答からCSVを作る
Jev判断キットをダウンロードして展開します。必要なのはPython 3だけです。標準ライブラリのみを使うため、APIキーやネットワーク接続は不要です。
付属ファイルには5つの列があります。
| 列 | 意味 | 検証条件 |
|---|---|---|
id | 事例の一意な識別子 | 必須、重複不可 |
gold | 独立に付けたカテゴリ | 失敗したリクエストも含め必須 |
predicted | 返されたChoiceラベル | statusがokなら必須 |
confidence | 返されたChoiceのconfidence | statusがokなら0~1の有限数 |
status | okまたはerror | エラーも総トラフィックに含め、必ずフォールバック扱い |
実際の応答モデル、リクエストID、全選択肢の確率、質問のバージョン、元データの分割情報は、idで結び付けた別のトレース台帳に保持します。この小さな評価ツールは、それらのメタデータを強制しません。複数のモデルバージョンや質問を1つのCSVに混ぜ、その結果を1つの検証済み方針として説明しないでください。
以下は付属する手作業の合成テストデータの一部であり、Jevの応答ではありません。
id,gold,predicted,confidence,status
case-1,billing,billing,0.98,ok
case-2,technical,technical,0.94,ok
case-3,billing,technical,0.91,ok自分のファイルを作るときは、保存した応答から、閾値を適用する前に丸めずに値を転記します。失敗したリクエストもerror行として残し、predictedとconfidenceを空欄にしてください。タイムアウトを削除すると、見かけの自動処理率が高くなります。
評価ツールを実行し、計算を確認する
展開したディレクトリで、次を実行します。
python3 evaluate.py synthetic.csv
python3 evaluate.py synthetic.csv --thresholds 0.8 0.9最初のコマンドを、付属の8件の合成データでローカル実行しました。以下は計算ツールの処理を検証した結果であり、Jevの性能測定ではありません。
| 閾値 | 自動処理件数 / 全件数 | 自動処理した中の誤り | 自動処理率 | 自動処理した中の誤り率 |
|---|---|---|---|---|
| 0.50 | 6 / 8 | 2 | 75% | 33.33% |
| 0.80 | 5 / 8 | 1 | 62.5% | 20% |
| 0.90 | 3 / 8 | 1 | 37.5% | 33.33% |
| 0.95 | 1 / 8 | 0 | 12.5% | 0% |
自動処理率はaccepted / all eligible cases、自動処理した中の誤り率はwrong accepted / acceptedです。自動処理した事例がゼロなら、スクリプトは誤り率をnullとし、完全な正解率を達成したかのようには扱いません。
このデータでは、閾値を0.80から0.90へ上げると、観測された誤り率が悪化する点に注目してください。有限のサンプルでは、閾値を高くしても誤り率が単調に改善する保証はありません。0.95の行には誤りがありませんが、自動処理したのは1件だけで、信頼性の証拠として不十分です。実データを扱う前に、この2つの読み違いに気付けるよう、例を意図的に構成しています。
方針を選び、処理全体をテストする
検証用データでは、候補の閾値ごとの集計と、実際に自動処理して間違えた事例を見ます。許容誤りの条件を満たさない方針は除外してください。残った候補について、自動処理率、フォールバック先の処理能力、費用、遅延を評価します。条件を満たすものがなければ、結論は「この質問はまだ自動化しない」であり、「最もましな数値を選ぶ」ではありません。
選んだ閾値を固定し、ホールドアウトデータで1回評価します。フォールバックも評価してください。confidenceの低い判断を別のモデルや人に渡しただけでは、成功したことにはなりません。利用できない処理先や、最後まで完了しない事例も含めて、ワークフロー全体を採点します。
保守的な方針の骨格は、次のようになります。
if response_error or label_not_allowed or confidence_invalid:
    fallback()
elif confidence < validated_threshold:
    fallback()
else:
    enforce_permissions_and_business_rules()
    route_to_handler()
これはアプリケーション用の疑似コードであり、そのまま実行できるJev SDKの例ではありません。比較の前に、confidenceの欠損、非有限値、範囲外の値を拒否します。NaNが数値の比較をすり抜けないようにしてください。認可、入力検証、業務ルールはコード側で実施します。confidenceが高くても、これらの制御を省略してはいけません。振り分けた先の操作に副作用がある場合は、通常の処理と同じ冪等性や確認の仕組みを使います。
失敗を隠さず、原因を切り分ける
| 観測されたこと | 次に調べること |
|---|---|
| CSVが拒否される | ID重複、ラベル欠損、非有限値、未対応のstatus。集計する前にエクスポートを修正する |
| 高confidenceなのにラベルが間違う | 曖昧なカテゴリ定義、名前と説明の矛盾、stateの情報不足、対象外の入力 |
| 全体は良いが特定言語で悪い | 言語ごとのラベルと検証。英語の性能がそのまま移ると仮定しない |
| 自動処理率が極めて低い | 質問の粒度、文脈の不足、実際の不確実性。追加される誤りを測らずに閾値を下げない |
| 振り分けは成功するがタスクが失敗する | 振り分け先の実行、引数、ツールエラー、フォールバックの結果 |
| 更新後に結果が変わる | 応答モデルのバージョン、質問のハッシュ、前処理、選択肢、トラフィック構成 |
公開研究の読み方については、Jevのベンチマークで分かることも参照してください。ベンチマーク上の校正結果では、個別の本番環境の閾値を承認できない理由を説明しています。
閾値をバージョンと結び付けて管理する
再現性が必要なら評価したモデルのバージョンを固定し、応答が報告する実際のバージョンも記録します。質問を変更する、選択肢を増やす、stateを翻訳する、前処理を変える、モデルを更新するといった場合は再評価してください。閾値自体が同じでも、その入力が変われば方針は変わります。
まずシャドーモードで判断を記録し、その後、ロールバック責任者を明確にしたうえで、取り消し可能な範囲に限定して導入します。新しくラベルを付けたサンプルを使い、自動処理した誤り、全体の自動処理率、フォールバックの負荷、タスクの完了結果を監視してください。実験を組み直さなくても戻せるよう、前の方針を保存します。
最後に、測定した自動処理率をルーティング費用計算ツールへ入力します。閾値に価値があるのは、タスクの品質基準を満たし、アプリケーション全体を無理なく運用できるときです。見栄えのよい小数を得ることが目的ではありません。
よくある質問
- Jevのconfidenceが0.9なら、90%の確率で正しいという意味ですか?
- いいえ。APIのconfidenceは回答の確率分布を要約した値です。質問、入力母集団、モデルのバージョンを固定し、独立に付けたラベルと照合して正しさを測る必要があります。
- 付属スクリプトはJevを呼び出したり、料金を発生させたりしますか?
- いいえ。Pythonの標準ライブラリでローカルCSVを読み込みます。付属データは手作業で作ったテスト用の合成データで、Jevの出力ではありません。