GPT‑6.1 Sol API 비용 계산: 캐시와 긴 입력은 어떻게 과금될까?
입력·캐시 읽기·쓰기·출력을 나눠 Sol 비용을 계산하고 긴 컨텍스트 기준과 처리 모드를 확인합니다. 오프라인 계산기와 요청별 대조 방법도 제공합니다.
 Ofox
GPT‑6.1 Sol Standard API의 기본 요금은 입력 100만 토큰당 2달러, 출력 100만 토큰당 10달러입니다. 하지만 Agent 예산은 이 두 숫자만으로 계산할 수 없습니다. 캐시 읽기와 쓰기, 긴 입력, 처리 모드, 도구 비용까지 구분해야 합니다. 이 글은 단일 요청 계산부터 여러 단계 작업의 청구 대조까지 설명합니다.
2026년 9월 30일 OpenAI 모델 문서와 API 요금표를 확인했습니다. 예시는 모두 USD 기준의 가상 계산이며 실제 고객 청구서나 유료 모델 측정값이 아닙니다. Ofox 판매가나 ChatGPT 구독 크레딧도 아닙니다.
중복되지 않는 네 항목으로 나누기
| Standard, 입력 272,000토큰 이하 | 100만 토큰당 USD |
|---|---|
| 일반 비캐시 입력 | 2.00 |
| 캐시 읽기 | 0.10 |
| 캐시 쓰기 | 2.50 |
| 출력: 과금되는 추론 토큰 포함 | 10.00 |
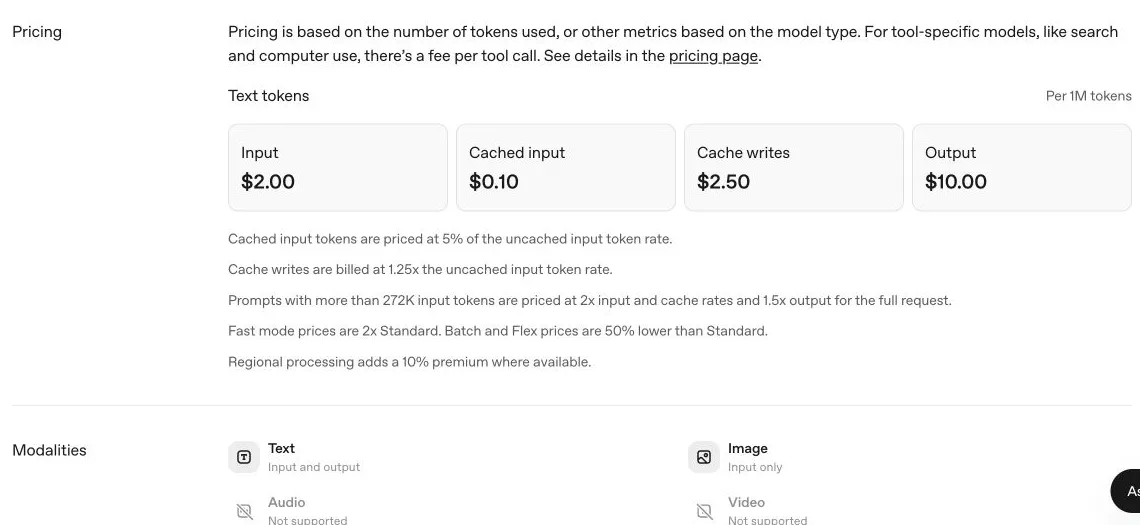
실제 영문 문서 화면입니다. 공개 요금을 보여 주며, 청구서나 생성 실행 결과는 아닙니다.
일반 입력 U, 캐시 읽기 R, 캐시 쓰기 W, 출력 O를 사용하면 짧은 Standard 요청은 다음과 같습니다. 입력의 세 항목은 서로 겹치면 안 됩니다.
USD = (2 × U + 0.10 × R + 2.50 × W + 10 × O) / 1,000,000전체 입력 필드에 캐시 토큰이 이미 포함됐다면 전체에 일반 요금을 적용한 뒤 캐시 요금을 더하면 이중 계산입니다. 먼저 해당 엔드포인트의 usage 의미를 확인하고 서로 중복되지 않는 항목에 대응시키세요. 세부 값이 없다는 것은 미확인이지 0이 아닙니다. 제공하는 계산기는 공급자 응답을 추측하지 않고 각 항목을 명시적으로 받습니다.
추론 토큰도 주의해야 합니다. 출력 합계가 추론을 포함한다면 상세 값을 다시 더하지 않습니다. 반대로 화면에 보이는 답변만 세면 과소 계산할 수 있습니다. 과금 출력 합계로 계산하고 추론 내역은 구성 설명에 사용합니다.
긴 입력 기준을 넘으면 요청 전체 단가가 바뀐다
입력이 272,000토큰을 초과하면 입력·캐시 단가는 2배, 출력은 1.5배가 되고 요청 전체에 적용됩니다. 초과한 부분만 비싸지는 것이 아닙니다. 문서의 이 조건에서 정확히 272,000은 짧은 구간입니다.
| Standard 긴 입력 | 100만 토큰당 USD |
|---|---|
| 일반 입력 | 4.00 |
| 캐시 읽기 | 0.20 |
| 캐시 쓰기 | 5.00 |
| 출력 | 15.00 |
새 토큰만이 아니라 전체 입력으로 판단합니다. 일반 20,000과 캐시 읽기 260,000은 총 280,000이므로 긴 구간입니다. 새 입력이 2만뿐이라는 이유로 짧은 요금을 적용하면 안 됩니다.
일반 입력 300,000과 출력 10,000은 300000 × 4 / 1M + 10000 × 15 / 1M = 1.35달러입니다. 짧은 요금을 쓰면 0.70달러지만 이 요청에는 맞지 않습니다. Agent 이력이 길어지면 최초 사용자 질문보다 누적 이력이 비용을 더 크게 좌우할 수 있습니다.
총 컨텍스트 1,050,000은 전부 입력에 쓸 수 있다는 뜻이 아닙니다. 최대 입력과 출력은 별도 제한입니다. 답변 공간을 남기고 도구 정의와 결과도 입력 예산에 넣으세요. 문자 수를 정확한 토큰 수처럼 사용하지 말아야 합니다.
네 가지 계산 예시
세금, 도구, 저장 공간, 지역 처리 추가 요금은 제외합니다.
| 상황 | U | R | W | O | Standard USD |
|---|---|---|---|---|---|
| 짧은 비캐시 요청 | 20,000 | 0 | 0 | 5,000 | 0.090 |
| 참고 자료 재사용 | 10,000 | 100,000 | 0 | 5,000 | 0.080 |
| 최초 캐시 쓰기 | 10,000 | 0 | 100,000 | 5,000 | 0.320 |
| 긴 비캐시 요청 | 300,000 | 0 | 0 | 10,000 | 1.350 |
두 번째와 세 번째는 서로 다른 요청입니다. 재사용 가능한 캐시가 생기기 전의 쓰기를 읽기 요금으로 계산할 수 없습니다. 한 번 쓰고 아홉 번 실제 적중하면 0.32 + 9 × 0.08 = 1.04달러입니다. 매번 일반 입력 110,000과 출력 5,000으로 열 번 처리하면 2.70달러입니다.
단, 아홉 번 모두 실제 적중하고 항목 분류가 청구와 같아야 합니다. 접두부 변경, 만료, 라우팅 차이, 캐시 불가 요청은 가정을 깨며 출력 길이도 달라질 수 있습니다. 절감 보장이 아니라 부하 예시입니다. 쓰기·적중·미적중을 함께 기록하세요.
현재 캐시 문서는 GPT‑5.6 이후에 prompt_cache_options.ttl="30m"를 사용하고 마지막 쓰기 또는 재사용 후 최소 30분을 설명합니다. 캐시 가능 접두부는 보이는 입력 토큰 1,024개 이상이어야 합니다. 과거의 prompt_cache_retention: "24h"를 그대로 쓰지 마세요. 암묵적 방식과 명시적 경계 방식을 구분하고, 명시적 방식에서는 경계를 지정하지 않으면 캐시가 기록되지 않습니다. 자주 바뀌지 않는 공통 자료를 먼저 놓고 요청마다 바뀌는 내용을 뒤에 배치한 다음 실제 캐시 사용량을 확인하세요. 보관 시간 조건은 변경된 요청의 적중을 보장하지 않습니다. 호출 간격이 짧거나 같은 글을 반복했다는 사실만으로 적중을 판단할 수 없습니다.
Standard·Fast·Batch·Flex 구분
Fast는 Standard의 2배이고 Batch와 Flex는 각각 절반입니다. 서로 다른 처리 모드이지 중첩 할인 쿠폰이 아닙니다. 모델, 엔드포인트, 작업의 지원 조건을 확인하세요. Batch를 일반 대화 요청의 자동 할인으로 보거나 Flex에 Standard와 같은 지연 보장이 있다고 가정하면 안 됩니다.
0.09달러 예시는 동일 토큰 수에서 Fast 0.18, Batch/Flex 0.045입니다. 긴 1.35달러 예시는 2.70과 0.675입니다. 실제 답변이 달라지면 사용량도 바뀝니다.
해당하는 지역 처리에는 10% 추가 요금이 있습니다. 실제 그 옵션을 이용한 요청에만 적용합니다. EU 데이터 레지던시에서는 Fast를 사용할 수 없습니다. 각 계수가 표에 있다고 양립하지 않는 옵션을 결합하지 마세요.
오프라인 계산기 사용
Python 계산기 다운로드. 표준 라이브러리만 사용하며 네트워크와 API 키가 필요 없습니다.
python3 cost_calculator.py --ordinary 10000 --read 100000 --write 0 --output 5000 --mode standard예상 출력은 0.080000 USD입니다. --mode는 fast, batch, flex로 바꿀 수 있습니다. --regional은 계산에 추가 요금을 적용할 뿐 자격을 확인하지 않습니다. 음수와 --region eu --mode fast 조합은 거부합니다.
산술은 로컬 테스트를 했지만 유료 Sol 호출의 실제 청구와 대조하지 않았습니다. 모델의 컨텍스트와 최대 출력 용량은 검증하지 않으므로 계산 가능하다고 API가 받는 것은 아닙니다. 날짜가 정해진 요금표로 자동 업데이트되지 않으니 나중에 사용할 때 재확인하고 계산 버전을 보관하세요. 도구 비용이 제외됐다는 말은 도구가 무료라는 뜻이 아닙니다.
메시지 수가 아니라 요청별로 대조하기
하나의 작업에는 여러 모델 요청이 있고 지시, 이력, 도구 정의와 결과가 매번 다른 양으로 전송됩니다. 첫 요청 비용에 보이는 메시지 수를 곱하는 방식은 신뢰하기 어렵습니다.
task_id, request_id, model, timestamp, mode, region,
input_total, ordinary_input, cache_read, cache_write,
output_total, reasoning_detail, tool_type, tool_quantity,
token_estimate_usd, tool_charge_usd, billing_adjustment_usd
각 행에서 입력 항목 합계와 전체를 맞추고 긴 입력 여부를 별도로 판단합니다. 출력 합계와 추론 내역을 분리하고 실제 도구 사용량을 해당 요금으로 더한 뒤 작업별 집계합니다. 요청 ID를 보관하면 비공개 프롬프트를 저장하지 않아도 차이를 조사하기 쉽습니다.
성공 요청뿐 아니라 과금 사용량이 확인된 실패와 재시도도 포함하세요. 모든 HTTP 실패가 유료라고 가정하면 안 되지만, 유용한 답이 없었다고 사용량이 없었다고 볼 수도 없습니다. usage와 청구 증거를 확인해야 합니다. 검수 통과 작업당 비용에는 최종 합격 여부까지 필요합니다.
예상 비용과 청구가 다르면
먼저 단위와 범위를 확인하세요. 달러인지 크레딧인지, 백만인지 천인지, API인지 구독인지, 한 요청인지 작업 전체인지 구분합니다. 다음으로 캐시 분류와 이중 입력 계산, 길이, 모드, 지역, 추론 출력을 봅니다. 마지막으로 도구, 재시도, 공급자 조정 비용을 확인합니다.
게이트웨이는 다른 가격과 usage 표시를 쓸 수 있습니다. OpenAI 요금에서 Ofox 할인율을 추론하지 말고 정확한 모델과 현재 카탈로그를 따로 확인하세요. 모델 선택은 Sol과 Astra 비교, 앱 이전은 영문 업그레이드 가이드와 Responses 도구 이전을 함께 참고할 수 있습니다.