GPT‑6.1 Sol 和 Claude Sonnet 5.5 怎么选?编码流程与 API 费用对比
两款模型短请求标价相同,但缓存、长上下文和工具接口不同。用同口径算例与任务验收方法选择,不虚构实测排名。
 Ofox
GPT‑6.1 Sol 与 Claude Sonnet 5.5 的 Standard 短上下文标价相同:每百万未缓存输入 2 美元、输出 10 美元。因此“哪个更便宜”取决于工作负载:缓存方式、输入长度、生成 token、失败重试和工具迁移成本都可能改变答案。
本文于 2026 年 9 月 30 日核对官方规格、定价与工程条件,不是两款模型的编码实测。算例固定 token 数,只比较费率;相同文字在两家未必产生相同 token 数。厂商与旧模型比较的宣传百分比,也不能证明这两款模型在你的仓库中谁更强。
同价不等于相同使用条件
| 决策项 | GPT‑6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| 精确模型 ID | gpt-6.1-sol | claude-sonnet-5-5 |
| 短档普通输入/输出,美元每百万 | 2 / 10 | 2 / 10 |
| 缓存读取,美元每百万 | 0.10 | 0.20 |
| 短 TTL 示例的缓存写入 | 2.50 | 5 分钟缓存为 2.50 |
| 缓存时效选项 | 当前文档为 30 分钟 TTL | 1 小时写入为每百万 4.00 |
| 长输入计费 | 超过 272K,整请求加价 | 当前定价对该代支持的完整 1M 上下文采用标准价 |
| 本文涉及的工具协议 | Responses 调用及结果项 | Claude 原生 tool-use/tool-result 消息 |
| 较容易开始的集成 | 已有正确 Responses 循环 | 已有正确 Claude 原生循环 |
来源:Sol 规格、OpenAI 缓存、Sonnet 发布说明、Anthropic 定价。第三方平台需要另查具体路由;原厂文档不证明网关价格或兼容性。
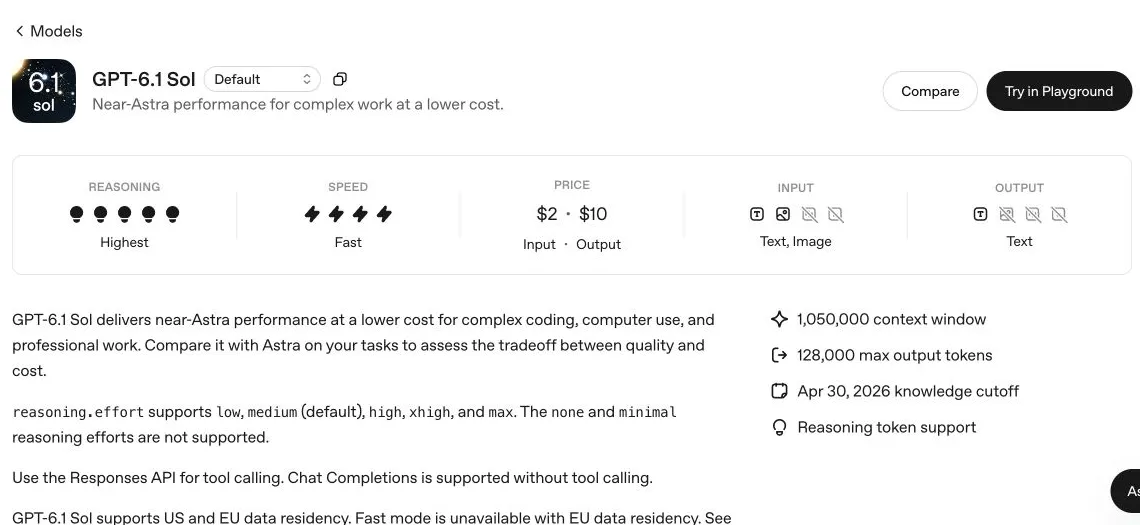
真实 OpenAI 英文截图,展示对比中的 Sol 一侧。Sonnet 事实依据是所链接的 Anthropic 文字原文;图片不是双模型实测结果。
用三种工作负载算一遍
第一种是 20,000 普通输入、5,000 输出,无缓存。两者 Standard 都是 0.04 + 0.05 = 0.09 美元,没有基础单价赢家。若某模型要重试一次或产生更长推理,实际任务费用才会不同,需要真实用量验证,不能从同价推导同成本。
第二种是 10,000 普通输入、100,000 缓存读取、5,000 输出。Sol 为 0.02 + 0.01 + 0.05 = 0.08,Sonnet 为 0.02 + 0.02 + 0.05 = 0.09。Sol 读取单价低一半,但这笔完整请求只便宜约 11.1%,不是 50%。这里尚未计算首次写入,而且假设两边都真正命中。
进一步假设同一 100K 前缀写入一次、读取九次,每次另有 10K 普通输入与 5K 输出。Sol 总计 1.04 美元,Sonnet 按 5 分钟写入计价的例子为 1.13 美元。必须确保读取符合各自缓存时效与匹配条件,不能暗示任意间隔都能命中。若改用 Sonnet 1 小时写入或出现缓存未命中,总额会变化。
第三种是 300,000 普通输入、10,000 输出。Sol 跨过门槛,为 1.20 + 0.15 = 1.35 美元;Sonnet 在其支持上下文内按标准费率计算为 0.60 + 0.10 = 0.70 美元。这给长资料场景提供了成本信号,却没有证明提取准确率相同。工具定义和输出预留也需要计入各自容量条件。
短代码 diff、重复参考资料和长仓库输入是三种不同负载。把其中一个百分比套到所有任务,会掩盖它成立的前提。
现有工具链决定从谁开始更合理
如果应用已用 OpenAI Responses,并且多轮循环验收过,Sol 可以作为先测的候选,因为协议调整较少。但仍要检查限制:Sol 工具需要 Responses,过去能用的 Chat Completions 包装不一定继续适用。完整迁移示例展示输出项、call ID 和有界分发器。
如果生产 Agent 原本采用 Claude 原生工具,先保留 Sonnet 往往能减少协议改造。跨厂商时要重新核对 Schema、响应事件、会话状态和缓存控制。OpenAI 兼容网关可能翻译部分结构,但翻译层也必须纳入测试;普通文本请求成功不等于工具兼容。
工程成本应与推理费用分开。低调用量团队验证新协议的投入,可能超过小幅缓存价差;高调用量服务则可能相反。应使用自己的流量和投入估计,不能替团队虚构开发时薪或迁移天数。
按任务和验收能力选择
| 任务条件 | 合理的第一轮实验 | 采纳前要有的证据 |
|---|---|---|
| 现有 Responses Agent 做局部修错 | 原工具框架测试 Sol | 回归测试、正确工具结果、审查投入 |
| 现有 Claude 编码/文档流程 | 同流程测试 Sonnet | 代码或导出文件通过验收,无遗漏要求 |
| 大段未缓存文档/仓库 | 两边都测,正确套长档价 | 来源支持、遗漏数、完整用量 |
| 大量复用上下文 | 比较实际命中率与任务费用 | 写入、读取、未命中、输出、重试 |
| 不可逆或高影响操作 | 先只读提案,再验证 | 授权与动作正确性,不依赖品牌 |
这些是从接口和价格条件推导的实验起点,不是本文测出的优势。Anthropic 将 Sonnet 5.5 定位于边界清楚的日常任务、修错与精致文档;OpenAI 将 Sol 定位于以低于 Astra 的成本处理复杂工作。定位帮助选择测试任务,不能替代测试。
Sonnet 发布说明中的速度和任务成本提升,对照的是 Sonnet 5,不能换成“比 GPT‑6.1 Sol 更快更省”。“接近 Astra”同样无法得出对 Sonnet 的胜负。本文不拼接不同工具、推理预算和评测框架的分数榜,避免制造虚假的可比性。
怎样组织一次可复现比较
选取业务中真实会验收的任务类型:有预期行为的失败测试、带约束的小功能、带回归检查的重构、需要来源支持的文档任务。使用临时分支或合成仓库,外部服务调用前移除密钥和私密客户资料。
给两边相同的文件范围、工具权限、验收标准和停止条件。记录精确模型、客户端/供应商、日期、推理设置、指令与环境。不同厂商的同名推理档位不是相同计算量,因此应公开配置,而不是宣称名字一致就公平。
先评估结果是否可用。代码跑相关测试,检查无关改动、缺失异常处理和安全敏感行为;文档检查必需章节、来源证据及真实导出文件。随后记录 token 与工具费用、耗时、重试和人工修改时间。模型热情地说“完成了”不能计作成功。
重复足够多的代表任务,报告样本量并保留失败。小试验能支持局部上线决策,不能推出“全球最强编码模型”。保留回滚路径;工具框架或版本改变后重新评估,否则可能把工具改进误算成模型能力提升。
最终如何做选择
短请求同价、迁移又没有已证明收益时,先选适配现有已验收工具链的一款。大量长输入值得重点比较 Sonnet 的计费条件;缓存密集的 Responses 工作流值得测试 Sol,但要计入写入和未命中。只有能可靠识别失败、且收益覆盖额外运维复杂度时,再考虑双模型分流。
缺少验收方法时,多加一个模型不会自动解决评估问题。先构造可检查任务。OpenAI 家族内部的复杂任务升级可看 Sol 与 Astra;完整计费条件看费用指南。Ofox 当前是否接入、价格和协议如何,都需独立核验,本文没有据此承诺折扣或兼容性。