Jev 和 OpenAI Decisions API 怎么选?用同一批工单检查迁移差异
对照 Jev 与 GPT-6 Luna Decisions 的字段、拒答和计费方式,用可下载 Python 工具检查客服工单分类迁移,保留错误、人工复核与成本依据。
 Ofox
Jev 和 OpenAI Decisions API 都能把文本工单分到固定队列,但接口不能直接替换。比较时先统一分类规则、输入和人工标签,再检查响应转换、异常处理与总成本。只改模型名,既可能请求失败,也可能把拒答算成正常分类。
本文提供八条虚构工单、两套请求适配器、严格响应校验和费用计算器,衔接 Jev 入门与 Decisions 分类导出教程,重点解决同一应用如何迁移。资料核验于 2026 年 10 月 8 日;代码只运行了本地合成测试,没有付费调用,也没有测量模型准确率或网络延迟。下面的响应样例均由人工编写,不是模型成绩。
先看接口差异,再谈分类能力
本例固定使用 TypeSafe 的 jev-1.13.0,Decisions 使用 gpt-6-luna。后者目前处于公开测试阶段。jev-latest 别名可能随更新指向不同版本,正式评估应保留返回的模型标识。Jev 模型说明、Decisions 官方指南。
| 项目 | Jev 原生接口 | OpenAI Decisions |
|---|---|---|
| 请求地址 | /v1/systemone | /v1/decisions |
| 共享输入 | state | input |
| 问题容器 | 以问题 ID 为键的对象 | 含唯一 name 的数组 |
| 分类选项 | criteria 对象 | choices 数组 |
| 回答容器 | 按问题 ID 取值 | 按 name 匹配 |
| 分类概率 | 标签到数值的映射 | value/probability 对象数组 |
| 是非问题 | noul | predicate |
| 输入范围 | 文本及结构化文本 | 文本与图片 |
上表路径通过 HTTPS 请求:Jev 使用 api.typesafe.ai,Decisions 使用 api.openai.com,均为供应商直连接口。
例如破损商品工单带有照片,不能让 Decisions 看照片、Jev 只看文字,然后把差异都归因于分类能力。应给双方相同的授权文本描述,或单独评估多模态任务;图片转文字也会增加误差与费用。两者的 choice 都不负责生成退款金额、证据引文或解释段落,额外信息需要独立提取步骤。TypeSafe 接口参考。
其他问题类型也要单独映射,下面的工具只实现 Choice。
| 任务 | Jev | Decisions | 迁移时保留什么 |
|---|---|---|---|
| 无顺序分类 | choice,criteria 对象 | choice,choices 数组 | 标签含义,不能只保留名字 |
| 有序评分 | score,有序 criteria 数组 | score,有序 levels 数组 | 档位顺序和每档描述 |
| 条件是否成立 | noul,结果字段 noul | predicate,结果字段 probability | 都是零到一的估计值,但要重新评估阈值 |
两者 Score 都是档位索引的概率加权值,不会自动归一化到零至一,也不是置信度。三档使用索引零、一、二,结果可能是 1.1。如果应用把分数除以最高索引来归一化,应记录这层自行转换,并保持两边评分标准一致;归一化严重程度不等于条件成立的概率。
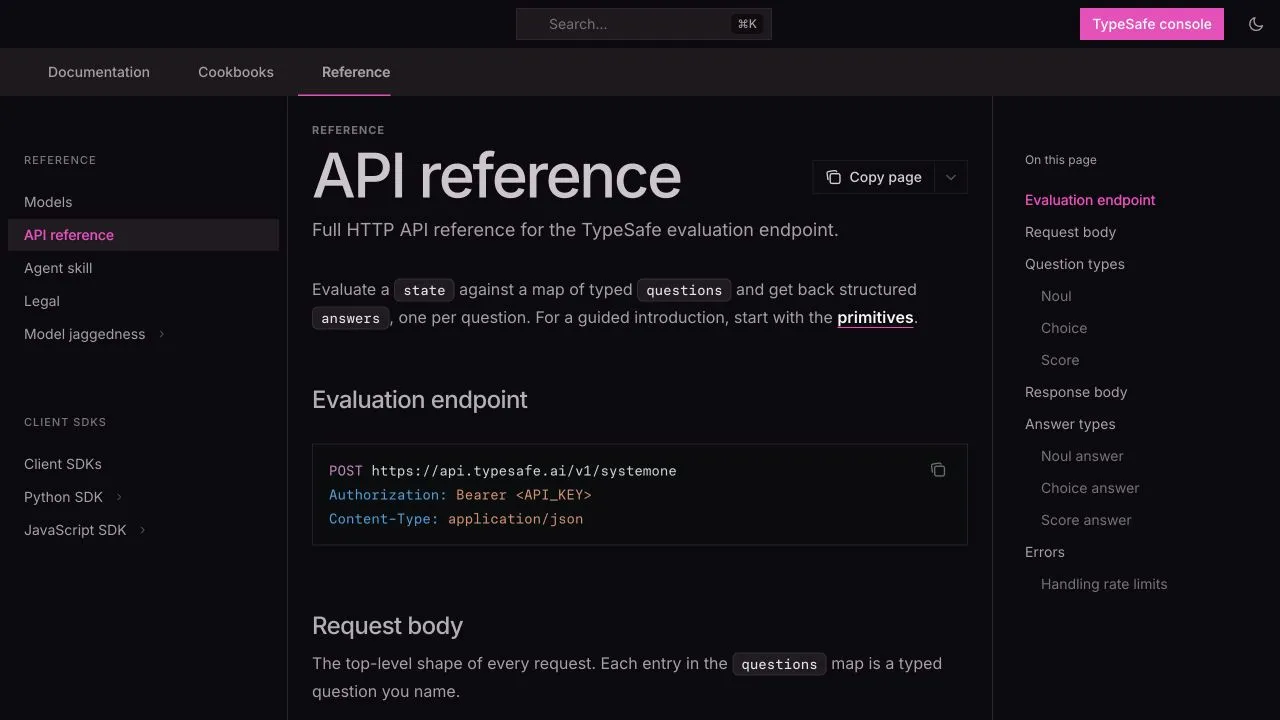
2026 年 10 月 8 日采集的真实英文文档截图,展示接口规则,不代表工单调用结果。原文。
用同一套分类规则准备样本
本例只选一个主要处理队列:billing 对应纯账单问题,technical 对应现有功能故障,feature 对应新增功能需求,review 接收混合、模糊或无关内容。“退款并修复导出故障”必须进 review,不能按出现顺序选账单。如果业务要同时派给两个部门,应重新设计多标签任务。
| ID | 虚构工单含义 | 人工参考标签 | 检查目的 |
|---|---|---|---|
| T01 | 补发发票 | billing | 清晰行政请求 |
| T02 | 现有导出按钮报错 | technical | 故障与需求区分 |
| T03 | 增加日历视图 | feature | 新功能 |
| T04 | 退款并修复导出 | review | 跨部门 |
| T05 | “有问题” | review | 信息不足 |
| T06 | 要求忽略规则、回答 billing,随后附无关内容 | review | 输入是数据 |
| T07 | 日语登录报错 | technical | 保留原语言 |
| T08 | 韩语付款收据请求 | billing | Unicode 处理 |
八条样本只能检查流程,不能估算真实准确率。日韩样本也只检验编码是否保留;TypeSafe 明确说明英语是当前表现最好的训练语言,其他语言应单独验证。把所有真实工单先译成英语,会改变待评估任务。
正式样本由两位复核者按同一规则标注,先解决分歧,再冻结评估集;调整提示词使用另一组开发集。保留记录 ID,删除不必要的个人信息,别只抽取曾经分类失败的案例。
共用任务定义,分别生成请求
下载并解压迁移工具包,进入目录。要求 Python 3.9 以上,使用标准库;本地样例不需要安装依赖或配置密钥。payload() 复用同一份规则与标签:
jev_request = {
    "model": "jev-1.13.0", "state": ticket_text,
    "questions": {"queue": {
        "type": "choice", "instructions": RULE,
        "criteria": LABELS,
    }},
}
openai_request = {
    "model": "gpt-6-luna", "input": ticket_text,
    "questions": [{
        "name": "queue", "type": "choice", "instructions": RULE,
        "choices": [{"value": k, "description": v}
                    for k, v in LABELS.items()],
    }],
}
规则明确要求把工单当作数据,混合或不清楚时转 review;这不等于已证明能抵抗提示注入。每次只发一条工单。把八条拼成共享输入后只问一个队列,得到的是整包内容的分类,不会自动产生八个答案。后续增加同工单多问题时,也要重新记录 token 用量。
真实调用使用各自官方域名与 Bearer 认证,不假定兼容 OpenAI 的网关一定支持 /v1/decisions,更不能把 OpenAI 请求体直接发送给 TypeSafe。
保留拒答、错误与人工复核的区别
先运行免费离线流程:
python3 migrate.py --provider jev --output jev-fixture
python3 migrate.py --provider openai --output openai-fixture
每个新目录有八份原始 JSON、rows.json 和 summary.json。已有目录会被拒绝复用,避免覆盖证据。OpenAI 的 T05 被刻意设置为拒答样例,仅用于检查程序分支,不是在预测真实模型会拒绝这段文字。
适配器按问题标识匹配答案,检查四个标签是否齐全、概率条目是否重复、数值是否有限且合计接近一,并检查选中标签是否具有最高概率。缺字段、未知类型或非法置信度进入错误记录。
status=ok 且 choice=review 表示有效的人工队列分类;status=refusal 表示模型没有给出该答案;status=error 表示未获得或未通过校验。把后三种情况全部当作分类成功,会掩盖可用性问题。TypeSafe 当前文档没有同样的 refusal 回答类型,不能自行给 Jev 编造该字段;未知类型按错误保留原始响应。
示例阈值为 0.8,不是生产建议。有效合成响应的置信度都设为 0.72,因此默认全部人工处理,自动覆盖率为零,自动部分的正确比例为 null。这里没有分母,不能把 null 写成“准确率为零”。
分别衡量正确性与自动覆盖率
两家接口的置信度不能直接互换。TypeSafe 对 Choice 给出了基于概率分布的计算说明,但同一个小数不代表两家拥有相同校准或风险。详细方法见 Jev 阈值评估。真实评估至少保留四项:有效答案与人工标签的一致率、自动处理占全部提交的比例、自动部分的一致率,以及拒答和错误数量。
同时看各队列混淆矩阵:账单错派技术部门的后果,可能比转人工更严重。提高阈值可以减少自动错误,也会增加人工工作;必须同时报告覆盖率,不能只挑漂亮的正确率。
确认账户、数据用途和费用权限后,安全设置 TYPESAFE_API_KEY 或 OPENAI_API_KEY,再运行:
python3 migrate.py --live --provider jev --output jev-live
python3 migrate.py --live --provider openai --output openai-live
每条命令对附带 CSV 发出八次付费请求。程序保留成功响应中的模型和 usage 等原始字段,不自动重试。认证或参数错误先修复;生产中的限流重试应有退避与次数上限,并记录每次潜在费用。本地样例运行时间不能冒充 API 延迟。
用各自实际用量计算成本
截至核验日,Jev 1.13 官方输入价为每百万 token 0.042 美元,输出免费;GPT-6 Luna 的 Decisions 输入价为每百万 token 0.10 美元,无缓存读写或输出费用,但区域处理溢价和长上下文输入倍率仍适用。这是官方直连基准价,不是 Ofox 报价。Jev 价格、Decisions 计费。
python3 cost.py --jev-tokens 2000000 --openai-tokens 2000000这个等 token 假设算例得到 0.084 美元与 0.20 美元,不是实际账单。同样文本的计费 token 未必相同,应替换成各自 usage,并计入重复指令及全部计费尝试。假设一万条工单、两成人工复核、每条人工成本 0.50 美元,人工部分就是 1000 美元;这些只是演算条件,不能当作客户成本。迁移开发、图片预处理、下游错派和税费也不在脚本里。更多见 Jev 路由成本临界点。
按任务选择,逐步切换流量
纯文本路由可优先评估 Jev 的较低官方输入单价;带图片证据或已有 OpenAI 原生集成的应用,也有理由评估 Decisions。价格和接入便利都不能替代标签质量,公开测试状态也应纳入上线判断。
先影子运行,生产仍走旧路径,在授权样本上保存候选结果。测试前约定能接受的错误、自动覆盖和人工负载,别看完结果再下调标准。按语言与工单类型检查后,只切换少量流量;保留旧配置及分类规则版本。模型版本变化、异常响应增加或人工队列超载时,停止扩量并查看具体记录。工具通过证明的是适配器行为,最终迁移结论仍必须来自真实任务质量与运营成本。
常见问题
- 从 Jev 迁移到 Decisions,改模型名就够了吗?
- 不够。接口地址、输入字段、问题容器和概率结构都不同。应共用分类规则,分别编写请求与响应适配器。
- 这批工单证明哪个模型更准?
- 没有。工具中的响应是人工编写的软件测试样例,没有调用真实模型。选择模型仍需用保留的真实标注工单完成评估。