GPT‑6.1 SolとClaude Sonnet 5.5を比較:コード作業とAPI料金で選ぶ
短い要求の単価が同じSolとSonnet 5.5を、キャッシュ、長い入力、ツール接続、検証条件から比較。実測と文書上の比較を区別します。
 Ofox
GPT‑6.1 SolとClaude Sonnet 5.5は、短いStandard要求の通常入力が100万トークン 2ドル、出力が 10ドルで同じです。しかし安い方は、キャッシュ、入力長、生成量、再試行、ツール移行の負担によって変わります。
2026年9月30日時点の公式仕様、料金、実装条件を比較します。同一課題を両モデルで実行したコード評価ではありません。計算例はトークン数を固定して単価差だけを取り出しています。同じ文章でも提供元によってトークン数は異なり得ます。旧モデルとのメーカー比較も、この2モデルの優劣を示しません。
同じ部分と違う条件
| 判断項目 | GPT‑6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| APIモデル | gpt-6.1-sol | claude-sonnet-5-5 |
| 短い通常入力/出力、USD/100万トークン | 2 / 10 | 2 / 10 |
| キャッシュ読み取り、USD/100万トークン | 0.10 | 0.20 |
| 短いTTLでの書き込み例、USD/100万トークン | 2.50 | 5分キャッシュは2.50 |
| キャッシュ期間 | 現行Sol文書は30分TTL | 1時間の書き込みは100万トークンあたり4.00 USD |
| 長い入力 | 272K超で要求全体の単価上昇 | この世代の対応1M範囲では標準単価 |
| ツール実装 | Responsesの呼び出し・結果項目 | Claudeのtool-use/tool-result |
| 移行負担が小さい出発点 | 検証済みResponsesループがある | 検証済みClaudeループがある |
出典:Sol仕様、OpenAIキャッシュ、Sonnet発表、Anthropic料金。第三者プラットフォームの経路・価格・互換性は別途確認します。
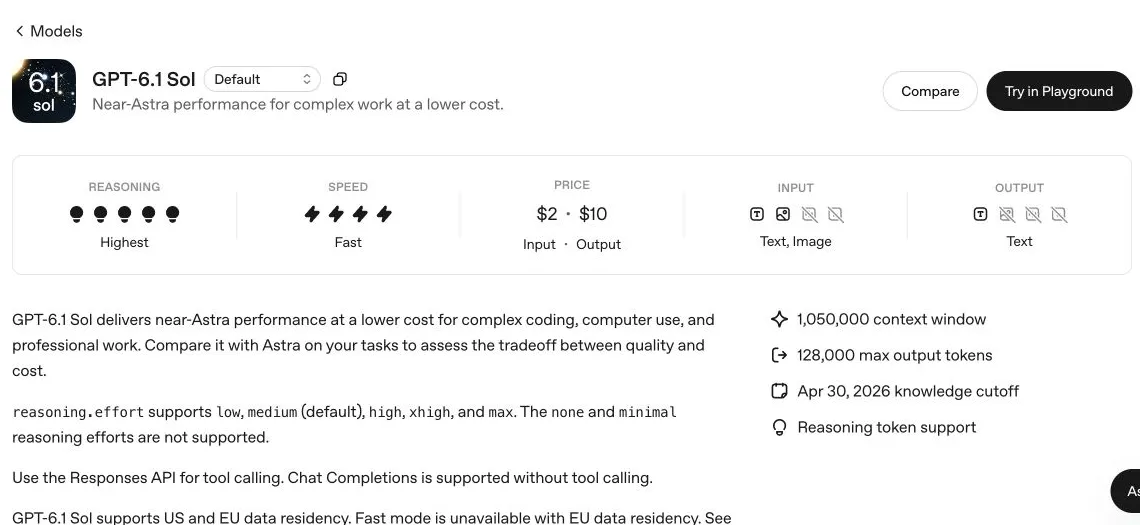
実際のOpenAI文書です。Sonnetの情報はリンクしたAnthropic原文に基づき、この画像は比較実行の結果ではありません。
3種類の処理を同じ数量で計算する
通常入力20,000、出力5,000、キャッシュなしなら両方とも 0.04 + 0.05 = 0.09ドル。基本単価に勝者はいません。片方が再試行や長い推論を要すれば実タスク費用は変わりますが、それは測定する情報であり同単価からは分かりません。
次に通常入力10,000、キャッシュ読み取り100,000、出力5,000。Solは 0.02 + 0.01 + 0.05 = 0.08、Sonnetは 0.02 + 0.02 + 0.05 = 0.09。Solの読み取りは半額でも、要求全体では約11.1%安い計算であり50%ではありません。初回書き込みを除き、両方のヒットを仮定しています。
100Kトークンの共通プレフィックスを1回書き、9回読み、毎回10Kの通常入力と5K出力がある10要求では、Solは1.04ドル、Sonnetの5分書き込み例は1.13ドルです。それぞれの有効期間と一致条件に収まる必要があります。任意の間隔でヒットするわけではなく、Sonnetの1時間書き込みやミスを含めれば変わります。
通常入力300,000、出力10,000なら、Solは長い帯に入り 1.20 + 0.15 = 1.35ドル。Sonnetは対応範囲内の標準単価で 0.60 + 0.10 = 0.70ドルです。長文処理の費用差はありますが、抽出精度が同じとは分かりません。ツール定義や回答余地も各モデルの制限に入れる必要があります。
短いdiff、再利用資料、大きなリポジトリ入力は別の負荷です。ひとつの割引率を全てに適用すると前提を隠してしまいます。
今あるツール構成から候補を選ぶ
正しく動くResponsesの複数ターン実装があれば、Solを先に試すと接続変更を抑えられます。ただし旧Chat Completionsラッパーのままツールを使うことはできません。移行手順でoutput、call_id、有限ループを確認してください。
既にClaudeのネイティブなツール呼び出しで運用しているならSonnetから試す方が変更は少なくなります。提供元を変える際はSchema、イベント、状態、キャッシュを確認します。互換ゲートウェイが翻訳していても、その層自体が試験対象です。テキスト要求だけの成功でツール対応を判断しません。
開発工数は推論代と別に見積もります。少量の呼び出しなら、新プロトコルの検証費用がわずかな読み取り単価差を上回ることがあります。大量処理では逆もあります。自分の処理量と工数を使い、根拠のない時給や移行日数で結論を作らないでください。
タスクと検証方法で選ぶ
| 状況 | 最初の実験 | 導入前に必要な証拠 |
|---|---|---|
| Responsesで小さなバグ修正 | 現行ハーネスでSol | 回帰、ツール結果、レビュー工数 |
| Claudeでコード・文書作成 | 同じ流れでSonnet | コードや出力ファイルの合格、要件漏れなし |
| 大きな非キャッシュ入力 | 長文料金で両方比較 | 根拠、欠落数、全使用量 |
| 参考情報を多く再利用 | 実ヒット率とタスク費用 | 書き込み、読み取り、ミス、出力、再試行 |
| 不可逆な操作 | 先に読み取り専用提案 | 許可と操作の正しさ |
表は統合と料金条件から考えた試験の出発点で、実測の勝敗ではありません。AnthropicはSonnetを範囲の明確な日常作業、修正、文書に位置付け、OpenAIはSolをAstraより低コストの複雑作業に位置付けています。説明は試験項目を選ぶ助けに留めます。
Sonnet発表の速度・タスク費用改善は Sonnet 5との比較です。GPT‑6.1 Solより速いという数値に置き換えられません。「near-Astra」からもSonnetとの勝敗は出ません。異なるツール・推論予算・環境の数値を並べたランキングは、比較可能性を過大に見せるため掲載しません。
再現できる比較の手順
実際に検証する種類の課題を固定します。期待動作がある失敗テスト、小機能、回帰付きリファクタ、出典が必要な文書などです。仮のブランチや合成リポジトリを使い、外部送信前に秘密や顧客情報を除きます。
ファイル範囲、ツール権限、合格条件、停止条件を揃え、モデルID、提供元、クライアント、日時、推論設定、指示、環境を記録します。両社の同名推論レベルは同じ計算量ではないため、名前が同じだけで公平と断言せず設定を明記します。
まず成果物の合否を判定します。コードはテストとdiffで無関係変更、例外処理、危険な動作を確認。文書は必須節、根拠、実際のエクスポートを確認します。その後でトークン、ツール料金、時間、再試行、人手修正を記録します。「完了しました」という文章は成果の証明ではありません。
変動が見えるだけの代表課題を繰り返し、失敗も含め件数を報告します。小規模試験は局所的な導入には役立ちますが、万能な最強モデルの証明にはなりません。ロールバックを残し、モデルやハーネス変更後は再評価します。
どちらか、両方か、まだ決めないか
短い要求が同額で移行利益も未確認なら、検証済みの既存ツールに合う方から始めます。長い非キャッシュ入力はSonnetの料金条件、キャッシュ中心のResponsesではSolの書き込み・ミス込み総額を評価します。モデルの振り分けは失敗を識別でき、運用複雑化以上の利益がある場合に検討します。
合否基準がなければ、モデルを増やしても評価問題は解決しません。まず確認可能な課題を作ります。OpenAI内の難しい仕事の選択は Sol対Astra、課金条件は料金ガイドを参照してください。Ofoxの接続・価格・互換性は別確認であり、本比較はその保証ではありません。