GPT‑6.1 SolとGPT‑6 Astra:高いモデルを選ぶべき仕事は?
SolとAstraの仕様、キャッシュ、長い入力の費用を比較。失敗時の切り替え計算と、コード・調査・文書の検証条件を整理します。
 Ofox
GPT‑6.1 SolのStandardの通常入力・出力単価は、GPT‑6 Astraの5分の1です。繰り返す作業の候補にする理由になりますが、検証に合格したタスクが必ず80%安くなるわけではありません。回答量、失敗試行、ツール、人のレビューが最終費用を変えます。
OpenAIはSolをAstraに近い複雑作業を低価格で扱うモデルと説明し、Astraは最も難しい仕事向けに位置付けています。本稿は2026年9月30日の仕様と仮定を明示した計算例から選択方法を考えます。両モデルを同じ課題で実行した比較テスト、同品質の証明、全タスクの置き換え推奨ではありません。
同じ仕様でも品質が等しいとは限らない
| 文書上の項目 | GPT‑6.1 Sol | GPT‑6 Astra |
|---|---|---|
| API ID | gpt-6.1-sol | gpt-6-astra |
| 入力/出力 | テキスト・画像 / テキスト | テキスト・画像 / テキスト |
| 総コンテキスト | 1,050,000トークン | 1,050,000トークン |
| 最大入力 | 922,000トークン | 922,000トークン |
| 最大出力 | 128,000トークン | 128,000トークン |
| 知識のカットオフ | 2026年4月30日 | 2026年4月30日 |
| API推論設定 | low, medium, high, xhigh, max | low, medium, high, xhigh, max |
| Standardの短い入力での通常入力/出力、USD/100万トークン | 2 / 10 | 10 / 50 |
| 同条件のキャッシュ読み取り/書き込み、USD/100万トークン | 0.10 / 2.50 | 1 / 12.50 |
同じ容量でも難しい入力を同じように扱えるとは限りません。大きなコンテキストウィンドウでも、全制約や引用、依存関係の正しい保持を保証しません。同名の推論設定も時間、計算量、出力品質の同一性を示しません。表を性能評価の代用にせず、成果物を検証します。
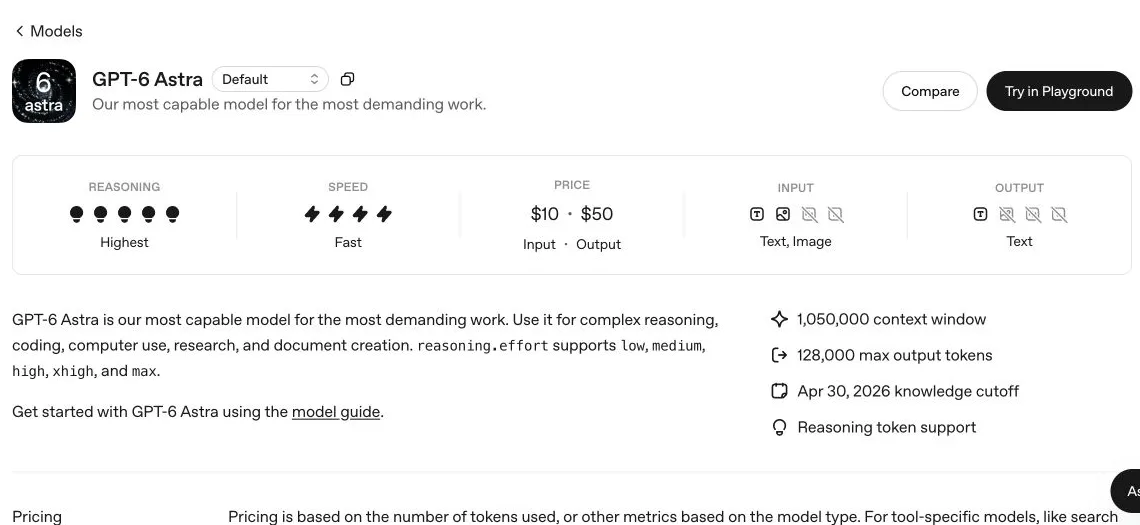
実際の英語文書の画面です。公開情報を示すもので、比較を実行した画面ではありません。
3つの費用差
通常入力10,000、出力2,000ならSolは 0.02 + 0.02 = 0.04ドル、Astraは 0.10 + 0.10 = 0.20ドル。短いStandard APIでツール、キャッシュ、地域費なしという条件では5倍です。
通常入力10,000、読み取り100,000、出力2,000ならSolは 0.02 + 0.01 + 0.02 = 0.05、Astraは 0.10 + 0.10 + 0.10 = 0.30。今度は6倍になります。読み取りは10倍差、他の項目は5倍差だからです。初回書き込みとミスを含まない読み取り要求の例なので、実際の一連のリクエストを計算するときは加算します。
通常入力300,000、出力10,000ではSolが1.35ドル、Astraが6.75ドル。両方とも272K超のため、要求全体で入力・キャッシュを2倍、出力を1.5倍にします。短い単価や超過部分だけの加算では誤りです。
同じ数量による単価比較であり、必要トークン量の予測ではありません。ターンや推論、手直しが増えれば比率も変わります。料金ガイドで要求台帳を作り、合格結果あたりの費用と区別してください。
避けたい失敗から考える
明確なテストがある局所的コード修正ならSolを先に評価しやすくなります。合否を判断できる基準があり、試行回数を制限し、誤りを公開前に止められるためです。環境を揃え、モデル変更を理由に権限を広げないでください。
複数モジュールの設計、難しい原因調査、長い研究の統合など、制約が絡む仕事ではAstraを直接評価する価値があります。これは公式位置付けと見逃しの代償に基づく候補選びであり、必ず成功するという測定結果ではありません。強い位置付けのモデルでも、出力を確認可能な単位に分けます。
文書なら納品ファイルと根拠を見ます。美しい回答でも節の欠落、出典との矛盾、数字の捏造があり得ます。容易に検出できるなら安い初稿を試せますが、専門家が必要ならその費用も含めます。
| 状況 | 候補戦略 | 必要な検証 |
|---|---|---|
| Schemaと出典確認がある反復抽出 | 先にSol | 構造と原文の正確さ |
| 回帰試験付き小修正 | 先にSol | テストと変更範囲 |
| 曖昧で手戻りの高い設計 | 両者を直接比較 | 制約、専門家の合否、修正回数 |
| 引用付き長文調査 | 同じ資料で比較 | 根拠、矛盾、欠落 |
| 重要な書き込み・公開 | 提案と実行制御を分離 | 対応する許可・承認 |
これは実験方針であって本稿の性能結果ではありません。どのモデルでも検証、権限、ロールバックが必要です。
SolからAstraへ切り替える予算
Solの1試行をCs、AstraをCa、信頼できる検証後に切り替える割合をpとします。各段階1回だけの単純化では:
依頼したタスク1件あたりのトークン費用の期待値 = Cs + p × Ca
最初からAstraより安い条件 = p < 1 − Cs / Ca
0.04と0.20を入れると p < 0.80。仮に25%を切り替えるなら 0.04 + 0.25 × 0.20 = 0.09ドル、全件Astra1回では0.20です。25%は仮定であり観測値ではなく、55%の削減を達成したという意味でもありません。
前提が崩れる場合があります。失敗履歴を追加したAstraはCaより高くなるかもしれず、合否の判定ロジックはSolの誤りを見逃すかもしれません。Astraも失敗し、人や再試行が必要になります。式はツール、時間、レビューを含まず、依頼したタスク数と合格したタスク数も同じではありません。結果なしで「成功あたり費用」と呼ばないでください。
実際には初回費用、切り替え理由、2回目費用、最終合否、人手修正を記録します。低い切り替え率が、検出の弱さを表すこともあります。合格扱いの結果も抜き取り検査し、明示的失敗だけでなく見逃しを追います。
モデルの振り分けの前に合格基準を作る
コードでは合成リポジトリや仮ブランチを固定し、期待動作をテストで定義します。ファイル、指示、ツールを揃え、モデル、推論設定、クライアント、日付、環境を保存します。最初の比較と無関係なハーネス変更を混ぜないでください。
patch、必要なテスト、無関係変更なし、diffに沿う説明を要求します。全経過時間、出力用量、ツール、人のレビューも測ります。調査では必須主張、必要資料、矛盾チェックを、文書ではチャット要約でなく実ファイルを検証します。
切り替え条件は先に決めます。必要証拠の欠落、回帰失敗、ツールエラーの反復、未解決の制約衝突などです。「弱そう」という感覚だけで自動モデルの振り分けしないでください。Astraには原タスク、信頼できる資料、確認済みの失敗要約を渡し、Solの未確認主張を事実にしません。
再試行上限と「要確認」の終端を用意します。上位への切り替えは無限実行の許可ではありません。評価記録を消さず、元設定に戻せるようにします。
接続の誤りを性能差と混同しない
SolツールはResponsesが必要です。壊れたChat Completions接続を能力不足として記録しないよう、移行例を先に確認します。
履歴量が違えば片方だけ長い帯に入る場合もあります。実際の入力とキャッシュ状態を記録してください。一方だけ整理済み資料を与え、他方に検索させたなら、その費用差全部をモデルに帰せません。
API料金からCodex契約に含まれるタスク数も求められません。Codex設定ガイドで違いを確認し、品質・時間・総費用を満たす検証済みの流れを選んでください。