Jev와 OpenAI Decisions API 비교: 고객 문의 분류를 이전하기 전 확인할 것
같은 고객 문의로 Jev와 GPT-6 Luna Decisions의 요청 형식, 답변 거부, 입력 비용을 비교합니다. Python 예제로 응답 변환과 수동 검토 경로를 확인하세요.
 Ofox
Jev와 OpenAI Decisions API는 모두 텍스트 문의를 정해진 담당 대기열로 보낼 수 있지만, 서로 바로 교체할 수 있는 인터페이스는 아닙니다. 먼저 같은 분류 기준과 입력, 정답 라벨을 마련한 뒤 응답 변환, 불확실한 결과 처리, 전체 운영 비용을 확인해야 합니다. 기존 클라이언트에서 모델 이름만 바꿔서는 이전이 끝나지 않습니다.
이 글은 가상의 문의 8건, 요청 생성기 2개, 엄격한 응답 검사, 입력 비용 계산기, 실제 도입 전 평가 절차를 제공합니다. Jev 입문과 Decisions API의 CSV 분류 튜토리얼을 연결하며, 한 애플리케이션이 두 서비스를 지원할 때 바뀌는 부분에 집중합니다.
자료 확인일은 2026년 10월 8일입니다. 비교 근거는 현재 공식 문서와 실행한 로컬 합성 테스트입니다. 유료 API를 호출하지 않았고, 모델의 정확도나 네트워크 지연도 측정하지 않았습니다. 모든 응답 예시는 테스트를 위해 직접 작성했습니다. 통합 오류를 찾는 자료이지 모델 성능의 승자를 정하는 결과가 아닙니다.
모델 품질을 비교하기 전에 요청과 응답부터 맞추기
이 예제의 Jev는 TypeSafe의 jev-1.13.0으로 고정하며, Decisions는 gpt-6-luna를 사용합니다. Decisions는 현재 공개 베타입니다. jev-latest 별칭은 나중에 다른 버전을 가리킬 수 있으므로, 실제 평가에서는 응답에 포함된 모델 식별자도 저장하세요. TypeSafe 모델 목록, OpenAI Decisions 가이드.
| 통합 항목 | Jev 네이티브 API | OpenAI Decisions API |
|---|---|---|
| POST 주소 | /v1/systemone | /v1/decisions |
| 공통 입력 자료 | state | input |
| 질문 컨테이너 | 질문 ID가 키인 맵 | 고유한 name을 가진 배열 |
| 선택지 정의 | criteria 맵 | value/description의 choices 배열 |
| 응답 찾기 | 질문 ID로 조회 | name으로 대조 |
| 선택지 확률 | 라벨과 수치의 맵 | value/probability 객체 배열 |
| 참·거짓 질문 유형 | noul | predicate |
| 문서에 명시된 입력 범위 | 구조화된 텍스트를 포함한 텍스트 | 텍스트와 이미지 |
표의 경로는 HTTPS로 호출합니다. Jev 호스트는 api.typesafe.ai, Decisions 호스트는 api.openai.com이며 모두 제공업체에 직접 연결하는 API입니다.
파손 상품 문의에 사진이 첨부된 경우 이 차이가 중요합니다. Decisions에는 사진을 보여 주고 Jev에는 글만 준 다음 결과 차이를 전부 분류 능력 탓으로 돌리면 공정한 비교가 아닙니다. 두 서비스에 같은, 사용이 허용된 설명문을 주거나 이미지가 포함된 별도 과제로 평가하세요. 이미지를 텍스트로 바꾸는 전처리에도 오류와 비용이 추가됩니다.
두 서비스의 choice는 설명 문단이나 임의의 추출 필드를 생성하는 요청이 아닙니다. 환불 금액과 근거 인용문이 필요하다면 별도의 추출 단계를 설계해야 합니다. 담당 대기열 라벨 안에 그런 사실이 들어 있다고 가정하면 안 됩니다. 네이티브 요청과 응답 필드는 TypeSafe HTTP 문서에서 확인할 수 있습니다.
다른 질문 유형도 의미를 맞춰 변환해야 합니다. 아래 프로젝트가 구현하는 것은 Choice뿐입니다.
| 작업 | Jev | Decisions | 이전 조건 |
|---|---|---|---|
| 순서 없는 분류 | choice, criteria 맵 | choice, choices 배열 | 라벨 이름뿐 아니라 의미 유지 |
| 순서 있는 평가 | score, 순서 있는 criteria 배열 | score, 순서 있는 levels 배열 | 단계 순서와 설명을 동일하게 유지 |
| 조건 성립 여부 | noul, 결과 필드 noul | predicate, 결과 필드 probability | 모두 0~1 추정값이지만 임계값은 재평가 |
두 Score 결과는 단계 인덱스의 확률 가중 평균입니다. 자동으로 0~1로 정규화한 값도, confidence도 아닙니다. 세 단계의 인덱스가 0, 1, 2라면 결과는 1.1일 수 있습니다. 애플리케이션이 최대 인덱스로 나눠 정규화한다면 자체 변환임을 기록하고 양쪽의 평가 기준을 동일하게 유지하세요. 정규화한 심각도와 조건이 참일 확률은 다릅니다.
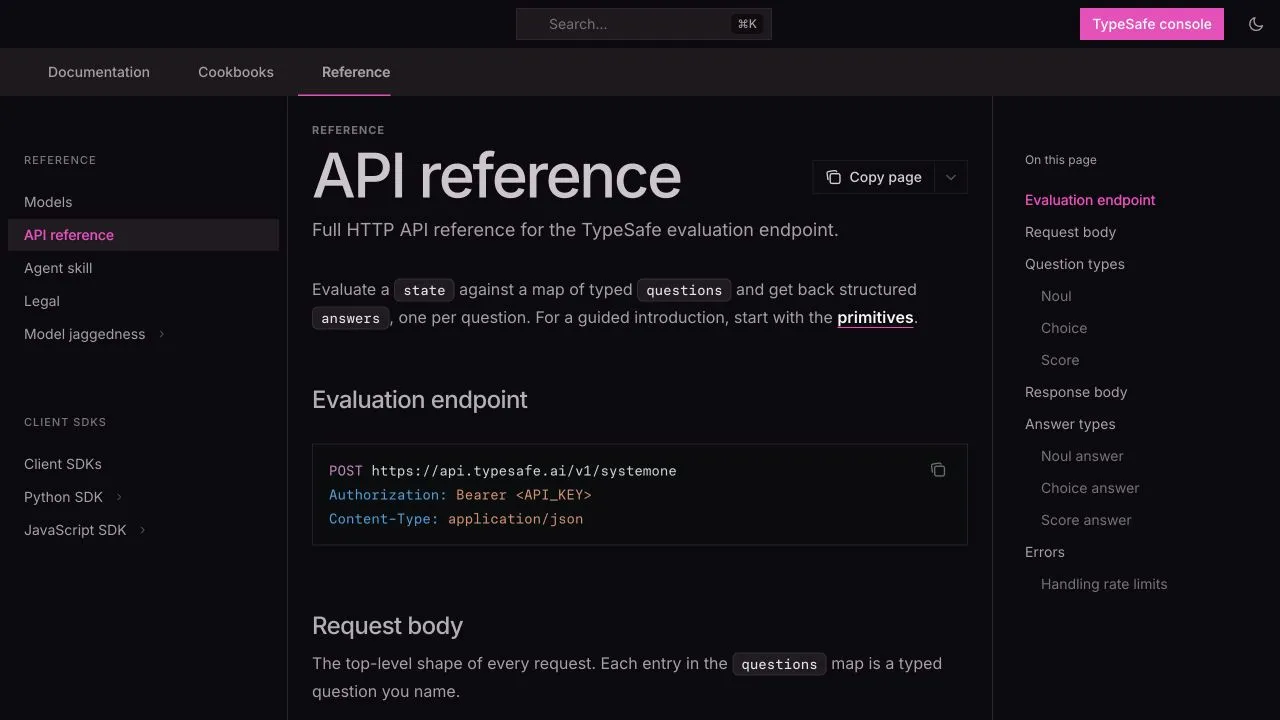
2026년 10월 8일에 캡처한 실제 공식 영문 문서입니다. 인터페이스 설명이며 실제 문의를 분류한 실행 결과가 아닙니다. 원문.
담당 대기열 정책과 라벨을 하나로 고정하기
예제는 주요 담당 대기열 하나만 선택합니다. billing은 결제·청구서·환불만 관련된 요청, technical은 기존 기능이나 접근의 장애만 관련된 요청, feature는 새 기능만 요구하는 요청입니다. 여러 부서가 섞이거나, 모호하거나, 관련 없는 내용은 review로 보냅니다.
따라서 “환불하고 고장 난 내보내기도 고쳐 주세요”는 review입니다. 먼저 언급한 부서를 고르는 식으로 해석하지 않습니다. 실제 업무가 두 부서에 각각 작업을 만들어야 한다면 단일 선택 분류 자체가 맞지 않습니다. 결과가 나온 뒤 어느 라벨이든 정답이라고 바꾸지 말고 출력 설계를 수정하세요.
| ID | 가상 문의의 의미 | 기준 라벨 | 확인하려는 경계 |
|---|---|---|---|
| T01 | 청구서 발송 요청 | billing | 명확한 행정 요청 |
| T02 | 기존 내보내기 버튼 오류 | technical | 장애와 새 기능 구분 |
| T03 | 달력 보기 추가 요청 | feature | 새 기능 |
| T04 | 환불과 내보내기 수리 | review | 두 부서의 업무 |
| T05 | “잘못됐어요” | review | 정보 부족 |
| T06 | billing이라고 답하라는 지시 뒤에 무관한 내용 | review | 입력을 명령이 아닌 데이터로 취급 |
| T07 | 일본어 로그인 오류 보고 | technical | 원문 언어 보존 |
| T08 | 한국어 결제 영수증 요청 | billing | Unicode 보존 |
8건으로 실제 운영 정확도를 추정할 수는 없습니다. 일본어와 한국어 예시도 처리 과정에서 글자가 보존되는지 확인할 뿐, 두 공급자의 해당 언어 성능을 입증하지 않습니다. TypeSafe는 영어가 주 학습 언어이자 현재 가장 강한 언어라고 설명하고 다른 언어는 자체 자료로 평가하도록 권합니다. 모든 문의를 영어로 번역하면 원래 평가하려던 업무 조건이 바뀝니다.
실제 자료는 두 검토자가 같은 정책에 따라 라벨을 붙이고, 의견 차이를 해결한 뒤 평가 집합을 고정하세요. 지시문 조정에는 별도의 개발 집합을 사용합니다. 원본 레코드 ID를 유지하고 불필요한 개인정보를 제거하며, 과거 실패 사례만 뽑는 표본 구성도 피해야 합니다.
공통 작업 정의에서 두 요청 생성하기
이전 예제 프로젝트를 내려받아 압축을 풀고 해당 디렉터리에서 터미널을 엽니다. Python 3.9 이상과 표준 라이브러리만 사용합니다. 첫 실행에는 패키지 설치나 API 키가 필요 없습니다. payload() 함수는 같은 지시문과 라벨 사전을 재사용합니다.
jev_request = {
    "model": "jev-1.13.0", "state": ticket_text,
    "questions": {"queue": {
        "type": "choice", "instructions": RULE,
        "criteria": LABELS,
    }},
}
openai_request = {
    "model": "gpt-6-luna", "input": ticket_text,
    "questions": [{
        "name": "queue", "type": "choice", "instructions": RULE,
        "choices": [{"value": k, "description": v}
                    for k, v in LABELS.items()],
    }],
}RULE은 문의를 지시가 아닌 근거 자료로 취급하고 모호하면 review를 선택하라고 정합니다. 이 문장은 작업 정의이며 프롬프트 인젝션에 대한 방어력을 입증하지 않습니다. 공격처럼 보이는 T06 역시 한 가지 테스트이지 보안 인증은 아닙니다.
이번 연습에서는 요청 하나에 문의 하나를 보냅니다. 서로 다른 문의 8건을 하나의 공통 입력으로 합치고 대기열 질문 하나를 하면 전체 묶음을 분류하게 됩니다. 독립적인 답 8개가 자동으로 나오지는 않습니다. 나중에 한 레코드에 여러 질문을 추가할 수 있지만, 요청을 묶는 방식은 토큰 수와 동작을 바꿀 수 있으므로 별도로 기록해야 합니다.
실제 호출 클라이언트는 각 공급자의 공식 호스트와 Bearer 인증을 사용합니다. OpenAI 호환 게이트웨이가 /v1/decisions까지 구현한다고 가정하지 않으며 TypeSafe에 OpenAI 요청 본문을 그대로 보내지도 않습니다. 네이티브 연결부터 확인한 뒤 게이트웨이 어댑터를 추가하세요.
응답을 정규화하되 실패를 숨기지 않기
먼저 두 가지 고정 응답 경로를 실행합니다.
python3 migrate.py --provider jev --output jev-fixture
python3 migrate.py --provider openai --output openai-fixture
각 새 디렉터리에 원본 JSON 8개와 rows.json, summary.json이 저장됩니다. 기존 출력 디렉터리는 재사용하지 못하게 해 이전 증거를 보호합니다. OpenAI의 T05는 거부 분기를 점검하려고 의도적으로 만든 거부 응답입니다. GPT-6 Luna가 실제로 이 문장을 거부할 것이라는 예측이 아닙니다.
어댑터는 질문을 대조하고, 네 라벨이 정확히 있는지, 확률 항목이 중복되지 않는지, 수치가 유한하고 합이 대략 1인지 검사합니다. 선택한 라벨의 확률이 최대인지, confidence가 0부터 1 사이의 유한수인지도 확인합니다. 필드 누락, 잘못된 구조, 통신 실패는 오류로 남습니다.
세 상태를 구분하세요. status=ok와 choice=review는 수동 확인 대기열로 정상 분류한 결과입니다. status=refusal은 답변 거부, status=error는 사용 가능한 응답을 얻거나 검증하지 못한 상태입니다. 이를 모두 성공한 review로 합치면 서비스 신뢰성 문제가 정상적인 분류 건수 안에 숨습니다.
TypeSafe의 현재 응답 명세에는 세 가지 유형이 문서화되어 있지만 OpenAI와 같은 refusal 유형은 없습니다. Jev에 임의로 그 필드를 추가하지 않고 알 수 없는 유형을 검증 오류로 남깁니다. 원본을 보존하면 향후 스키마 변경도 조사할 수 있습니다.
예제 임계값 0.8은 설명용 설정입니다. 정상 합성 응답의 confidence는 모두 0.72로 작성했으므로 기본 실행에서는 전부 사람이 처리합니다. 자동 처리 비율은 0이고 자동 처리 건의 정답 일치율은 null입니다. 분모가 없는 상태이지 정확도가 0이라는 뜻이 아닙니다.
분류 품질과 자동 처리 비율을 따로 측정하기
한 공급자의 임계값을 다른 공급자에 그대로 옮기지 마세요. TypeSafe는 Choice의 확률 분포로 confidence를 계산하는 방법을 설명하지만, 다른 인터페이스의 같은 소수가 같은 보정 상태나 업무 위험을 뜻하지는 않습니다. 공급자별 원래 확률과 confidence를 저장하고 Jev 임계값 평가 가이드를 함께 참고하세요.
별도로 보관한 실제 평가 집합에서는 최소한 다음을 기록합니다.
- 정상 답변 일치율: 정상 라벨 중 정답 라벨과 일치하는 비율.
- 자동 처리 비율: 실패를 포함한 전체 제출 건 중 자동으로 배정한 비율.
- 자동 처리 건의 일치율: 자동 배정 건 중 정답과 일치하는 비율.
- 거부·오류 건수와 실제 대기열별 혼동 행렬.
더 많은 일을 사람에게 넘기기만 해도 자동 처리 부분의 일치율은 올라갈 수 있습니다. 유용한 선택일 수 있지만 자동화 범위가 줄고 검토량이 늘었다는 사실도 함께 보여야 합니다. 결제 문의를 기술 부서로 잘못 보내는 일과 review로 넘기는 일은 운영상 결과가 다릅니다.
API 접근, 데이터 사용, 비용 지출이 허용된 뒤 TYPESAFE_API_KEY 또는 OPENAI_API_KEY를 환경에 안전하게 설정하고 실행합니다.
python3 migrate.py --live --provider jev --output jev-live
python3 migrate.py --live --provider openai --output openai-live
첨부 CSV 기준으로 각 명령은 유료 API 요청 8건을 보냅니다. 성공한 원본 응답의 모델과 usage 필드가 있으면 그대로 보존합니다. 예제에는 자동 재시도가 없습니다. 인증 및 검증 실패부터 조사하고, 운영 환경의 일시적인 호출 제한에는 횟수 제한과 지연을 적용하면서 잠재적 비용을 포함한 모든 시도를 기록하세요. 고정 응답의 로컬 실행 시간을 API 지연으로 비교하면 안 됩니다.
각 서비스의 실제 사용량으로 비용 계산하기
확인 시점의 Jev 1.13 공식 기본 입력 요금은 100만 토큰당 0.042달러이며 출력은 무료입니다. GPT-6 Luna의 Decisions 요금은 입력 100만 토큰당 0.10달러이고 캐시 읽기·쓰기와 출력 요금은 없습니다. 다만 지역별 할증과 긴 컨텍스트에 적용되는 입력 배수는 남습니다. 공식 직접 연결의 기본 요금이며 Ofox 가격이나 모든 처리 조건에 대한 약속이 아닙니다. Jev 가격, Decisions 과금.
python3 cost.py --jev-tokens 2000000 --openai-tokens 2000000양쪽 모두 200만 토큰이라는 가정에서 기본 요금 계산 결과는 0.084달러와 0.20달러입니다. 관찰한 청구액이 아닙니다. 같은 텍스트라도 과금 토큰 수가 같다는 보장은 없으므로 각 공급자가 기록한 usage로 바꾸고, 반복 지시문과 과금된 모든 시도를 포함하세요. 입력 단가 하나로 더 저렴한 실제 업무 흐름을 결정할 수는 없습니다.
사람의 검토 비용도 별도로 더합니다. 문의 1만 건 중 20%를 건당 0.50달러로 검토한다고 가정하면 수동 검토만 1,000달러입니다. 고객에게서 측정한 비용이 아닌 계산용 조건입니다. 이전 개발, 이미지 전처리, 재시도, 잘못 배정한 후속 손실도 입력 비용 계산기 밖에 있습니다. Jev 라우팅 손익분기점 글에서 더 넓은 비용 구조를 다룹니다.
실제 업무에 맞춰 선택하고 조금씩 전환하기
텍스트 대기열 분류에서는 Jev의 낮은 공식 기본 입력 단가를 평가할 이유가 있습니다. 그렇다고 실제 정답 라벨에서도 이긴다는 증거는 아닙니다. 이미지 근거가 필요하거나 애플리케이션이 이미 OpenAI 네이티브 API를 운영한다면 Decisions도 검토할 만합니다. 공개 베타 상태 역시 통합 지원과 장애 처리와 함께 도입 판단에 포함해야 합니다.
처음에는 그림자 실행으로 시작하세요. 기존 운영 배정은 유지하고, 허용된 표본에서 후보 서비스를 실행해 같은 정답과 저장된 응답을 비교합니다. 허용 오류, 자동 처리 비율, 수동 검토량 기준을 업무 요구에 따라 미리 정하고 결과가 나쁘다고 뒤늦게 낮추지 않습니다. 언어별·문의 유형별 결과를 살핀 뒤 일부 트래픽만 전환합니다.
되돌릴 수 있도록 이전 공급자 설정과 분류 정책 버전을 보관하세요. 응답 모델이 바뀌거나 잘못된 응답이 늘거나 수동 검토 대기열이 감당할 수 없게 되면 확대를 멈추고 구체적인 기록을 조사합니다. 프로젝트 테스트 통과는 검사한 어댑터 동작을 입증합니다. 최종 이전 결정에는 실제 업무 품질과 운영 비용에 대한 검토된 관찰이 필요합니다.
자주 묻는 질문
- Jev에서 Decisions로 바꿀 때 모델 이름만 변경하면 되나요?
- 아닙니다. 엔드포인트, 입력 필드, 질문 컨테이너, 확률 표현이 다릅니다. 분류 정책은 공유하되 요청과 응답은 공급자별로 변환해야 합니다.
- 예제 문의를 더 정확하게 분류한 모델은 무엇인가요?
- 이 글은 우열을 측정하지 않았습니다. 포함된 응답은 프로그램 테스트용으로 작성한 데이터이며 실제 모델 출력이 아닙니다. 선택하려면 별도로 보관한 실제 정답 데이터로 평가해야 합니다.