Озвучка видео на трёх языках через Gemini TTS: от текста до MP4
Создайте английскую, японскую и корейскую озвучку демо через Ofox Gemini TTS. Реальные WAV, замеры фраз, отдельные таймлайны, три MP4 и код для воспроизведения.
 Ofox
Чтобы превратить одно продуктовое демо в версии с английской, японской и корейской озвучкой, сначала локализуйте текст, затем отдельно сгенерируйте речь и пересоберите таймлайн по измеренной длительности файлов. Перевод субтитров не меняет голос. Даже похожая длина предложений не гарантирует, что новая реплика поместится в исходную сцену.
9 октября 2026 года мы вызвали google/gemini-3.8-flash-tts через Ofox с голосом Kore и получили пять японских и пять корейских WAV. Английская версия использует пять реальных записей из предыдущего руководства по добавлению озвучки. Здесь добавлены отдельные таймлайны и три готовых видео. Это практический процесс локализации, а не рейтинг языков или сервисов синтеза речи.
Скачать проект целиком или посмотреть английский MP4, японский MP4 и корейский MP4. Сборка из сохранённых материалов не обращается к API.
1. Определите границы локализации
Исходник — 30-секундное демо из скриншотов, уже использованное в серии о продуктовых видео с Opus. Интерфейс снят 30 сентября на английском языке. В этом запуске мы не создавали новое видео с помощью Opus: Gemini генерировал речь, а Python и FFmpeg размещали её поверх существующих кадров.
Отсюда следует точное описание результата: три языковые версии озвучки, а не полностью локализованный интерфейс. Скриншоты и английские титульные карточки остаются общими. Новых субтитров, перевода UI, клонирования голоса или синхронизации губ нет. Если для кампании нужен экранный текст на местном языке, потребуется дополнительный монтаж с реальными локализованными экранами, когда они доступны. Подмена надписей внутри скриншота не доказывает поддержку языка продуктом.
До генерации выясните ограничение площадки по длительности. Для страницы с руководством 34 секунды могут подойти, а для рекламного размещения с жёстким пределом в 30 секунд — нет. Здесь мы разрешаем ролику стать длиннее, чтобы сохранить реплики полностью. Для фиксированного хронометража нужно сократить перевод и получить новый дубль, а не незаметно обрезать последние слова.
Содержание во всех языках остаётся стабильным: понятная задача, каталог моделей, поиск документации, пример API-справочника и финальная проверка. Мы не озвучиваем цены, число моделей и акции, заметные на старых экранах. Дата съёмки не подтверждает актуальность этих условий сегодня.
2. Локализуйте пять реплик по сценам
Отдельные файлы упрощают исправления. Если проблема возникла в произношении фразы об API, достаточно заменить её, не генерируя заново всю дорожку. Для проверки это тоже удобнее: смысл, тон и показанное действие можно сопоставлять по одному предложению.
Английское начало — “A clear product video starts with a clear brief.” Японский вариант: わかりやすい製品動画は、目的を明確にすることから始まります。 Корейский: 이해하기 쉬운 제품 영상은 명확한 기획에서 시작됩니다. Важно сохранить смысл инструкции, а не соответствие каждого отдельного слова.
В четвёртой японской реплике API-справочник остаётся примером: この API リファレンスのように、各シーンに対応する実際のページを示します。 Корейская версия использует термин API 참조 문서 и поясняет, что зритель видит в кадре. Ни один перевод не добавляет возможностей API, которых не было в исходном тексте.
В narration-drafts.json из архива сохранены все пятнадцать предложений. Название обозначает редактируемый исходник, а не отсутствие проверки: японский и корейский текст прошли независимую языковую AI-рецензию до генерации. Это не запись с носителем языка и не человеческая оценка на слух. Корректное написание «API» само по себе не подтверждает произношение в готовом WAV.
Для своего продукта заранее составьте список названий, сокращений, UI-меток и слов, которые надо оставить на английском. Сначала проверяйте текст, затем отдельно звук. Сохраняйте утверждённую реплику рядом с соответствующим файлом, чтобы после редактирования текста старую запись не приняли за результат новой генерации.
3. Явно задайте язык и формат
Точный ID и пример запроса к шлюзу берите с текущей страницы Gemini TTS. Во всех запросах использованы Kore, WAV и speed: 1.0. Языковые коды различаются: en-US, ja-JP, ko-KR.
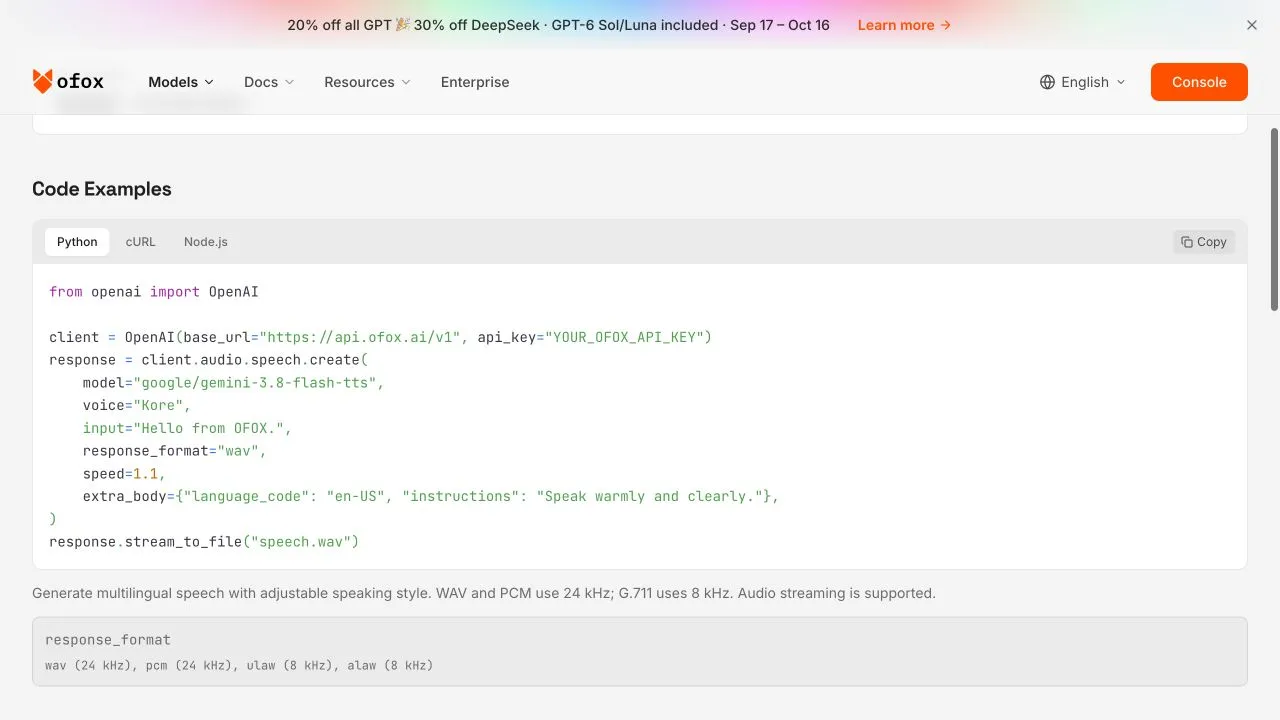
Скриншот реальной страницы от 9 октября. Интерфейс показан на английском языке. В её примере указана скорость 1.1, тогда как сохранённые запросы этого проекта используют 1.0. Скриншот показывает способ подключения; успешные вызовы подтверждаются ответами и аудиофайлами.
Ниже минимальный японский запрос. Для корейского замените и утверждённый текст, и код на ko-KR: не оставляйте японский код в скопированном примере.
import os
from pathlib import Path
import requests

payload = {
    "model": "google/gemini-3.8-flash-tts",
    "voice": "Kore",
    "input": "次に、ドキュメントがどこにあるかを案内します。",
    "language_code": "ja-JP",
    "speed": 1.0,
    "response_format": "wav",
}
r = requests.post(
    "https://api.ofox.ai/v1/audio/speech",
    headers={"Authorization": "Bearer " + os.environ["OFOX_API_KEY"]},
    json=payload,
    timeout=(15, 120),
)
r.raise_for_status()
if not r.headers.get("content-type", "").startswith("audio/"):
    raise RuntimeError("Expected audio; inspect the response")
Path("ja-line-3.wav").write_bytes(r.content)
Ключ передаётся через переменную окружения, а не через клиентский код браузера или общий файл проекта. Полный клиент из первого руководства проверяет наличие инструментов для обработки медиа, сохраняет безопасные метаданные ответа и не повторяет платные POST автоматически. Тайм-аут означает неопределённость, а не доказательство отсутствия работы на сервере. Перед повторной отправкой проверьте статус и учёт использования.
Все десять новых запросов вернули HTTP 200. Получены монофонические WAV с 16-битным PCM и частотой 24 кГц; полное декодирование прошло успешно. Это результат конкретных входных данных и даты запуска, а не гарантия идентичного вывода в будущем. Храните параметры, время генерации и хеш вместе. Другой голос или повторный запуск могут дать иной хронометраж.
4. Измерьте звук до изменения монтажа
В таблице указана длительность целого WAV, включая возможную тишину, а не границы слов. Проверяйте файл через ffprobe, а не оценивайте время по числу символов.
ffprobe -v error -show_entries stream=codec_name,sample_rate,channels \
-show_entries format=duration -of json ja/line-1.wav| Сцена | Английский WAV | Японский WAV | Корейский WAV | Исходная сцена |
|---|---|---|---|---|
| Постановка задачи | 3,56 с | 5,32 с | 4,68 с | 4 с |
| Каталог моделей | 4,64 с | 4,80 с | 4,72 с | 7 с |
| Документация | 3,44 с | 3,80 с | 4,28 с | 7 с |
| API-справочник | 4,96 с | 6,12 с | 6,76 с | 7 с |
| Финальное напоминание | 5,44 с | 5,48 с | 5,64 с | 5 с |
Уже первая сцена показывает, почему нельзя механически перенести английские метки. Японская запись сама длится 5,32 секунды при четырёхсекундной сцене, ещё до добавления времени на чтение карточки. Корейская реплика об API тоже требует больше места с учётом вступительного и завершающего интервалов.
Из пяти примеров нельзя заключить, что японская речь всегда медленнее или корейской всегда требуется больше места. Влияют формулировка, пунктуация, голос и вариативность вывода. Практический вывод ограничивается следующим: измеряйте каждый дубль и явно решайте, как изменить сопровождающую его сцену.
5. Постройте отдельный таймлайн для каждого языка
Исходные границы сцен — 0, 4, 11, 18, 25 и 30 секунд. Скрипт сохраняет их порядок, но вычисляет новую длительность каждой. Перед речью остаётся 0,35 секунды, после конца WAV — не менее 0,65 секунды. При нехватке времени удерживается последний кадр соответствующей сцены. Голос не ускоряется и не обрезается.
Для видео с частотой 30 кадров в секунду правило выглядит так:
scene_frames = ceil(max(original_scene_seconds, wav_seconds + 1.0) * 30)
scene_seconds = scene_frames / 30
speech_start = cumulative_scene_seconds + 0.35
Округление вверх до целого кадра объясняет небольшое отличие от простого сложения десятичных длительностей. Английский экспорт занимает около 32,03 секунды, японский — 33,97, корейский — 34,13. Английский файл здесь намеренно не совпадает побайтово с 32-секундным результатом первого руководства: в этой статье одна посценовая формула применяется ко всем трём языкам.
Установите Python 3, FFmpeg и ffprobe. Распакуйте проект и выполните команды из его каталога:
python3 assemble_localized.py en source.mp4 rebuilt-en
python3 assemble_localized.py ja source.mp4 rebuilt-ja
python3 assemble_localized.py ko source.mp4 rebuilt-ko
В каждой выходной папке появятся narrated.mp4, narration.wav, timing.json и probe.json. Отчёт фиксирует старый интервал исходника, новую длину сцены, добавленное удержание кадра, начало и конец речи, хеш WAV. Используйте новые каталоги, чтобы случайно не перезаписать предыдущую версию.
Такой подход подходит скриншотному демо: короткая задержка оставляет нужную страницу в кадре. Но он не универсален для говорящего человека, движения курсора или динамичного действия. В этих случаях нужную часть визуального ряда следует перемонтировать или создать заново. Удержание кадра сохраняет изображение, но не синхронизирует губы с другой речью.
6. Разделите проверку файла и проверку языка
Три экспорта содержат видео H.264 и звук AAC. Локальные проверки сопоставляют длину потоков с запланированным таймлайном и полностью декодируют каждый файл:
ffprobe -v error -show_streams -show_format -of json rebuilt-ja/narrated.mp4
ffmpeg -v error -i rebuilt-ja/narrated.mp4 -f null -
Визуально проверьте самую длинную реплику и все продлённые сцены. Интерфейс остаётся английским: японский или корейский голос объясняет задачу, но не доказывает перевод экранных надписей. Сохраните эту границу и в тексте для распространения ролика.
Техническая проверка не заменяет оценку произношения. Перед использованием адаптированного варианта в кампании прослушайте весь экспорт, особенно «API», названия продукта, окончания слов и переходы к следующей сцене. В этой работе не было группы слушателей-экспертов; мы не заявляем качество на уровне носителя языка или превосходство над другим сервисом. MP4 доступны, чтобы оценивать реальные результаты.
Расшифровка другой моделью может подсказать возможные пропуски, но не является окончательным доказательством произнесённого. Сохраняйте утверждённый текст, а спорные места проверяйте на слух. Для пословных субтитров нужна отдельная транскрипция или выравнивание с проверенными временными метками. Расписание предложений не даёт границ отдельных слов.
7. Ведите учёт правок и расходов
Если изменилась одна локализованная реплика, создайте её новую версию, измерьте файл и пересоберите весь таймлайн этого языка. Не заменяйте WAV, оставляя старый хеш и отчёт. В записи о публикации достаточно указать версию текста, параметры модели, дату исходной съёмки и хеш готового файла.
Длительности трёх роликов не равны трём счетам за генерацию. Английский звук повторно использован, а японский и корейский потребовали десяти новых запросов. Мы не сверяли эти вызовы с окончательными списаниями, поэтому не приводим общую стоимость или процент экономии. Перед массовой локализацией проверьте текущие единицы тарификации и записи о своих запросах.
При сбое различайте авторизацию шлюза, квоту поставщика, декодирование звука и монтажные ошибки. Ответ об исчерпанной квоте поставщика нельзя автоматически трактовать как пустой кошелёк Ofox. Если речь уже создана, а сборка остановилась из-за длины исходника, отличной от 30 секунд, или другого PCM-формата, исправляйте локальные входные данные, а не многократно оплачивайте ту же генерацию.
Начните с одной фразы со сложными терминами, проверьте её реальный результат и только потом расширяйте проект. Полезный комплект для повторного использования — это утверждённые тексты, сохранённый звук и отдельные временные отчёты, а не обещание подогнать любой язык под один неизменный таймлайн.
Часто задаваемые вопросы
- Можно ли использовать английский таймлайн для японской и корейской озвучки?
- Только как исходный ориентир. Нужно измерить полученные файлы: первая фраза заняла 3,56 секунды на английском, 5,32 на японском и 4,68 на корейском. Поэтому первую сцену пришлось продлевать по-разному.
- Можно ли воспроизвести ролики без расходов на API?
- Да. В архиве есть сохранённая озвучка и исходное видео. Сборка через FFmpeg работает офлайн. Для генерации новых фраз нужен ключ с доступом к модели и доступным балансом.
- Это полностью локализованные продуктовые ролики?
- Локализована озвучка. В кадре остаётся исторический английский интерфейс. Перевода экранных карточек, новых локализованных скриншотов, пословных субтитров и синхронизации губ здесь нет.