Gemini TTSで製品動画に英語・日本語・韓国語のナレーションを追加する
Ofox経由のGemini TTSで、同じ製品デモに3言語のナレーションを追加。台本のローカライズ、実音声の計測、言語別の尺調整を、WAV・MP4・再現用コード付きで解説します。
 Ofox
1本の製品デモを英語・日本語・韓国語に展開するなら、台本をローカライズし、言語ごとに音声を生成したうえで、実測した長さに合わせてタイムラインを組み直します。字幕だけを翻訳しても声は変わりません。文字数が近い文章でも、元のシーンに収まるとは限りません。
2026年10月9日、Ofox経由で google/gemini-3.8-flash-tts を呼び出し、Koreの声で日本語5本、韓国語5本のWAVを生成しました。英語は前回のナレーション追加チュートリアルで実際に生成した5本を再利用しています。本稿で追加したのは、言語別の尺調整と3本の完成動画です。言語や音声サービスの優劣を競う比較ではありません。
再現用プロジェクトをダウンロードするか、英語版MP4、日本語版MP4、韓国語版MP4をご覧ください。保存済み素材からの再構成はAPIを呼び出しません。
1. 何をローカライズするか決める
入力はOpusの製品デモ制作シリーズで使用した30秒のスクリーンショット動画です。画面は9月30日に取得した英語UIの記録であり、今回はOpusで新たに映像を生成していません。Geminiが音声を生成し、PythonとFFmpegが既存映像に配置しています。
成果物の範囲もそこから決まります。3言語のナレーション版であり、UI全体をローカライズした動画ではありません。スクリーンショットと英語のタイトルカードは共通です。字幕の新規作成、UI翻訳、声のクローン、リップシンクも含みません。現地語の画面が必要な施策では、実際のローカライズ済み画面を取得するなど、別の映像編集が必要です。スクリーンショット内の文字を書き換えて製品の対応言語を装うことはできません。
生成前に、公開先の尺制限も確認します。チュートリアルなら34秒でも構わなくても、30秒上限の広告枠には入らない場合があります。本例では文章を最後まで残すため、映像を延長しました。固定尺が必要なら該当する台詞を短くして再生成し、語尾を切り落として帳尻を合わせないようにします。
3言語とも、目的を明確にする、モデル一覧を示す、文書を探す、APIリファレンスを示す、最後に確認する、という変わりにくい内容だけを話します。過去の画面に見える価格、モデル数、キャンペーンを、現在の製品条件として読み上げることはしません。
2. 段落ではなく、5つの台詞をローカライズする
シーンごとのファイルにすると、修正が小さく済みます。APIリファレンスの台詞に発音の問題があった場合、その1本だけを作り直せます。レビューでも、意味、口調、表示中の操作を一文ずつ照合できます。
英語の冒頭は“A clear product video starts with a clear brief.”です。日本語では わかりやすい製品動画は、目的を明確にすることから始まります。、韓国語では 이해하기 쉬운 제품 영상은 명확한 기획에서 시작됩니다. としました。単語を一対一に置き換えるより、説明する作業の意味をそろえています。
4番目の日本語は、APIリファレンスを例として示す関係を残し、この API リファレンスのように、各シーンに対応する実際のページを示します。 としました。韓国語は API 참조 문서 を使い、後半で現在表示している対象を説明しています。原文にないAPI機能は追加していません。
同梱の narration-drafts.json には15文すべてを保存しています。ファイル名は編集可能な台本を意味し、公開前に未確認という意味ではありません。日本語と韓国語は音声生成前に独立したAI言語レビューを受けました。ただし、人間の母語話者による収録や聴取評価ではありません。文字として「API」が適切でも、生成音声が意図どおり読む証拠にはなりません。
自社の素材では、製品名、略語、UIラベル、英語のまま残す語を先に一覧化すると確認しやすくなります。台本と音声の検証を分け、承認したテキストを対応するWAVと一緒に保存してください。文字だけ更新して、古い録音を新しい台本の出力として扱わないためです。
3. 言語と音声形式を明示して生成する
正確なモデルIDとゲートウェイの例は、現在のGemini TTSモデルページで確認します。本例はKore、WAV、speed: 1.0 を共通とし、言語コードを en-US、ja-JP、ko-KR に分けました。
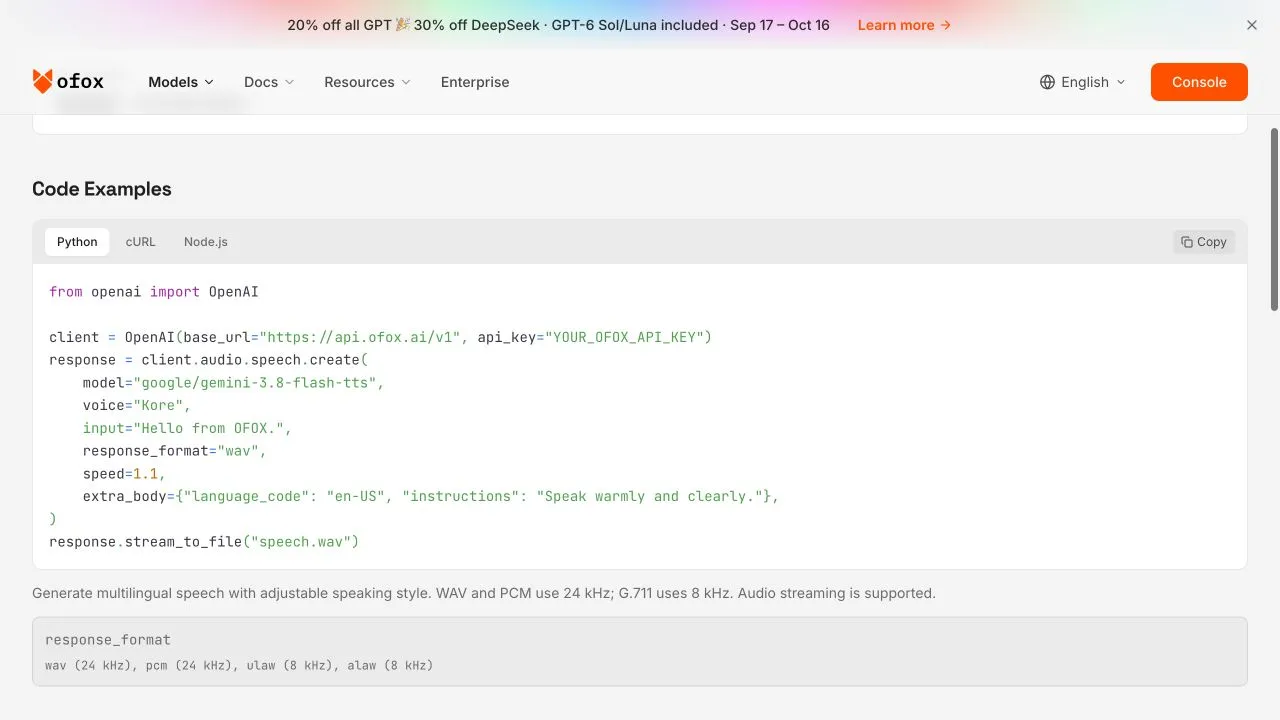
10月9日に取得した実画面です。画面上の速度例は1.1ですが、本プロジェクトで記録したリクエストは1.0です。画面は接続例を示すもので、生成成功の証拠は保存したレスポンスと音声ファイルです。
日本語リクエストの最小例は次のとおりです。韓国語では承認した韓国語台詞と ko-KR の両方に変更します。テキストだけ差し替えて言語コードを残さないでください。
import os
from pathlib import Path
import requests

payload = {
    "model": "google/gemini-3.8-flash-tts",
    "voice": "Kore",
    "input": "次に、ドキュメントがどこにあるかを案内します。",
    "language_code": "ja-JP",
    "speed": 1.0,
    "response_format": "wav",
}
r = requests.post(
    "https://api.ofox.ai/v1/audio/speech",
    headers={"Authorization": "Bearer " + os.environ["OFOX_API_KEY"]},
    json=payload,
    timeout=(15, 120),
)
r.raise_for_status()
if not r.headers.get("content-type", "").startswith("audio/"):
    raise RuntimeError("Expected audio; inspect the response")
Path("ja-line-3.wav").write_bytes(r.content)
キーは環境変数から読み込み、ブラウザー内のコードや共有ファイルに置きません。前回の完全版クライアントはメディア処理ツールの有無を確認し、安全なメタデータを保存します。課金され得るPOSTは自動再試行しません。タイムアウトは処理されなかった証拠ではないため、再送前にリクエスト状態と利用記録を確認します。
新規10リクエストはすべてHTTP 200でした。出力は24kHz、モノラル、16bit PCMのWAVで、全体のデコードも通過しています。これは今回の入力と実行日に対する結果であり、将来同じ音声が返る保証ではありません。パラメーター、生成時刻、ファイルハッシュをまとめて残し、声や出力が変わったら再計測します。
4. 編集前に実際の長さを比較する
表は無音部分も含めたWAV全体の長さで、単語境界ではありません。文字数から推定せず、実ファイルを ffprobe で測ります。
ffprobe -v error -show_entries stream=codec_name,sample_rate,channels \
-show_entries format=duration -of json ja/line-1.wav| シーン | 英語WAV | 日本語WAV | 韓国語WAV | 元の尺 |
|---|---|---|---|---|
| 目的の確認 | 3.56秒 | 5.32秒 | 4.68秒 | 4秒 |
| モデル一覧 | 4.64秒 | 4.80秒 | 4.72秒 | 7秒 |
| ドキュメント | 3.44秒 | 3.80秒 | 4.28秒 | 7秒 |
| APIリファレンス | 4.96秒 | 6.12秒 | 6.76秒 | 7秒 |
| 最後の確認 | 5.44秒 | 5.48秒 | 5.64秒 | 5秒 |
最初のシーンだけでも、そのまま使い回せないことが分かります。日本語は声だけで5.32秒あり、元の4秒を超えています。さらに画面を見るための余白も必要です。韓国語のAPI説明も、開始前後の余白を加えると延長が必要になります。
この5文から「日本語は常に遅い」「韓国語には必ず長い尺が必要」と一般化はできません。語句、句読点、声、出力の変動が影響するためです。ここで役立つ結論は、各テイクを測り、それぞれの画面をどう編集するか決めることです。
5. 言語ごとにタイムラインを組み直す
元動画の区切りは0、4、11、18、25、30秒です。組み立てスクリプトは5シーンの順序を維持し、それぞれに新しい長さを計算します。音声開始前に0.35秒、WAV終了後に少なくとも0.65秒を確保し、足りなければそのシーンの最終フレームを保持します。音声を速めたり切ったりはしません。
30fpsでの計算式は次のとおりです。
scene_frames = ceil(max(original_scene_seconds, wav_seconds + 1.0) * 30)
scene_seconds = scene_frames / 30
speech_start = cumulative_scene_seconds + 0.35
整数フレームに切り上げるため、単純な小数の合計とは少し違う尺になります。完成版は英語約32.03秒、日本語33.97秒、韓国語34.13秒です。英語も前回の32秒版と同じファイルではありません。今回は3言語に共通のシーン単位ルールを適用しています。
Python 3、FFmpeg、ffprobeを用意し、展開したディレクトリで実行します。
python3 assemble_localized.py en source.mp4 rebuilt-en
python3 assemble_localized.py ja source.mp4 rebuilt-ja
python3 assemble_localized.py ko source.mp4 rebuilt-ko
各出力先に narrated.mp4、narration.wav、timing.json、probe.json ができます。時間表には元映像の区間、新しいシーン長、追加した静止時間、音声の開始・終了、WAVのハッシュが記録されます。以前の書き出しを誤って上書きしないよう、新しい出力ディレクトリを指定します。
スクリーンショットのデモなら、短い静止時間を追加しても参照画面を保てます。ただし、人物の口元、カーソル操作、速い動きに同じ方法が適するとは限りません。その場合は該当する映像を作り直すか編集してください。フレームを止めるだけでは、別言語の声に口の動きを合わせられません。
6. ファイルと話し言葉を別々に検証する
3本ともH.264映像とAAC音声を含みます。ローカル検証では、計画したタイムラインと各ストリームの長さを照合し、ファイル全体をデコードしました。
ffprobe -v error -show_streams -show_format -of json rebuilt-ja/narrated.mp4
ffmpeg -v error -i rebuilt-ja/narrated.mp4 -f null -
最も長い台詞と、延長したすべてのシーンを目で確認します。参照映像は英語UIのままなので、日本語や韓国語の声が作業を説明しても、画面ラベルまで翻訳されたとは言えません。配信時の説明文でもこの範囲を保ちます。
技術検証は発音評価の代わりにはなりません。自分の用途に編集した動画を公開する前に、「API」、製品名、語尾、次のシーンへの移行を含め、全体を音付きで確認してください。本稿では人間による聴取評価を行っておらず、母語話者と同等の品質や他社より優れた声を主張しません。ダウンロードできるMP4が実際の出力です。
別モデルの文字起こしは抜けを探す補助になりますが、実際に発話された内容の唯一の証拠ではありません。承認済み台本を残し、食い違いは聴いて確認します。単語単位の字幕には、検証したタイムスタンプを持つ別の書き起こし・アラインメント工程が必要です。文単位の時間表から単語位置は出せません。
7. 修正履歴と費用の範囲を残す
台詞を1文だけ変更する場合も、新しいWAVを測って、その言語のタイムライン全体を再構成します。音声を上書きしながら古いハッシュや時間表を残さないでください。台本の版、モデル設定、素材映像の日付、最終ファイルのハッシュを公開記録にまとめます。
3本の動画の尺は3件の請求額ではありません。英語の声は再利用で、日本語・韓国語では計10回の新規生成を行いました。確定請求との突き合わせはしていないため、合計費用や節約率は示しません。大量展開の前に、現在の課金単位と実際の利用記録を確認します。
エラーはゲートウェイ認証、上流の割当量、音声のデコード、編集タイムラインに分けて調べます。上流の割当量エラーを、直ちにOfoxの残高不足と診断してはいけません。生成成功後に元動画の尺やPCM形式の不一致で組み立てが失敗したなら、同じ音声を繰り返し生成するより、ローカル入力を修正します。
難しい固有語を含む1文から始め、実際の出力を確認してから全体へ広げると管理しやすくなります。再利用するのは、承認済み台本、保存した声、言語別の時間表です。計測なしで全言語に同じタイムラインを当てはめることではありません。
よくある質問
- 英語版のタイムラインを日本語・韓国語にも使えますか?
- 出発点にはできますが、生成音声の計測が必要です。本例の冒頭は英語3.56秒、日本語5.32秒、韓国語4.68秒で、最初のシーンに必要な延長時間が異なりました。
- APIを利用せずに動画を再現できますか?
- はい。保存済み音声と元動画を同梱しているため、FFmpegでの再構成はオフラインで実行できます。新しい音声の生成には、アクセス権と利用可能な残高のあるキーが必要です。
- 3本とも完全にローカライズされた動画ですか?
- ナレーションを3言語化した動画です。画面は過去に撮影した英語UIのままで、UIやタイトルカードの翻訳、単語単位の字幕、リップシンクは含みません。