7 LLMs im Test: Was kostet ein korrektes Ergebnis wirklich?
7 Modelle, dieselben Aufgaben, 86 abgerechnete API-Aufrufe: was ein korrektes Ergebnis laut Rechnung kostet – inklusive leerer Antworten und Eskalations-Skript.
 Ofox
Bei den getesteten Alltagsaufgaben lieferte das günstigste Modell jede Antwort, die auch das teuerste lieferte, zu 1/75 der abgerechneten Kosten bei Besprechungsnotizen und zu 1/45 bei einer Fehlerkorrektur. Bei schwierigeren Aufgaben war ein niedriger Tokenpreis kein verlässlicher Hinweis mehr auf niedrige Kosten pro Ergebnis: DeepSeek V4.1 Flash und Qwen 3.8 Flash verbrauchten mitunter ihr gesamtes Ausgabebudget mit Nachdenken, gaben nichts zurück und bekamen das trotzdem berechnet. Vergleichen Sie deshalb, was ein korrektes Ergebnis kostet, und prüfen Sie es, bevor Sie ihm vertrauen.
Dieser Artikel ist die schriftliche Ergänzung zu unserem Video, präsentiert von Marie, einer KI-generierten Moderatorin. Das ofox-Team hat alle Tests am 20. und 21. Oktober 2026 entworfen und durchgeführt, jeden Aufruf mit der ofox-Rechnung abgeglichen und die Skripte sowie die Rohergebnisse unten veröffentlicht.
Auf YouTube ansehen (Video auf Englisch, 5 Min.): How to Cut AI API Costs Without Losing Accuracy (7 Models Tested)
Für wen dieser Artikel gedacht ist: Entwickler und kleine Teams, die LLM-APIs aufrufen und weniger ausgeben möchten, ohne zu raten. Das Abo-Kontingent in den Apps von Codex, ChatGPT oder Claude wird nicht gemessen, weil diese Tarife nicht veröffentlichen, wie die Nutzung in Kontingent umgerechnet wird.
Warum der Preis pro Token die falsche Kennzahl ist
Zwischen der Preisliste eines Modells und Ihrer Rechnung stehen drei Faktoren.
- Die Schwierigkeit der Aufgabe entscheidet, ob ein günstiges Modell genügt. Scheitert es, zahlen Sie ein zweites Mal für ein stärkeres Modell.
- Reasoning-Modelle rechnen das Nachdenken als Ausgabe ab. Die
reasoning_tokensinnerhalb voncompletion_tokenswerden berechnet, auch wenn Sie sie nie zu sehen bekommen. - Auch Fehlschläge werden abgerechnet. Eine leere oder falsche Antwort kostet dieselben Token wie eine gute.
Die vergleichbare Kennzahl sind daher die Kosten pro korrektem Ergebnis: die abgerechneten Kosten aller Durchläufe, die nötig waren, bis eine Antwort Ihre Prüfung bestand. Dieselbe Idee haben wir für Videos in Kosten pro brauchbarem Clip (Englisch) verwendet, und unser Leitfaden zum Routing von Luna zu Sol (Englisch) beschreibt die Entscheidungsregeln anhand selbst erstellter Beispiele. Dieser Artikel ergänzt gemessene, tatsächlich abgerechnete Zahlen.
So haben wir getestet
| Punkt | Details |
|---|---|
| Zeitraum | Haupttest am 20. Oktober 2026; Eskalations-Demo und Coding-Prüfungen am 21. Oktober 2026 |
| Zugang | OpenAI-kompatibler ofox-Endpunkt https://api.ofox.ai/v1/chat/completions |
| Modelle | anthropic/claude-opus-5.5, anthropic/claude-sonnet-5.5, anthropic/claude-haiku-5.5, openai/gpt-6-sol, openai/gpt-6-luna, deepseek/deepseek-v4.1-flash, qwen/qwen3.8-flash |
| Eingaben | Von uns geschrieben: zwei Sets von Besprechungsnotizen und eine fehlerhafte Python-Funktion. Keine Kundendaten. |
| Bewertung | Automatisch. Notizen: Jedes erwartete Paar aus Verantwortlichem und Fälligkeitsdatum muss vorkommen, ohne zusätzliche Einträge (die Formulierung der Aufgaben wird nicht bewertet). Code: acht versteckte Tests, die in einem Subprozess laufen. |
| Wiederholungen | Jede bewertete Konfiguration lief zwei- oder dreimal. Das ist ein kleiner Test, kein Benchmark. |
| Kosten | Der Betrag, den ofox für jeden Aufruf tatsächlich berechnet hat, zugeordnet zu allen 86 abgeschlossenen Aufrufen über Modell, Tokenzahlen und Zeitpunkt. |
Die 86 abgeschlossenen Aufrufe setzen sich aus den 83 des Haupttests und drei zusätzlichen Durchläufen von GPT-6 Sol mit niedrigem Reasoning-Aufwand zusammen, die bei den schwierigen Notizen jedes Mal alle sieben Einträge trafen, zu $0.003582 pro Durchlauf. Die 83 enthalten 17 unbewertete GPT-6-Luna-Aufrufe aus einem Experiment mit langen Konversationen, das wir in diesem Artikel weggelassen haben, weil seine beiden Varianten keine gleichwertigen Aufgaben waren, sowie 6 GPT-6-Sol-Aufrufe, die niedrigen und hohen Reasoning-Aufwand bei der Fehlerkorrektur verglichen (beide bestanden; der hohe Aufwand kostete etwa 18 % mehr). Zwei Testeinträge liefen in Ratenlimits (HTTP 429). Claude-Modelle waren am 20. Oktober über den OpenAI-kompatiblen Endpunkt erreichbar. Seit dem 21. Oktober stellt ofox sie stattdessen über den Anthropic-kompatiblen Endpunkt (/anthropic/v1) bereit.
Ergebnis 1: Alltagsaufgaben
Aus Besprechungsnotizen Aufgaben ableiten. Die Notizen enthalten acht datierte Aufgaben und fünf Fallen: Ideen ohne Verantwortlichen, eine Entscheidung ohne Datum, einen Wartungshinweis. Jedes Modell fand in beiden Durchläufen alle acht Paare aus Verantwortlichem und Fälligkeitsdatum, ohne zusätzliche Einträge.
| Modell | Vollständig korrekte Durchläufe | Abgerechnet pro Durchlauf (Ø) | Ausgabe-Token (Ø) |
|---|---|---|---|
| Claude Opus 5.5 | 2/2 | $0.019712 | 657 |
| Claude Sonnet 5.5 | 2/2 | $0.011491 | 820 |
| GPT-6 Sol | 2/2 | $0.004806 | 337 |
| DeepSeek V4.1 Flash | 2/2 | $0.002470 | 1.908 |
| Qwen 3.8 Flash | 2/2 | $0.001405 | 1.852 |
| Claude Haiku 5.5 | 2/2 | $0.000607 | 885 |
| GPT-6 Luna | 2/2 | $0.000262 | 381 |
Opus kostete für dasselbe vollständig korrekte Ergebnis das 75,2-Fache von Luna. Auch die Geschwindigkeit ließ sich am Preis nicht ablesen: Luna antwortete in etwa 5 Sekunden, DeepSeek V4.1 Flash brauchte in einem Durchlauf 264,5 Sekunden und im anderen 13,2.
Eine Funktion mit vier Fehlern korrigieren. Die Funktion soll sich überschneidende Raumbuchungen zusammenführen und dazu sortieren, aneinandergrenzende Zeiträume zusammenfassen, den späteren Endzeitpunkt behalten und ungültige Buchungen verwerfen. Jedes Modell bestand in beiden Durchläufen alle acht versteckten Tests. Opus kostete im Schnitt $0.010086 pro Durchlauf, Luna $0.000225, ein Unterschied um den Faktor 44,8.
Ergebnis 2: eine schwierigere Aufgabe und die ersten echten Fehlschläge
Einfache Aufgaben trennen die Modelle nicht. Deshalb haben wir Notizen geschrieben, in denen die Beteiligten mitten in der Besprechung ihre Meinung ändern, datiert auf Dienstag, den 20. Oktober 2026. Eine Aufgabe geht von Priya an Omar über, eine Frist verschiebt sich vom 27. auf den 31., eine Aufgabe wird gestrichen, und die Datumsangaben sind relativ: “tomorrow” (morgen), “two business days from today” (in zwei Werktagen) und “end of next week” (Ende nächster Woche). Es gibt sieben korrekte Einträge. Die Ausgabe war auf 4.000 Token begrenzt.
| Modell | Vollständig korrekte Durchläufe | Abgerechnet pro Durchlauf (Ø) | Was schiefging |
|---|---|---|---|
| Claude Opus 5.5 | 3/3 | $0.019053 | Nichts |
| Claude Sonnet 5.5 | 3/3 | $0.011207 | Nichts |
| GPT-6 Sol | 3/3 | $0.003999 | Nichts |
| GPT-6 Luna | 3/3 | $0.000276 | Nichts |
| Claude Haiku 5.5 | 2/3 | $0.000675 | Ein Durchlauf ließ den Eintrag “end of next week” aus |
| Qwen 3.8 Flash | 1/2 | $0.002938 | Eine leere Antwort; die andere Anfrage lief in ein Ratenlimit |
| DeepSeek V4.1 Flash | 1/3 | $0.004423 | Zwei leere Antworten |
Die Fehlschläge von DeepSeek und Qwen waren keine falschen Antworten, sondern leere. Bei jeder dieser leeren Antworten lagen completion_tokens und reasoning_tokens beide bei 4.000, also genau am Limit, und content war ein leerer String.
Leere Antworten werden abgerechnet
Wir haben die Rechnung geprüft. Die ofox-Seite „Activity“ zeigt die Anfrage vom 20. Oktober um 15:07:37 Uhr (in der Oberfläche: 3:07:37 PM): 4K Ausgabe-Token, davon 4K Reasoning, berechnet mit $0.00480307.
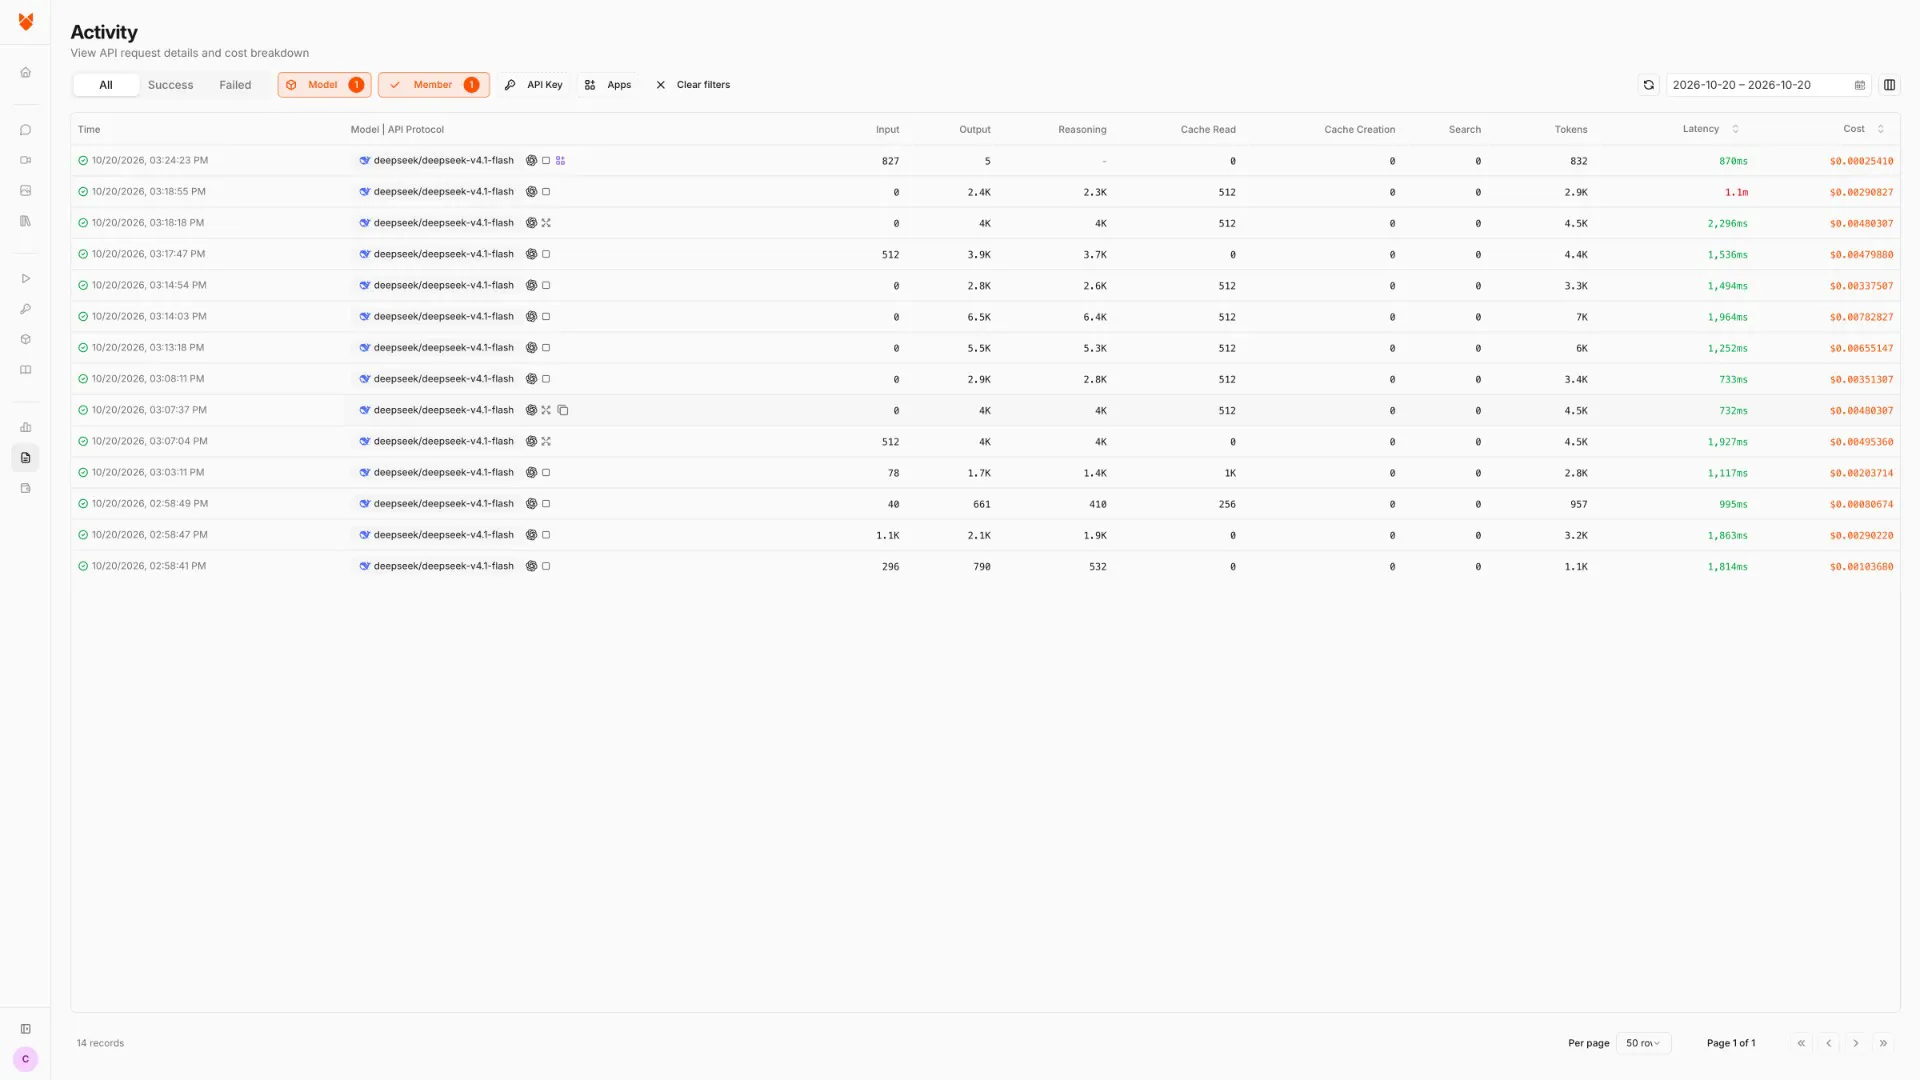
Der Screenshot zeigt das echte Dashboard mit englischer Oberfläche, vor der Aufnahme auf unsere eigenen Testanfragen gefiltert. Team, Guthaben und Daten anderer Mitglieder sind nicht zu sehen. Die beiden leeren DeepSeek-Antworten in diesem Test wurden mit $0.004803072 und $0.0049536 berechnet.
So umgehen Sie die Reasoning-Falle
Wir haben DeepSeek V4.1 Flash und Qwen 3.8 Flash mit denselben schwierigen Notizen erneut laufen lassen, entweder mit mehr Spielraum oder mit niedrigerem Reasoning-Aufwand. Jeweils drei Durchläufe.
| Einstellung | Vollständig korrekte Durchläufe | Abgerechnet pro Durchlauf (Ø) | Ausgabe-Token (Ø) | Antwortzeit (Median) |
|---|---|---|---|---|
| DeepSeek V4.1 Flash, Limit 16.000 | 3/3 | $0.005918 | 4.929 | 45,2 s |
DeepSeek V4.1 Flash, reasoning_effort: "low" | 2/3 | $0.004170 | 3.431 | 37,2 s |
| Qwen 3.8 Flash, Limit 16.000 | 3/3 | $0.002560 | 3.348 | 41,4 s |
Qwen 3.8 Flash, reasoning_effort: "low" | 3/3 | $0.000682 | 910 | 17,5 s |
Mit genug Spielraum löste DeepSeek die Aufgabe jedes Mal richtig, doch jeder korrekte Durchlauf kostete $0.0059. GPT-6 Sol erledigte dieselbe Aufgabe für $0.0040 mit etwa 305 Ausgabe-Token. Laut ofox-Preisliste kostet DeepSeek V4.1 Flash $0.30 für Eingabe und $1.20 für Ausgabe pro Million Token, GPT-6 Sol dagegen $2.00 und $10.00: etwa 1/7 des Eingabepreises und 1/8 des Ausgabepreises. Pro korrektem Ergebnis war DeepSeek trotzdem teurer, weil etwa 96,7 % seiner Ausgabe auf das Nachdenken entfielen.
Ein niedrigerer Reasoning-Aufwand half hier vor allem Qwen: Alle drei Durchläufe waren vollständig korrekt, zu je $0.000682 und mit einem Median von 17,5 Sekunden. DeepSeek half das nicht; das Modell lieferte auch mit niedrigem Aufwand noch eine leere Antwort. In diesen Tests mit je drei Durchläufen war das höhere Limit die Einstellung, mit der DeepSeek jedes Mal bestand.
Daraus ergeben sich zwei praktische Regeln:
- Legen Sie ein Ausgabe-Token-Limit und einen Reasoning-Aufwand bewusst fest, und werten Sie einen leeren
contentmitfinish_reason: "length"als Fehlschlag, nicht als Antwort. - Vergleichen Sie die abgerechneten Kosten pro korrektem Ergebnis, nie allein den Preis pro Million Token. Unser Break-even-Rechner für Routing (Englisch) zeigt, wie Wiederholungen und Fallbacks diese Zahl verändern.
Erst prüfen, dann eskalieren
Der übliche Rat lautet: mit einem günstigen Modell beginnen und zu einem besseren wechseln, wenn es scheitert. In der Praxis braucht „wenn es scheitert“ eine Prüfung, die sich ausführen lässt. Bei Code sind das Tests. Das folgende Skript ruft die Modelle vom günstigsten aufwärts auf, führt die Tests für jede Antwort aus und eskaliert nur, wenn sie fehlschlagen.
Um das Sicherheitsnetz in Aktion zu zeigen, brauchten wir ein günstiges Modell, das scheitert. GPT-6 Luna scheiterte nie: Es bestand alle 7 bewerteten Durchläufe im Haupttest und 15 von 15 über fünf Coding-Aufgaben, die wir dafür geschrieben haben (Werktage, Parsen von Zeitdauern, Aufteilen einer Rechnung, Cron-Zeitpläne und Zeiten bei Sommerzeitumstellung). GPT-6 Sol mit niedrigem Aufwand verfehlte in einem seiner 18 Coding-Durchläufe drei Fälle (Parsen von Zeitdauern, 16 von 19). Die Demo beginnt deshalb mit DeepSeek V4.1 Flash, das bei einer dieser Aufgaben, einer Cron-Funktion für den „nächsten Ausführungszeitpunkt“ mit zwölf Tests, in allen drei Durchläufen bei einem Limit von 4.000 Token leere Antworten lieferte.
import json, os, re
from openai import OpenAI

client = OpenAI(base_url="https://api.ofox.ai/v1",
                api_key=os.environ["OFOX_API_KEY"])

# Cheapest first. $ per 1M tokens (in, out), ofox, Oct 2026
TIERS = [
    ("deepseek/deepseek-v4.1-flash", 0.30, 1.20, {}),
    ("openai/gpt-6-sol", 2.00, 10.00,
     {"reasoning_effort": "low"}),
]

def passes(reply):
    m = re.search(r"```(?:python)?\n(.*?)```", reply, re.S)
    if not m:
        return 0
    ns = {}
    exec(m.group(1), ns)
    tests = json.load(open("tests.json"))
    return sum(ns["next_run"](*a) == want for a, want in tests)

task, total = open("task.txt").read(), 0.0
for model, p_in, p_out, extra in TIERS:
    r = client.chat.completions.create(
        model=model, max_tokens=4000,
        messages=[{"role": "user", "content": task}], **extra)
    u = r.usage
    cost = (u.prompt_tokens * p_in + u.completion_tokens * p_out) / 1e6
    total += cost
    ok = passes(r.choices[0].message.content or "")
    print(f"{model}\n  {u.completion_tokens} out tokens  ${cost:.4f}  tests {ok}/12")
    if ok == 12:
        print(f"PASS  total ${total:.4f}")
        break
    print("  check failed -> moving up")
Der echte Durchlauf vom 21. Oktober 2026:
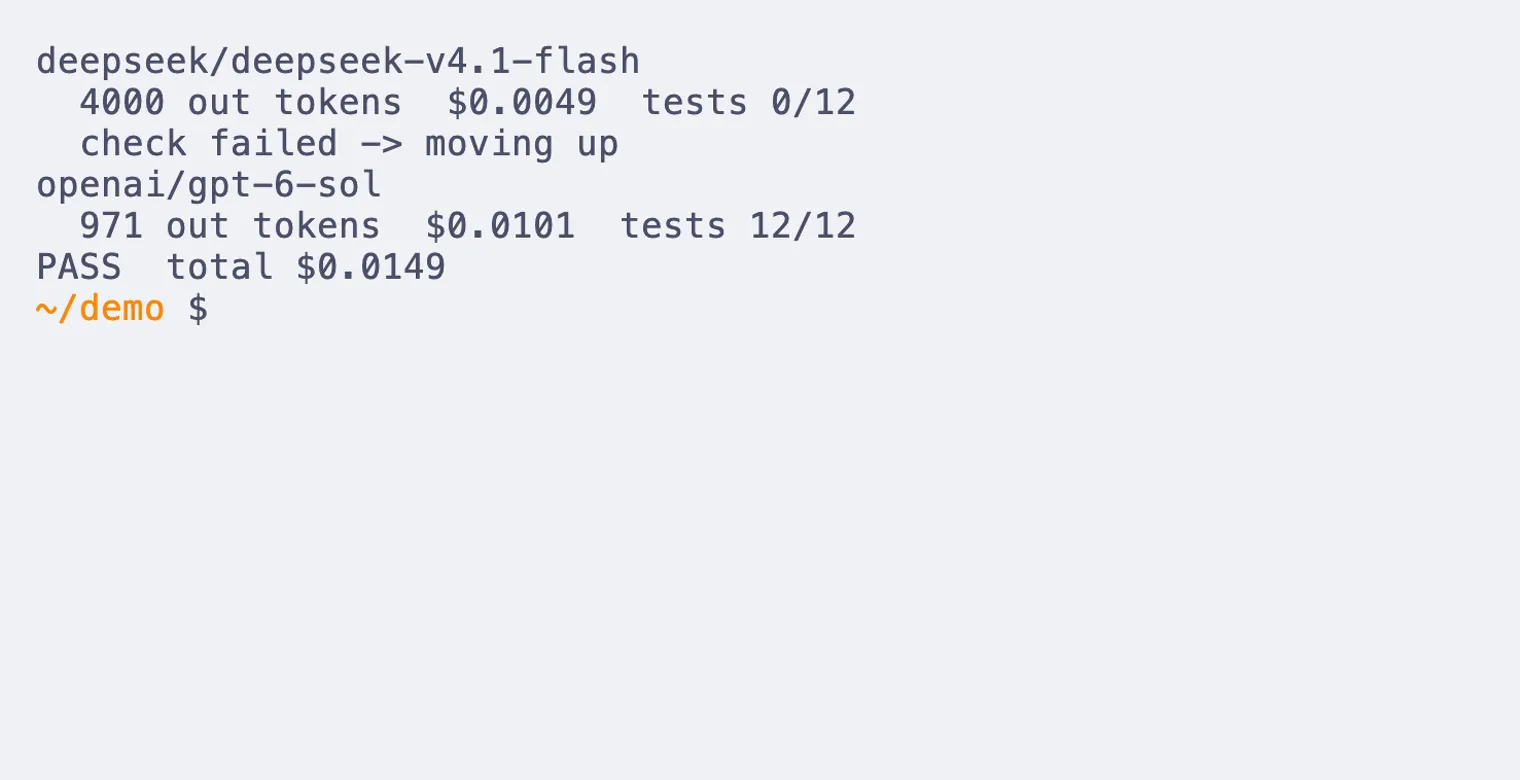
deepseek/deepseek-v4.1-flash
  4000 out tokens  $0.0049  tests 0/12
  check failed -> moving up
openai/gpt-6-sol
  971 out tokens  $0.0101  tests 12/12
PASS  total $0.0149
Die hier ausgegebenen Kosten sind die von der API zurückgegebene Tokennutzung multipliziert mit dem ofox-Listenpreis. Achten Sie auf die Summe: Der gescheiterte DeepSeek-Versuch schlug mit etwa einem halben Cent zusätzlich zu Buche, sodass dieser Durchlauf mehr kostete, als ein direkter Start mit Sol gekostet hätte.
Eine Prüfung soll Sie nicht dazu bringen, jedes Mal das günstige Modell auszuprobieren. Sie zeigt, mit welchem Modell jede Art von Aufgabe starten sollte. DeepSeek V4.1 Flash war für diese Aufgabe die falsche erste Stufe. GPT-6 Luna, pro Token günstiger als beide, bestand dieselbe Cron-Aufgabe in allen drei Durchläufen (in dieser Prüfung mit einem Limit von 6.000 Token) und traf außerdem jeden Eintrag der Besprechungsnotizen. Nach unseren Durchläufen können Extraktionsaufgaben wie die Besprechungsnotizen und diese fünf Coding-Aufgaben mit Luna beginnen. Beginnen Sie nur dort höher, wo Ihre eigene Prüfung zeigt, dass das günstige Modell scheitert, und behalten Sie den Eskalationspfad für diese Fälle.
Beachten Sie, dass exec vom Modell geschriebenen Code in Ihrem Prozess ausführt. Für eine Demo mit Code, den Sie ohnehin prüfen, ist das vertretbar. Für alles Automatisierte sollten Sie die Tests in einer Sandbox oder einem Subprozess ausführen, so wie es unser vollständiger Test-Runner tut.
So übertragen Sie das auf Ihre eigene Arbeit
Im Arbeitsalltag haben Sie keine Musterlösung, also legen Sie sich eine kleine an.
- Wählen Sie drei Aufgaben, die Sie täglich ausführen, und speichern Sie für jede fünf bis zehn echte Eingaben.
- Schreiben Sie die Prüfung, bevor Sie ein Modell wählen. Für Code eine Handvoll Tests. Für Extraktion die erwarteten Felder sowie Stichproben einiger Einträge gegen die Quelle. Für Zusammenfassungen eine kurze Liste von Fakten, die vorkommen müssen.
- Lassen Sie das günstigste infrage kommende Modell zwei- bis dreimal pro Eingabe laufen und erfassen Sie Bestehensquote, Ausgabe-Token und abgerechnete Kosten. Prüfen Sie die Rechnung, nicht Ihre Schätzung. Reasoning-lastige Modelle können weit mehr kosten, als ihr Tokenpreis vermuten lässt.
- Legen Sie das Startmodell jeder Aufgabe auf das günstigste Modell fest, das in Ihren Durchläufen zuverlässig besteht. Nutzen Sie die Eskalation für die Fehlschläge, nicht als Standardweg.
- Wiederholen Sie die Prüfung, wenn sich Preise oder Modellversionen ändern.
| Symptom | Wahrscheinliche Ursache | Was zu tun ist |
|---|---|---|
content ist leer und completion_tokens entspricht Ihrem Limit | Das Reasoning hat das gesamte Ausgabebudget verbraucht | max_tokens erhöhen, reasoning_effort senken oder für diese Aufgabe ein Modell ohne Reasoning verwenden |
| HTTP 429 | Ratenlimit | Mit Backoff erneut versuchen. Bei uns trat das bei Qwen 3.8 Flash auf. |
| JSON oder Codeblock lässt sich nicht parsen | Das Modell hat Fließtext um die Antwort geschrieben | Das Format ausdrücklich anfordern und den ersten Codeblock (zwischen ```) bzw. das erste JSON-Array extrahieren |
| Ein Durchlauf dauert Minuten | Lange oder schwankende Denkzeit | Einen Anfrage-Timeout setzen. Für latenzkritische Aufgaben auf Modelle mit langem Reasoning verzichten. |
Claude-Modell wird auf /v1 mit “does not support the ‘openai’ protocol” abgelehnt | Seit dem 21. Oktober 2026 führt der ofox-Katalog Claude nur noch unter dem Anthropic-Protokoll; wir haben diesen Fehler in Tests am 21. und 22. Oktober gesehen | Das Anthropic-SDK mit der Basis-URL https://api.ofox.ai/anthropic verwenden. In unserem Test vom 22. Oktober wurden IDs im Stil von claude-sonnet-5.5 und anthropic/claude-sonnet-5.5 auf /anthropic/v1/messages akzeptiert. |
Grenzen dieses Tests
- Die Eingaben sind synthetisch und kurz. Die Besprechungsnotizen umfassen etwa tausend Token.
- Jede Konfiguration lief zwei- oder dreimal. Betrachten Sie die Bestehensquoten als das, was in diesen Durchläufen geschah, nicht als stabile Erfolgsquoten.
- Die Bewertung der Notizen prüft Paare aus Verantwortlichem und Fälligkeitsdatum sowie zusätzliche Einträge. Sie bewertet nicht, wie die einzelnen Aufgaben formuliert sind.
- Die Beträge sind das, was ofox am 20. und 21. Oktober 2026 berechnet hat, mit Ausnahme der Eskalations-Demo: Dort haben wir die von der API gemeldete Nutzung mit dem Listenpreis multipliziert. Die Claude-Antworten, die wir über den OpenAI-kompatiblen Endpunkt erhielten, enthielten keine Aufschlüsselung des Prompt-Caches.
- Preise und Modellversionen ändern sich. Prüfen Sie die aktuelle ofox-Modellliste, bevor Sie diese Zahlen weiterverwenden.
- Strategien für Prompt-Caching, Batch-APIs und semantisches Caching haben wir nicht getestet. Diese behandelt unser Überblick zur Kostensenkung (Englisch).
- Ofox hat diesen Artikel veröffentlicht und die Tests auf der eigenen Plattform durchgeführt.
Downloads
Alle Dateien liegen unter /blog/_assets/evidence/cost-per-correct-result-20261022/:
results-billed.csv: alle 86 Aufrufe mit Token, Bewertung und abgerechnetem Betragrunner.py: der Test-Runner und die Bewertungsskripteescalate.py,cron-task.txt,cron-tests.json: die Eskalations-Democoding-tasks/results.csv: die Prüfungen der fünf Coding-Aufgaben- Eingaben und Musterlösungen:
meeting_notes.md,meeting_notes_hard.md,ground_truth.json,ground_truth_hard.json,buggy_code.py,hidden_tests.py
Setzen Sie OFOX_API_KEY in Ihrer Umgebung, um sie auszuführen. Bevor Sie escalate.py starten, speichern Sie cron-task.txt als task.txt und cron-tests.json als tests.json im selben Ordner. Die Ergebnisse der Coding-Aufgaben enthalten außerdem Durchläufe von GLM 5.3 Flash und Qwen 3.8 Flash mit einem Limit von 6.000 Token; die meisten davon lieferten leere Antworten und werden oben nicht besprochen. Wenn Sie Kosten gegen Nutzungslimits statt pro Aufruf messen möchten, behandeln unsere Leitfäden zu den wöchentlichen Codex-Limits (Englisch) und den Nutzungslimits von Claude Code (Englisch) die Abo-Seite.
Häufig gestellte Fragen
- Ist das Modell mit dem niedrigsten Tokenpreis auch pro Aufgabe am günstigsten?
- Nicht immer. In unserem schwierigeren Test kostete DeepSeek V4.1 Flash pro Ausgabe-Token etwa ein Achtel von GPT-6 Sol, ein korrekter Durchlauf kostete aber $0.0059 gegenüber $0.0040 bei Sol, weil das Modell rund 4.900 Ausgabe-Token verbrauchte, davon 97 % für Reasoning.
- Kosten leere Antworten von Reasoning-Modellen Geld?
- Ja. Die von der API zurückgegebene Nutzung zählte alle 4.000 Ausgabe-Token, und ofox hat sie berechnet, zum Beispiel $0.00480307 für eine leere Antwort von DeepSeek V4.1 Flash.
- Erfahre ich dadurch, wie viel Abo-Kontingent bei Codex oder ChatGPT ich spare?
- Nein. Wir haben API-Tokenkosten gemessen. Abo-Tarife veröffentlichen nicht, wie die Nutzung in Kontingent umgerechnet wird.