Claude Fable 5.2 per API nutzen: Anbindung, Ausgaben und Kosten prüfen
Fable 5.2 mit exakter Modell-ID anbinden, native Anfragen prüfen, Tool-Verläufe erhalten und Tokenkosten berechnen – mit klaren Grenzen der Tests.
 Ofox
Für eine neue Fable-5.2-Anbindung sollten Sie eine exakte Modell-ID verwenden, zunächst eine kleine Anfrage senden und Antworttext sowie Abbruchgrund prüfen, bevor Sie Tools ergänzen oder bestehende Unterhaltungen übernehmen. Bei Ofox lautet die Katalog-ID anthropic/claude-fable-5.2, bei der Claude API claude-fable-5-2. Diese Kennungen gehören in unterschiedliche Anbieter-Konfigurationen.
Dieser Leitfaden trennt die dokumentierte Modellschnittstelle, den aktuellen Ofox-Katalog und die Prüfungen Ihrer Anwendung. Dokumentation, Katalog und ein kleiner API-Test mit nativem Protokoll wurden am 10. November 2026 geprüft. Der folgende cURL-Request-Body wurde getestet; die SDK-Ausschnitte zeigen das entsprechende Integrationsmuster, wurden aber nicht separat gegen den Dienst ausgeführt. Ofox veröffentlicht diesen Blog und betreibt das hier beschriebene Gateway.
Endpunkt und exakte Modell-ID zusammen auswählen
| Zugang | Modellkennung | Anfrage-Endpunkt |
|---|---|---|
| Claude API | claude-fable-5-2 | https://api.anthropic.com/v1/messages |
| Ofox, Anthropic-Protokoll | anthropic/claude-fable-5.2 | https://api.ofox.ai/anthropic/v1/messages |
| Ofox, OpenAI-kompatible Chat Completions | anthropic/claude-fable-5.2 | https://api.ofox.ai/v1/chat/completions |
Die offizielle Übersicht nennt ein Kontextfenster von 1 Million Token und maximal 128.000 Ausgabe-Token. Das sind Obergrenzen, keine sinnvollen Standardgrößen für einzelne Anfragen. Beginnen Sie mit einer kurzen, nicht vertraulichen Eingabe und einer begrenzten Ausgabelänge.
Die Ofox-Modellseite und der öffentliche Katalog nennen Anthropic und OpenAI als Protokolle; als Anbietertyp für 5.2 ist derzeit aws_bedrock eingetragen. Ein Protokolleintrag beweist nicht, dass jede Anthropic-Betafunktion auf jeder Route durchgereicht wird. Testen Sie eine konkrete Funktion, bevor Ihre Anwendung davon abhängig wird.
Ein leicht übersehener Versionsfehler: In unserem datierten Katalogabzug ist claude-fable-latest weiterhin ein Alias des 5.1-Eintrags. Verwenden Sie bei Einführungstests die exakte 5.2-ID und speichern Sie das zurückgemeldete Modell sowie die Request-ID. Gehen Sie nicht davon aus, dass ein Alias mit der Veröffentlichung einer neuen Version automatisch umgestellt wurde.
Eine kleine native Anfrage senden
Erstellen Sie nach der Ofox-Anleitung zur Authentifizierung einen API-Key und laden Sie ihn über Ihre übliche Geheimnisverwaltung in OFOX_API_KEY. Führen Sie den Aufruf auf einem Server oder einem lokalen Entwicklungsrechner aus, nicht in öffentlich ausgeliefertem Browsercode. Der folgende Body lässt Sampling, erzwungene Tool-Auswahl und optionale Beta-Steuerungen bewusst weg.
curl --fail-with-body --max-time 180 \
  https://api.ofox.ai/anthropic/v1/messages \
  -H "x-api-key: $OFOX_API_KEY" \
  -H 'anthropic-version: 2023-06-01' \
  -H 'content-type: application/json' \
  --data '{
    "model": "anthropic/claude-fable-5.2",
    "max_tokens": 4096,
    "output_config": {"effort": "low"},
    "messages": [{
      "role": "user",
      "content": "A synthetic order contains 3 units at USD 12 each. Return the total and one calculation line. Do not use tools."
    }]
  }' > response.json
Das erwartete Rechenergebnis ist 36 USD. Unsere tatsächliche Antwort enthielt diesen Betrag und den Rechenweg, mit HTTP 200, stop_reason: "end_turn", 46 Eingabe-Token und 32 Ausgabe-Token. Diese einzelne synthetische Anfrage bestätigt den engen Testfall, nicht jeden produktiven Workflow. Prüfen Sie Ihre eigene response.json, bevor Sie fortfahren. Ein erfolgreicher HTTP-Status allein belegt weder eine vollständige Antwort noch die Erfüllung der Aufgabe oder einen Abschluss innerhalb des Ausgabelimits.
Mit diesem kleinen Prüfskript vermeiden Sie die Annahme, dass bereits der erste Inhaltsblock Text enthält:
import json
from pathlib import Path

response = json.loads(Path("response.json").read_text())
if "error" in response:
    raise RuntimeError(response["error"])
text = "\n".join(
    block.get("text", "") for block in response.get("content", [])
    if block.get("type") == "text"
)
print("model:", response.get("model"))
print("stop_reason:", response.get("stop_reason"))
print("usage:", response.get("usage"))
print(text)
if response.get("stop_reason") != "end_turn" or not text.strip():
    raise SystemExit("Not a completed text answer; inspect before continuing.")
Verlangen Sie für diesen Test ohne Tools eine abgeschlossene Textantwort und prüfen Sie die Rechnung manuell. In der Produktion ersetzen Sie die manuelle Kontrolle durch einen unabhängigen, zum Ausgabeformat passenden Validator. Eine Teilzeichenfolgensuche nach 36 reicht nicht: Auch „Die Summe ist nicht 36“ enthält die Zahl.
Die Dokumentation zu nativen Messages beschreibt Endpunkt und Authentifizierungsformat. Nutzt Ihre Anwendung stattdessen Chat Completions, verwenden Sie durchgängig dessen Formen für messages, Antworten und Tool-Ergebnisse. Fügen Sie keine nativen tool_result-Blöcke in einen Verlauf im OpenAI-Format ein und erwarten Sie nicht, dass der Adapter den ursprünglichen Zustand rekonstruiert.
Genügend Platz für Thinking und Antwort vorsehen
Fable 5.2 verwendet stets aktiviertes adaptives Thinking. output_config.effort steuert den Denkaufwand; der Preis eines einzelnen Tokens ändert sich dadurch nicht. Der kleine Test nutzt low, um eine triviale Aufgabe zu begrenzen. Für anspruchsvolle Repository-Reparaturen oder mehrstufige Analysen ist das keine Empfehlung.
Beginnen Sie bei umfangreicheren Aufgaben mit dem dokumentierten Standard high und vergleichen Sie niedrigere Stufen anhand Ihrer Abnahmetests. Anthropics Effort-Leitfaden empfiehlt höhere Stufen für Aufgaben, bei denen der zusätzliche Aufwand hilft. Messen Sie Tokenverbrauch und Aufgabenerfüllung, nicht nur den sprachlichen Eindruck der Antwort.
max_tokens umfasst Thinking und Antwortausgabe. Eine kleine Grenze kann deshalb einen Thinking-Block mit anschließendem stop_reason: "max_tokens" erzeugen, ohne sichtbare Antwort. Das ist etwas anderes als ein 400-Anfragefehler. Prüfen Sie den Abbruchgrund und erhöhen Sie dann gezielt das Limit oder verringern Sie Effort. Wiederholen Sie nicht blind dieselbe zu kleine Begrenzung und verkaufen Sie die entstandenen Kosten anschließend als Modellpreisvergleich.
Streamen, ohne die endgültige Nachricht zu verlieren
Bewahren Sie beim offiziellen Python-SDK die zusammengesetzte Nachricht nach Ende des Streams auf. Diese Vorlage ist für ein aktuelles SDK mit dem dokumentierten Feld output_config gedacht. Dokumentieren und fixieren Sie die SDK-Version, die Sie in Ihrer Anwendung tatsächlich prüfen.
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["OFOX_API_KEY"],
    base_url="https://api.ofox.ai/anthropic",
    max_retries=0,
    timeout=180.0,
)
with client.messages.stream(
    model="anthropic/claude-fable-5.2",
    max_tokens=4096,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Calculate 3 times 12."}],
) as stream:
    for text in stream.text_stream:
        print(text, end="", flush=True)
    final_message = stream.get_final_message()
print(final_message.stop_reason, final_message.usage)
Der Textstream dient der Anzeige. Er ist nicht die vollständige Nachricht, die Sie für einen späteren Tool-Schritt speichern sollten. Bricht die Verbindung vor Abschluss ab, markieren Sie den Versuch als unvollständig; speichern Sie keinen sichtbaren Teilverlauf als gültige Assistentenantwort. Die bestehende englische Diagnose für Thinking-Signaturen zeigt, welche Felder eine reine Textaufzeichnung verlieren kann.
Zuerst ein lesendes Tool, erst danach Seiteneffekte ergänzen
Ein geeignetes erstes Tool liefert einen synthetischen Lagerdatensatz. Definieren Sie lookup_stock mit einem Eingabeschema, das eine SKU als String verlangt, setzen Sie tool_choice auf auto und bitten Sie das Modell, SKU DEMO-001 zu prüfen. Validieren Sie den erzeugten Tool-Namen und die Argumente vor der Ausführung gegen Ihre Positivliste.
Eine vollständig ausführbare Alternative ist das lesende Lager-Testprogramm mit seinem Checkpoint-Modul. Es definiert read_stock für alle drei Testzeilen und enthält die erste Anfrage, Tool-Validierung, tatsächliche Ergebnisnachricht, Fortsetzung und abschließende Übergabeprüfung. Die Schritt-für-Schritt-Anleitung trennt lokale Prüfungen von ausdrücklich kostenpflichtiger Ausführung.
Beim nativen Protokoll hängen Sie den gesamten Assistenteninhalt genau wie erhalten an. Anschließend folgt eine Nutzernachricht mit dem tatsächlichen Ergebnis und der passenden Tool-ID:
# response is the completed SDK response; tool is one validated tool_use block.
messages.append({
    "role": "assistant",
    "content": [b.model_dump(exclude_none=True) for b in response.content],
})
messages.append({"role": "user", "content": [{
    "type": "tool_result",
    "tool_use_id": tool.id,
    "content": '{"sku":"DEMO-001","available":7,"source":"synthetic fixture"}'
}]})
Dieser Ausschnitt zeigt die Form der Fortsetzung, kein vollständiges Programm für mehrere Tools. Werden mehrere Aufrufe zurückgegeben, verarbeiten Sie jede Aufruf-ID und melden jedes tatsächliche Ergebnis. Bei einem Tool-Fehler ist ein Fehlerergebnis nötig, kein erfundener erfolgreicher Datensatz. Die englische Anleitung zu fehlendem tool_result erklärt Zuordnungsfehler; die Anleitung zum 5.2-Upgrade behandelt versionsspezifische Einschränkungen.
Setzen Sie auto nicht mit „Das Tool muss ausgeführt werden“ gleich. Wenn die Aufgabe eine Abfrage verlangt, das Modell aber nur Text liefert, muss Ihre Anwendung das erkennen und darf die Aufgabe nicht als abgeschlossen markieren. Beginnen Sie mit ausschließlich lesenden Testdaten, damit Wiederholungen beim Debuggen keine Bestellungen oder Nachrichten doppelt auslösen.
Die Rechnung aus getrennten Tokenkategorien berechnen
Standardtarife in USD pro Million Token, geprüft am 10. November:
| Kategorie | Veröffentlichter Tarif der Claude API | Ofox-Kataloglistenpreis |
|---|---|---|
| Nicht gecachte Eingabe | $8 | $8 |
| Ausgabe | $40 | $40 |
| Cache-Schreiben für 5 Minuten | $10 | $10 |
| Cache-Schreiben für 1 Stunde | $16 | $16 |
| Cache-Lesen | $0.20 | $0.20 |
Quellen: Anthropic-Preise, die Ofox-Modellseite und unser datierter Katalogabzug. Das Ofox-Repository definiert diese Katalogfelder in USD pro Token; für die Tabelle wurden sie mit einer Million multipliziert. Der Repository-Code liest dynamische Modelldaten aus. Der Git-Quelltext allein ist daher keine aktuelle Preisliste. Der 5.2-Abzug enthält kein separates provider_price-Objekt: Das bedeutet fehlende Lieferantenpreisdaten, nicht kostenlose Beschaffung oder einen bestätigten Rabatt.
Für eine beispielhafte Anfrage ohne Cache mit 20.000 Eingabe-Token und 4.000 abgerechneten Ausgabe-Token:
20,000 × $8 / 1,000,000 + 4,000 × $40 / 1,000,000 = $0.32Für eine beispielhafte Anfrage mit 19.000 aus dem Cache gelesenen Token, 1.000 nicht gecachten Eingabe-Token und derselben Ausgabe:
19,000 × $0.20 / 1,000,000 + 1,000 × $8 / 1,000,000
+ 4,000 × $40 / 1,000,000 = $0.1718
Das zweite Beispiel enthält die frühere Anfrage zum Schreiben des Caches nicht. Rechnen Sie sie hinzu, wenn Sie die gesamte Sitzung schätzen. Verwenden Sie überschneidungsfreie Eingabekategorien und zählen Sie Cache-Schreib-Token nicht nochmals als ungecachte Eingabe. Berücksichtigen Sie abgerechnete Reasoning-Ausgabe, Wiederholungen und separat berechnete Tools. Dies sind Berechnungen, keine beobachteten Rechnungen. Batch- und Fast-Mode-Tarife erfordern eigene Prüfungen von Berechtigung und Routing; hier werden sie nicht angewandt.
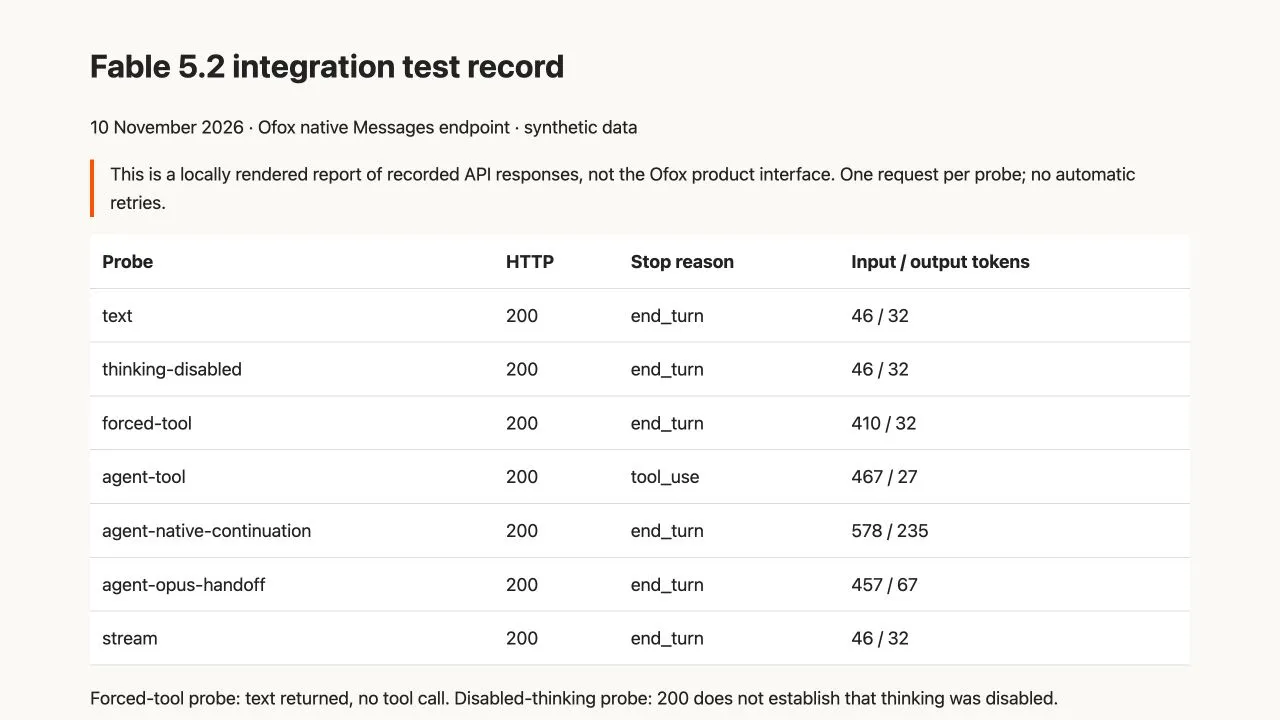
Englischsprachiger Screenshot unseres lokal dargestellten Testprotokolls mit Daten aus echten API-Antworten. Er zeigt keine Ofox-Produktoberfläche.
Entscheiden, ob die Integration einsatzbereit ist
Unsere weiteren Tests mit nativem Protokoll schlossen eine gestreamte Textantwort und einen vollständigen lesenden Tool-Ablauf ab. Zwei Tests mit absichtlich inkompatiblen Parametern lieferten ebenfalls 200: Einer sendete thinking: {"type":"disabled"}, der andere erzwang lookup_stock, während der Prompt eine Rechnung ohne Tools verlangte. Letzterer lieferte Text ohne Tool-Aufruf. Keine der Antworten belegt, dass diese Steuerungen funktionierten. Die routenspezifischen Ergebnisse im 400-Artikel erklären, warum Abnahmeprüfungen in der Anwendung nötig bleiben.
Vor einer Umstellung sollten vier Ergebnisse vorliegen: eine abgeschlossene Textanfrage, ein vollständiger Stream, ein lesender Tool-Ablauf mit korrekten IDs und eine wiederhergestellte mehrstufige Sitzung ohne veränderte Historie. Speichern Sie für jeden Fall Request-IDs, exaktes Modell, Effort, Verbrauch, Abbruchgrund, SDK-Version und Abnahmeergebnis.
Bei 400 prüfen Sie den Body, statt unverändert zu wiederholen. Bei Überlastung nutzen Sie begrenzte Wiederholungen und den englischen Claude-529-Leitfaden. Beim Modellwechsel halten Sie Anwendungsfakten getrennt von undurchsichtigen Reasoning-Inhalten vor; das zeigt die Checkpoint-Anleitung. Der Vergleich von 5.2, 5.1 und Opus 5.5 unterstützt die Kosten- und Migrationsentscheidung.
Weiterführende Dokumentation: API-Authentifizierung, native Messages und Anbieter-Routing. Klären Sie Anforderungen zur Datenaufbewahrung mit dem tatsächlich verarbeitenden Dienst: Anthropic dokumentiert modellspezifische Vorgaben für 5.2; ein Protokolleintrag bei Ofox ist keine Datenschutzgarantie.