Fable 5.2 API 怎么接?模型 ID、调用验证与费用计算
使用精确模型 ID 接入 Fable 5.2,发送原生请求、保存工具历史,并按输入、输出与缓存计算费用,区分目录支持与真实测试范围。
 Ofox
首次接入 Fable 5.2 时,先使用精确模型 ID 发出一个小请求,检查返回文本和停止原因,再添加工具或迁移已有会话。Ofox 的目录 ID 是 anthropic/claude-fable-5.2,Claude API 的 ID 是 claude-fable-5-2。两个 ID 要分别用于对应服务商的配置。
本文区分官方接口约定、Ofox 当前目录信息和应用侧验收。文档、目录及一次小规模原生协议 API 测试均于 2026 年 11 月 10 日核查。下方 cURL 请求体经过真实调用;SDK 片段用于说明等价接入方式,没有另外连接服务逐段实测。本文由 Ofox 发布,所介绍的网关也由 Ofox 提供。
端点和精确模型 ID 要配套
| 接入方式 | 模型 ID | 请求端点 |
|---|---|---|
| Claude API | claude-fable-5-2 | https://api.anthropic.com/v1/messages |
| Ofox,Anthropic 协议 | anthropic/claude-fable-5.2 | https://api.ofox.ai/anthropic/v1/messages |
| Ofox,兼容 OpenAI 的 Chat Completions | anthropic/claude-fable-5.2 | https://api.ofox.ai/v1/chat/completions |
官方概览列出的上下文窗口为 1M tokens,最大输出为 128K tokens。这是上限,不是建议的默认请求大小。先用简短、不含敏感信息的输入,并设置输出额度。
Ofox 模型页和公开目录列有 Anthropic、OpenAI 两种协议,5.2 当前列出的供应商类型为 aws_bedrock。协议标签不能证明每条路由都会透传所有 Anthropic beta 功能。在把某项功能作为依赖之前,应单独验证。
一个容易选错版本的地方:本次带日期的目录快照中,claude-fable-latest 仍属于 5.1 的别名。上线测试应使用精确的 5.2 ID,并记录响应模型与请求 ID,不要因为新版本发布就假设别名已经切换。
先发送一个小型原生请求
按 Ofox 鉴权说明创建 API Key,通过平时使用的密钥管理方式载入 OFOX_API_KEY。在服务端或本地开发机执行,不要把密钥放进公开发布的浏览器代码。下面的请求体刻意省略采样参数、强制工具选择和可选 beta 控制项。
curl --fail-with-body --max-time 180 \
  https://api.ofox.ai/anthropic/v1/messages \
  -H "x-api-key: $OFOX_API_KEY" \
  -H 'anthropic-version: 2023-06-01' \
  -H 'content-type: application/json' \
  --data '{
    "model": "anthropic/claude-fable-5.2",
    "max_tokens": 4096,
    "output_config": {"effort": "low"},
    "messages": [{
      "role": "user",
      "content": "A synthetic order contains 3 units at USD 12 each. Return the total and one calculation line. Do not use tools."
    }]
  }' > response.json
预期算术结果为 36 美元。真实响应给出了该金额和计算过程,状态为 HTTP 200、stop_reason: "end_turn",输入 46 tokens,输出 32 tokens。这一次合成输入请求只验证了这一具体情形,不能代表所有生产工作流。继续之前,先查看自己的 response.json。HTTP 成功并不说明模型一定返回了答案、遵循了任务,或在输出上限内完成了工作。
用这个小脚本检查响应,避免假定第一个内容块就是文本:
import json
from pathlib import Path

response = json.loads(Path("response.json").read_text())
if "error" in response:
    raise RuntimeError(response["error"])
text = "\n".join(
    block.get("text", "") for block in response.get("content", [])
    if block.get("type") == "text"
)
print("model:", response.get("model"))
print("stop_reason:", response.get("stop_reason"))
print("usage:", response.get("usage"))
print(text)
if response.get("stop_reason") != "end_turn" or not text.strip():
    raise SystemExit("Not a completed text answer; inspect before continuing.")
对于这个不调用工具的探测请求,应要求完整文本答案,并人工检查计算。在生产任务中,将人工检查替换为适合该输出的独立验证器。仅检查是否包含字符串 36 不够:“总额不是 36”同样包含它。
原生 Messages 文档说明了端点与鉴权格式。如果应用使用 Chat Completions,就应始终采用它的 messages、响应及工具结果格式。不要把原生 tool_result 块粘进 OpenAI 格式的对话,期待适配层自行重建原状态。
为思考和最终答案留足输出空间
Fable 5.2 始终启用自适应思考。output_config.effort 控制思考力度,不改变单个 token 的价格。这个小测试使用 low 来限制简单任务的投入,不代表复杂代码仓库修复或多阶段分析也应该用它。
处理实际工作时,先从模型文档中的默认值 high 开始,再用验收案例与低 effort 比较。Anthropic 的 effort 指南建议将较高档位用于额外思考确有帮助的任务。要测总 token 和完成情况,而不只是看回答是否漂亮。
max_tokens 同时覆盖思考和响应输出。因此上限过小可能只生成 thinking 块,随后以 stop_reason: "max_tokens" 停止,没有可见答案。这与 400 请求错误不同。先检查停止原因,再有针对性地提高额度或降低 effort。不要盲目重复相同上限的请求,再把这笔花费称为模型价格比较。
流式输出后保存完整最终消息
使用官方 Python SDK 时,流结束后要保留组装好的完整消息。以下模板适用于支持文档中 output_config 字段的较新 SDK;请记录并锁定应用实际验证过的 SDK 版本。
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["OFOX_API_KEY"],
    base_url="https://api.ofox.ai/anthropic",
    max_retries=0,
    timeout=180.0,
)
with client.messages.stream(
    model="anthropic/claude-fable-5.2",
    max_tokens=4096,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Calculate 3 times 12."}],
) as stream:
    for text in stream.text_stream:
        print(text, end="", flush=True)
    final_message = stream.get_final_message()
print(final_message.stop_reason, final_message.usage)
文本流用于界面展示,不等于后续工具轮次需要保存的完整消息。如果连接在完成前中断,将该次尝试标记为未完成,不要把部分可见文本保存成有效 assistant 响应。已有 thinking 签名排查文章解释了只采集文本会丢失哪些字段。
先接只读工具,再接有副作用的操作
一个合适的初始工具可以返回合成库存记录。定义 lookup_stock,输入 schema 要求字符串 SKU;将 tool_choice 设为 auto,让模型查询 DEMO-001。执行前按允许列表检查生成的工具名和参数。
若需要完整可执行版本,可下载只读库存运行脚本及其检查点模块。该版本定义 read_stock,一次读取三行测试数据,包含初始请求、工具验证、真实结果消息、续接及最终交接检查。逐步操作说明将本地检查与需要明确执行的付费调用分开说明。
使用原生协议时,原样追加返回的全部 assistant 内容,再追加包含真实结果和匹配工具 ID 的 user 消息:
# response is the completed SDK response; tool is one validated tool_use block.
messages.append({
    "role": "assistant",
    "content": [b.model_dump(exclude_none=True) for b in response.content],
})
messages.append({"role": "user", "content": [{
    "type": "tool_result",
    "tool_use_id": tool.id,
    "content": '{"sku":"DEMO-001","available":7,"source":"synthetic fixture"}'
}]})
此片段说明续接格式,不是完整的多工具运行器。若返回多个调用,应处理每个调用 ID,并报告各自的真实结果。工具失败需要返回错误结果,不能编造成功记录。缺少 tool_result 的排查指南解释配对错误;5.2 升级排查说明版本相关限制。
不要把 auto 理解成“工具一定执行”。当任务必须查库存,而模型只返回文本时,应用必须识别并拒绝将任务标记为完成。先用只读测试数据,避免调试重试导致重复下单或重复发送消息。
按不同 token 类别分别计算费用
以下为 11 月 10 日核查的标准费率,单位为美元/百万 tokens:
| 类别 | Claude API 公布费率 | Ofox 目录牌价 |
|---|---|---|
| 未缓存输入 | $8 | $8 |
| 输出 | $40 | $40 |
| 5 分钟缓存写入 | $10 | $10 |
| 1 小时缓存写入 | $16 | $16 |
| 缓存读取 | $0.20 | $0.20 |
来源为 Anthropic 定价、Ofox 模型页和带日期的目录快照。Ofox 仓库将这些目录字段定义为美元/token,表格将其乘以一百万。仓库代码读取动态模型数据,因此 Git 源码本身不是当前价表。5.2 快照没有独立的 provider_price 对象,这表示缺少供应商价格数据,不表示供应商成本为零,也不能据此认定存在折扣。
假设一个未缓存请求包含 20,000 个输入 tokens 和 4,000 个计费输出 tokens:
20,000 × $8 / 1,000,000 + 4,000 × $40 / 1,000,000 = $0.32若假设请求包含 19,000 个缓存读取 tokens、1,000 个未缓存输入 tokens,输出相同:
19,000 × $0.20 / 1,000,000 + 1,000 × $8 / 1,000,000
+ 4,000 × $40 / 1,000,000 = $0.1718
第二个例子未计入此前写入缓存的请求。估算整段会话时需加上那笔费用。输入类别必须互斥,不能将缓存写入 tokens 再作为未缓存输入重复计算。还要计入计费的推理输出、重试和单独收费的工具。这些是计算示例,不是实际账单。批量或快速模式的费率需要另查使用条件和路由,本例未采用。
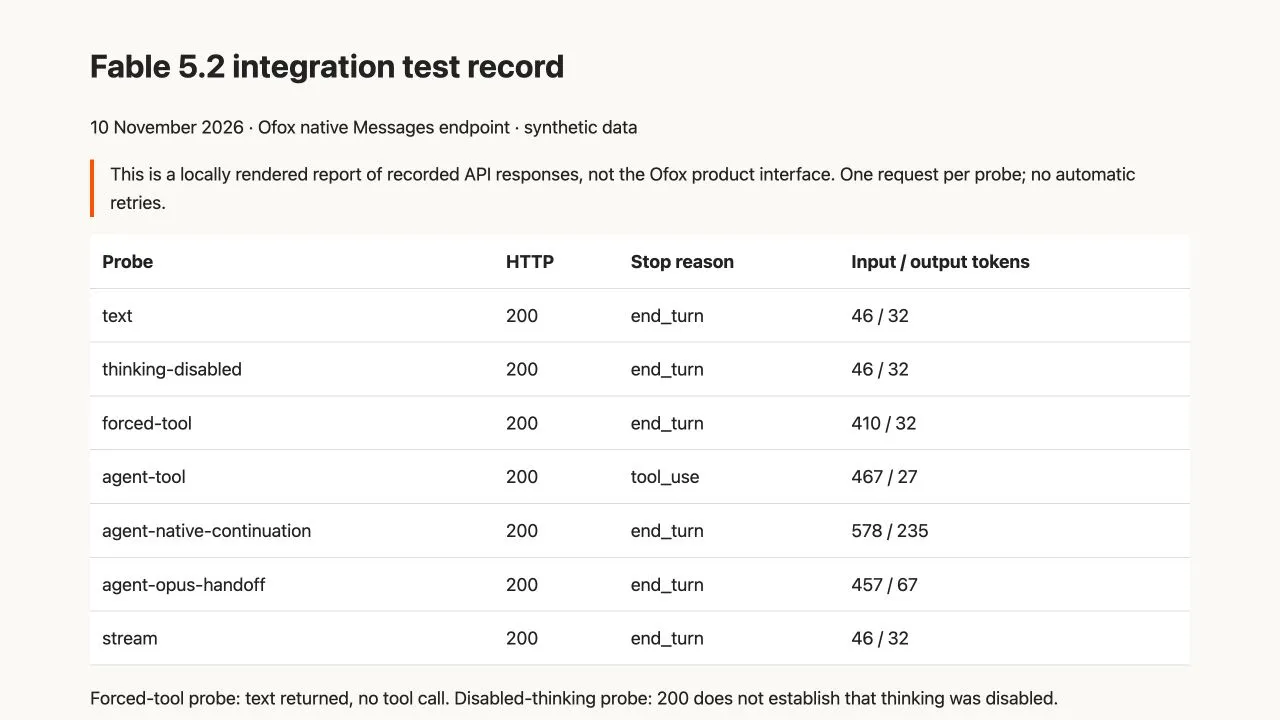
英文截图来自本地渲染的测试记录,数据取自真实 API 响应;不是 Ofox 产品界面截图。
判断接入是否可以投入使用
额外的原生协议测试完成了流式文本响应和一次只读工具往返。两个刻意携带不兼容参数的请求也返回 200:一个发送了 thinking: {"type":"disabled"},另一个强制选择 lookup_stock,但提示词要求不使用工具完成算术。后者只返回文本,没有工具调用。两种响应都不能证明对应控制项生效。400 文章中的路由实测结果解释了为什么仍需应用层验收。
迁移流量前,至少验收四种结果:完整文本请求、完整流式响应、ID 正确的只读工具往返,以及不改动历史的多轮会话恢复。每种情况都保存请求 ID、精确模型、effort、用量、停止原因、SDK 版本和验收结果。
遇到 400 时应诊断请求体,不要原样重试。遇到过载可限制重试次数,并参考 Claude 529 指南(英文)。切换模型时,按检查点教程将应用事实与不透明的推理内容分开保存。5.2、5.1 与 Opus 5.5 对比提供费用与迁移选择依据。
相关文档:API 鉴权、原生 Messages、供应商路由。数据保留要求应向实际处理数据的服务确认:Anthropic 对 5.2 规定了模型特定的保留要求,而 Ofox 的协议支持标签不是隐私保证。