OpenAI-kompatible APIs vor dem Anschluss an einen Agenten testen
Chat, JSON-Schema, vollständige Tool-Aufrufe, SSE-Abschluss und Fehler prüfen: mit Python-Testskript, lokalen Fehlerszenarien und einem echten Ofox-Testbericht.
 Ofox
Ein erfolgreicher Chat-Aufruf beweist nicht, dass eine OpenAI-kompatible API Ihren Agenten ausführen kann. Prüfen Sie die benötigten Operationen getrennt: strukturierte Ausgabe, vollständigen Tool-Zyklus, Abschluss eines Streams und verwertbare Fehler. Halten Sie Endpunkt und genaue Modell-ID fest. Kompatibilität betrifft einen bestimmten Request und dessen Antwort auf einer bestimmten Route, nicht sämtliche Fähigkeiten eines Anbieters.
Diese Anleitung enthält ein kleines Python-Prüfskript für Chat Completions. Es sendet höchstens sechs Requests ohne automatische Wiederholungen. Der Test ist von einer OpenCode-, Copilot- oder n8n-Konfiguration getrennt: zuerst die Route prüfen, anschließend den Client einrichten und ebenfalls testen. Ein Erfolg hier zertifiziert weder Responses noch Lastverhalten oder alle Parameter Ihrer Anwendung.
Prüfskript und Umfang verstehen
Laden Sie check_api.py herunter. Fünf Prüfungen benötigen sechs Requests, weil ein Tool-Zyklus aus einem ersten Modellaufruf und einem zweiten Aufruf mit dem Tool-Ergebnis besteht.
| Prüfung | Voraussetzung für PASS | Nicht dadurch belegt |
|---|---|---|
| Einfacher Chat | Geparste Chat-Completions-Antwort mit der verlangten kurzen Antwort | Tools, Streaming oder Bilderkennung |
| Strukturierte Ausgabe | Strict-Schema-Request akzeptiert; JSON erfüllt Schema und bekannte Werte | Alle JSON-Schema-Schlüsselwörter oder beliebige Extraktionsaufgaben |
| Tool-Zyklus | Richtige Funktion, Argumente und ID; lokales Ergebnis zurückgegeben; exakte Schlussantwort | Gestreamte Argumente, parallele Tools oder sichere entfernte Aktionen |
| Streaming | SSE-Inhaltstyp, lesbare Events, erwarteter Text, stop und [DONE] | Responses-Events oder Wiederverbindung |
| Validierungsfehler | Falscher Feldtyp führt zu HTTP 400/422 und einem JSON-Fehlerobjekt | Sämtliche Fehler, Wiederholungsregeln oder Abrechnung |
Der lokale Regressionstest ersetzt HTTP-Aufrufe durch feste Antworten. Er öffnet keine Sockets und benötigt keinen Schlüssel. Legen Sie ihn neben check_api.py, installieren Sie die unten genannten Abhängigkeiten und führen Sie beide Varianten aus:
python test_check_api.py
python -O test_check_api.py
Am 7. November 2026 lieferten alle neun Szenarien in beiden Modi das erwartete Ergebnis: gültiger Austausch, abgebrochener Stream, falsche Tool-Antwort, falscher Tool-Typ, ungültige Schemawerte, falsche Chat-Antwort, null-Inhalt, Authentifizierungsfehler und Rate Limit. Das sind lokale Tests des Prüfers, keine Modellaufrufe beim Anbieter. „Test bestanden“ bedeutet, dass tatsächlicher und erwarteter Status übereinstimmen; absichtlich beschädigte Antworten sollen gerade nicht überall PASS ergeben. Für einen Live-Nachweis brauchen Sie einen eigenen datierten Bericht mit Route, Modell und Nutzung.
Endpunkt und Kostenrahmen festlegen
Übernehmen Sie die dokumentierte API-Basisadresse. Aus einer Basis mit /v1 macht das Skript /v1/chat/completions. Übergeben Sie weder den vollständigen Chat-Completions-Pfad noch eine Modell-Detailseite. Prüfen Sie die Protokollunterstützung des Modells, bevor Sie Zugangsdaten untersuchen.
Für Ofox dienen die aktuelle API-Dokumentation und die Dokumentation des konkreten Modells als Ausgangspunkt. OpenAI-Kompatibilität bedeutet nicht Unterstützung jedes OpenAI-Endpunkts. Benötigt das Modell Responses für Tools, verwenden Sie die Responses-Migrationsanleitung (Englisch). Eine bloße URL-Änderung macht aus diesem Chat-Completions-Test keinen Responses-Test.
Wählen Sie ein günstiges, für Ihr Konto freigeschaltetes Modell, prüfen Sie den aktuellen Tarif und setzen Sie nach Möglichkeit ein kontoseitiges Ausgabenlimit. Das Skript verwendet synthetische Aufgaben und fordert ein kleines Ausgabetoken-Limit an. Ein Tokenparameter garantiert jedoch keine feste Dollargrenze. Anbieter können ihn ablehnen oder anders behandeln; auch Reasoning-Tokens werden unterschiedlich berücksichtigt. Kurze Prompts sind kein ausreichender Grund, ein teures Modell zu verwenden.
Standardmäßig heißt das Limitfeld max_completion_tokens. Dokumentiert der Anbieter für Ihr Modell max_tokens, ändern Sie den entsprechenden Parameter beim Aufruf. Ein abgelehntes Limitfeld kann auf eine abweichende API-Spezifikation hinweisen und beweist nicht, dass der Anbieter keine Texte generieren kann.
Einen kontrollierten Test installieren und ausführen
Verwenden Sie eine aktuelle Python-3-Umgebung mit unterstützter TLS-Bibliothek. Eine virtuelle Umgebung hält die Testabhängigkeiten von denen Ihrer Anwendung getrennt:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requests jsonschema
Setzen Sie LLM_API_KEY mit Ihrer üblichen lokalen Verwaltung von Zugangsdaten. Schreiben Sie den Schlüssel nicht in Kommandozeilenargumente, öffentliche Notebooks, Screenshots oder das heruntergeladene Skript. Nutzen Sie nach Möglichkeit einen zeitlich oder funktional begrenzten Schlüssel.
python check_api.py \
  --base-url https://api.example.com/v1 \
  --model YOUR_EXACT_MODEL_ID \
  --token-field max_completion_tokens \
  --max-output 256 \
  --out first-run.json
api.example.com und YOUR_EXACT_MODEL_ID sind Platzhalter für Ihre dokumentierte Route und Modell-ID. Das Skript verlangt HTTPS, außer bei ausdrücklich aktivierten lokalen Loopback-Tests. Redirects sind deaktiviert, damit eine falsche Adresse den Bearer-Schlüssel nicht unbemerkt weiterleitet. Ein vorhandener Ergebnisbericht wird nicht überschrieben; wählen Sie beim nächsten Lauf einen anderen Dateinamen.
Verbindungs- und Lese-Timeouts sind gesetzt. Zwischen vollständigen SSE-Zeilen wird zusätzlich ein ungefähres Zeitlimit geprüft. Das ist keine harte Gesamtlaufzeitgrenze: Ein Server, der langsam eine unvollständige Zeile liefert, kann das Lesen aktiv halten. Führen Sie das Beispiel interaktiv aus und brechen Sie einen festhängenden Request ab. Für unbeaufsichtigtes Produktionsmonitoring fehlen ein echtes Prozess-Zeitlimit und Grenzen für die Antwortgröße.
Ergebnisse als Belege statt als Punktzahl lesen
PASS bedeutet, dass die Antwort diese konkrete Prüfung erfüllt. FAIL bedeutet Ablehnung oder Verletzung einer erwarteten Bedingung. UNKNOWN steht für Transportprobleme oder unerwartete Strukturen, die keine belastbare Entscheidung erlauben. Lesen Sie Details und HTTP-Status, bevor Sie etwas ändern.
Ein Netzwerkausfall belegt keine fehlende Tool-Unterstützung. HTTP 401 ist kein JSON-Schema-Fehler. HTTP 429 beim absichtlich ungültigen Request beweist keine Typprüfung, weil der Server bereits vor der Validierung abbrechen kann. Der Prüfer akzeptiert deshalb Authentifizierungs- und Rate-Limit-Fehler nicht als erfolgreichen Validierungsfehlertest.
Rechnen Sie die fünf Labels nicht zu „80 Prozent kompatibel“ zusammen. Ein Agent mit zwingendem Tool-Bedarf kann eine Route nicht nutzen, nur weil vier andere Tests bestanden wurden. Notieren Sie für Ihre Anwendung, welche Operationen erforderlich und welche optional sind.
Ein echter Lauf mit sechs Ofox-Requests
Am 7. November 2026 lief das Skript gegen https://api.ofox.ai/v1 mit der im Konto verfügbaren Modell-ID openai/gpt-6-luna und max_completion_tokens: 256. Es gab sechs Requests einschließlich des absichtlich ungültigen Requests und keine Wiederholung. Der tatsächliche JSON-Bericht enthält Laufzeiten und zurückgemeldete Nutzung.
| Prüfung | Beobachtung |
|---|---|
| Chat | PASS: verlangte Antwort und normaler Abschluss |
| Strukturierte Ausgabe | PASS: Schema sowie SKU und Menge stimmen |
| Tool-Zyklus | PASS: zweite Antwort exakt 17 |
| Streaming | PASS: Text, Abschlussgrund und [DONE] vorhanden |
| Ungültiger Parameter | PASS: HTTP 400 mit JSON-Fehlerobjekt |
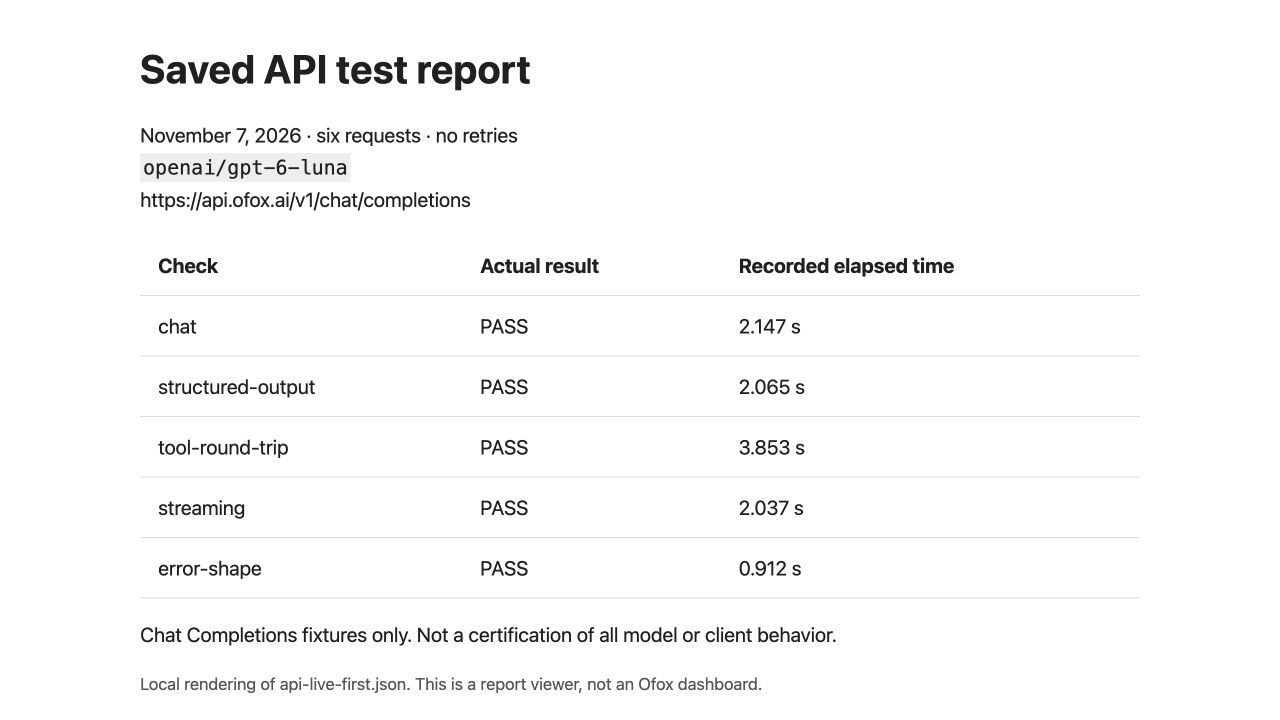
Der Screenshot zeigt eine lokale Darstellung der gespeicherten JSON-Datei, kein Ofox-Dashboard und keinen zusätzlichen Live-Test. Englische Prüfbezeichnungen bleiben passend zum Skript erhalten. Die deutsche Fassung beschreibt denselben Lauf und keine gesonderte Sprachprüfung.
Die Ergebnisse gelten für dieses Modell, diese Route und diese Aufgaben zum Testzeitpunkt. Sie beweisen weder interne Strict-Schema-Durchsetzung noch Unterstützung aller Modelle, Responses, gestreamter Tool-Argumente, Fallbacks oder zusätzlicher Clientfelder. HTTP 400 ist hier der erwartete Testausgang, kein Dienstausfall.
Warum das Tool-Ergebnis zurück an das Modell muss
tool_calls bestätigt nur die erste Hälfte des Ablaufs. Die Anwendung muss den Aufruf validieren, ein erlaubtes Tool ausführen und das Ergebnis mit der passenden Call-ID zurückgeben. Die zweite Modellantwort muss dieses Ergebnis korrekt verwenden.
Der Test bietet genau eine lokale Leseoperation: lookup_stock. Die synthetische SKU 000102 liefert den festen Bestand 17. Vor der Rückgabe prüft das Skript Typ, Funktionsname, JSON-Argumente und ID; danach muss die Schlussantwort exakt 17 lauten. Es führt keine Shellbefehle oder beliebige vom Modell vorgeschlagene Funktionen aus.
Funktioniert der erste Aufruf, aber der zweite nicht, prüfen Sie Ergebnisnachricht und Call-ID, statt sofort das Modell zu wechseln. 170 ist falsch, auch wenn die Zeichenfolge „17“ darin vorkommt. Explizite Validierungsausnahmen bleiben auch bei optimiertem Python aktiv.
Validieren Sie in echten Anwendungen Argumente gegen Ihr Schema, begrenzen Sie Operationen und prüfen Sie Berechtigungen vor der Ausführung. Ein syntaktisch gültiger Tool-Aufruf autorisiert keine E-Mail, Zahlung oder Datenbankänderung.
Gültiges JSON von einer gelösten Aufgabe unterscheiden
Die Aufgabe verlangt {"sku":"000102","quantity":3}. Das Schema fordert eine SKU als String, eine ganzzahlige Menge, beide Felder und keine weiteren Eigenschaften. Erst prüft das Skript das Schema, dann die bekannten Werte. Eine passende Antwort beweist keine serverseitige Strict-Durchsetzung: Das Modell könnte sie auch erzeugen, wenn das Gateway das Feld ignoriert.
JSON kann lesbar sein und trotzdem Nullen verlieren. Der Typ kann stimmen, der Wert aber falsch sein. Ein Anbieter kann normales JSON akzeptieren und eine strikte Schemaanfrage ablehnen. Bewahren Sie den exakten Request auf, statt strict für ein grünes Ergebnis stillschweigend zu entfernen.
Die OpenAI-Dokumentation zu strukturierten Ausgaben (Englisch) trennt strukturierte Antworten von Funktionsaufrufen. Richten Sie sich nach der Spezifikation Ihres Endpunkts; ein Feld aus einem anderen API-Format zu kopieren ist kein sinnvoller Kompatibilitätstest. Für echte Extraktion folgt ein Dokument mit bekannter Lösung und die Text-zu-JSON-Prüfung (Englisch). Ein winziges festes Schema ist nur ein erster Test.
Das Ende eines Streams kontrollieren
Ein Stream kann Text anzeigen und dennoch unvollständig sein. Das Skript liest SSE-Events, kombiniert Textdeltas, protokolliert den Abschlussgrund und verlangt das Chat-Completions-Signal [DONE]. Ein abgebrochener Stream fällt durch, auch wenn sein Anfang plausibel aussieht.
Das ist die Erwartung dieses Profils, keine Regel für jede API. Responses verwendet andere Events. Auch Nutzungsdaten am Streamende unterscheiden sich. Das Skript fordert stream_options nicht an; fehlende Stream-Nutzung wird dokumentiert, aber allein nicht als Fehler gewertet. Falls Abrechnung oder Monitoring davon abhängen, testen Sie die dokumentierte Nutzungsoption separat.
Wiederholen Sie nach einem Abbruch nicht blind einen Ablauf, der bereits Nebenwirkungen ausgelöst haben könnte. Prüfen Sie zuerst ausgeführte Tools und Folgeschritte. Die Codex-Stream-Fehlersuche (Englisch) behandelt einen konkreten Clientfehler; ein Netzwerk-Retry garantiert keine sichere Fortsetzung.
Fehler auf der richtigen Ebene beheben
| Beobachtung | Zuerst untersuchen |
|---|---|
| Alle Requests liefern 401/403 | Schlüssel, Kontozugang und Endpunktberechtigung |
| 404 oder model-not-found | URL, genaue Modell-ID und Verfügbarkeit; Modellfehler prüfen (Englisch) |
| Chat funktioniert, Strict-Schema nicht | Dokumentiertes Antwortformat und erlaubte Schemas |
| Tool-Request wird sofort abgelehnt | Protokoll, Modellfähigkeit und Felder |
| Rückgabe des Tool-Ergebnisses scheitert | Call-ID, Nachrichtenverlauf und Ergebnisformat |
| Text kommt, Abschluss fehlt | SSE-Framing, Proxy-Pufferung, Verbindungsende und falsches Profil |
| n8n-Zugangstest klappt, Workflow nicht | Tatsächlich verwendeten Endpunkt prüfen; n8n-Diagnose (Englisch) |
Nach bestandenen Pflichtprüfungen konfigurieren Sie den OpenCode-Anbieter (Englisch) oder Ihren Client und wiederholen eine kleine Aufgabe dort. Der Client kann zusätzliche Felder senden. Halten Sie beide Ergebnisse fest, statt vom direkten API-Test automatisch auf die Anwendung zu schließen.
Entfernen Sie vor dem Teilen private Endpunktnamen, Request-IDs und Kontoinhalte. Der Beispielbericht enthält nur synthetische Ergebnisse, Modell, Zeiten, Status und Nutzung, keinen Schlüssel. Bewahren Sie bei Modell- oder Routenwechseln neue datierte Belege auf. Das ist aussagekräftiger als ein allgemeines Kompatibilitätslabel.