Ofox에서 Nano Banana 2.1로 이미지 생성·저장·편집하기
Ofox에서 Nano Banana 2.1을 호출하고 이미지를 저장한 뒤 연속 편집하는 방법. Python 코드, 실제 API 응답과 제한 사항을 확인합니다.
 Ofox
2026년 10월 13일 업데이트. Ofox는 이 가이드를 게시한 곳이자 여기서 설명하는 요청에 사용한 API 게이트웨이입니다. 이 글은 AI의 도움을 받아 작성하고 실제 API 및 도구 결과를 대조했으며, 게시 전에 다른 AI가 독립적으로 검토했습니다. 아래에서 다루는 이미지 요청 여섯 건은 Ofox를 통해 네이티브 Gemini 프로토콜로 실제 전송한 요청입니다. 예제 프로그램은 직접 요청을 실행할 수 있도록 제공한 것이며, 가능한 모든 경로나 설정을 테스트했다는 뜻은 아닙니다.
Nano Banana 2.1의 Ofox 모델 ID는 google/gemini-nano-banana-2.1입니다. 여기서 비교 대상으로 사용한 이전 모델의 ID는 google/gemini-3.1-flash-image이며, 흔히 Nano Banana 2라고 부릅니다. 요청을 이전할 때 이전 모델의 ID를 그대로 사용하지 마세요. Ofox 공개 모델 페이지는 2.1이 Gemini 및 OpenAI 프로토콜을 지원한다고 안내하고, 제공업체를 Vertex로 표시합니다. 이 가이드에서 실제 작동을 확인한 요청은 OpenAI 호환 경로가 아닌 네이티브 Gemini generateContent 경로를 사용합니다.
포스터를 생성하고 반환된 이미지 바이트를 디스크에 저장한 다음, 선택적으로 모델의 전체 응답을 두 차례의 편집 요청에 전달합니다. 별도의 업로드 옵션을 사용하면 기존 로컬 이미지를 입력할 수 있습니다. 편집과 레이아웃 선택을 더 자세히 살펴보려면 포스터 편집 가이드를 참고하세요.
첫 요청 전에 필요한 것
모델을 사용할 수 있는 Ofox API 키, 충분한 계정 잔액, Python 3, requests 패키지가 필요합니다. 의존성을 설치하고 셸에서 키를 설정하세요.
python -m pip install requests
export OFOX_API_KEY="YOUR_OFOX_API_KEY"
키를 소스 파일, 스크린샷, 공유 로그에 노출하지 마세요. 검증된 요청에서 사용한 API 엔드포인트는 다음과 같습니다.
POST https://api.ofox.ai/gemini/v1beta/models/google/gemini-nano-banana-2.1:generateContent
x-goog-api-key: YOUR_OFOX_API_KEY
아래 요청은 텍스트와 이미지 응답 모달리티를 모두 지정하고, 정사각형 화면 비율과 이미지 크기 1K를 요청합니다. Google 이미지 생성 문서는 1K, 2K, 4K 옵션을 설명하지만, 이 글에서 게이트웨이를 통해 실행해 확인한 것은 1K뿐입니다. 해당 문서를 특정 경로에서 모든 크기를 테스트했다는 근거로 해석하지 마세요. 이 모델에서 문서화된 크기 옵션에는 512가 없습니다.
완성된 Python 프로그램
이 코드를 nano21.py라는 이름으로 저장하세요. 기본 실행은 생성 요청 한 건을 보냅니다. --chain을 사용하면 생성 요청을 보낸 뒤 테스트에서 사용한 두 가지 편집 프롬프트를 그대로 전송합니다. --upload PATH를 사용하면 지정한 로컬 이미지를 입력으로 삼아 헤드라인 수정 프롬프트와 함께 새 요청을 시작합니다. 이 프롬프트가 의미를 갖도록 원본 포스터 이미지를 사용하세요. 두 옵션은 함께 사용할 수 없습니다.
import argparse
import base64
import binascii
import json
import mimetypes
import os
from pathlib import Path
import sys

import requests


URL = (
    "https://api.ofox.ai/gemini/v1beta/models/"
    "google/gemini-nano-banana-2.1:generateContent"
)

PROMPTS = [
    "Create a square minimalist event poster on warm cream paper. Large exact headline: ORCHARD MARKET. Smaller exact line: SATURDAY 10 AM. Draw three red apples in a blue ceramic bowl below the text. No other text, no logos, no border.",
    "Change only the headline from ORCHARD MARKET to ORCHARD FAIR. Keep SATURDAY 10 AM exactly unchanged. Preserve the three red apples, blue bowl, cream background, composition and all other pixels as closely as possible.",
    "Now change only the bowl from blue to dark green. Preserve ORCHARD FAIR, SATURDAY 10 AM, the three red apples and the layout.",
]

EXTENSIONS = {
    "image/png": ".png",
    "image/jpeg": ".jpg",
    "image/webp": ".webp",
    }


def send(contents, api_key):
    body = {
        "contents": contents,
        "generationConfig": {
            "responseModalities": ["TEXT", "IMAGE"],
            "imageConfig": {
                "aspectRatio": "1:1",
                "imageSize": "1K",
            },
        },
    }
    try:
        # Deliberately one attempt: image requests are not automatically retried.
        response = requests.post(
            URL,
            headers={"x-goog-api-key": api_key},
            json=body,
            timeout=(15, 180),  # connection timeout, then read timeout
        )
    except requests.RequestException as exc:
        raise RuntimeError(f"Request failed before a usable response: {exc}") from exc

    try:
        data = response.json()
    except ValueError as exc:
        raise RuntimeError(
            f"HTTP {response.status_code}; non-JSON response: "
            f"{response.text[:1000]}"
        ) from exc

    if not response.ok:
        error = data.get("error", data) if isinstance(data, dict) else data
        raise RuntimeError(
            f"HTTP {response.status_code}; API error: "
            f"{json.dumps(error, ensure_ascii=False)[:2000]}"
        )
    if not isinstance(data, dict):
        raise RuntimeError("Successful HTTP response was not a JSON object.")
    return data


def save_response(data, output_dir, turn_number):
    candidates = data.get("candidates") or []
    if not candidates or not isinstance(candidates[0], dict):
        raise RuntimeError(f"No candidate returned: {json.dumps(data)[:2000]}")

    candidate = candidates[0]
    finish_reason = candidate.get("finishReason")
    if finish_reason not in (None, "STOP"):
        raise RuntimeError(
            f"Generation did not finish normally ({finish_reason}): "
            f"{json.dumps(candidate, ensure_ascii=False)[:2000]}"
        )

    # Keep this original object intact for the next turn. In particular, do not
    # rebuild its parts from printed text and saved image files.
    content = candidate.get("content")
    if not isinstance(content, dict):
        raise RuntimeError("First candidate has no content object.")

    output_dir.mkdir(parents=True, exist_ok=True)
    image_count = 0
    for part in content.get("parts", []):
        if "text" in part and part["text"]:
            print(f"text: {part['text']}")

        inline = part.get("inlineData")
        if not inline:
            continue
        mime = inline.get("mimeType", "").split(";", 1)[0].lower()
        if not mime.startswith("image/"):
            continue
        encoded = inline.get("data")
        if not isinstance(encoded, str):
            raise RuntimeError("Image part has no base64 string.")
        try:
            image_bytes = base64.b64decode(encoded, validate=True)
        except (binascii.Error, ValueError) as exc:
            raise RuntimeError("Image part contains invalid base64.") from exc
        if not image_bytes:
            raise RuntimeError("Image part decoded to zero bytes.")

        image_count += 1
        extension = EXTENSIONS.get(mime, ".bin")
        path = output_dir / f"turn-{turn_number}-image-{image_count}{extension}"
        path.write_bytes(image_bytes)
        print(f"saved image: {path} ({mime})")

    if not image_count:
        raise RuntimeError(
            "Response contained no image inlineData; inspect the returned "
            "candidate and any text instead of treating text as an image."
        )
    if "usageMetadata" in data:
        print("usageMetadata:", json.dumps(data["usageMetadata"]))

    return content


def uploaded_image_part(path):
    mime, _ = mimetypes.guess_type(path.name)
    if mime not in EXTENSIONS:
        raise ValueError("Upload a .png, .jpg, .jpeg, or .webp image.")
    image_bytes = path.read_bytes()
    if not image_bytes:
        raise ValueError("Upload file is empty.")
    return {
        "inlineData": {
            "mimeType": mime,
            "data": base64.b64encode(image_bytes).decode("ascii"),
        }
    }


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--chain", action="store_true")
    parser.add_argument("--upload", type=Path)
    parser.add_argument("--output-dir", type=Path, default=Path("outputs"))
    args = parser.parse_args()
    if args.chain and args.upload:
        parser.error("--chain and --upload are separate workflows")

    api_key = os.environ.get("OFOX_API_KEY")
    if not api_key:
        parser.error("Set OFOX_API_KEY in the environment first")

    if args.upload:
        if not args.upload.is_file():
            parser.error(f"Image file does not exist: {args.upload}")
        # A new conversation with an uploaded image, not the earlier
        # generation/edit conversation.
        contents = [{
            "role": "user",
            "parts": [
                uploaded_image_part(args.upload),
                {"text": PROMPTS[1]},
            ],
        }]
        result = send(contents, api_key)
        save_response(result, args.output_dir, 1)
        return

    contents = []
    selected_prompts = PROMPTS if args.chain else PROMPTS[:1]
    for turn_number, prompt in enumerate(selected_prompts, start=1):
        contents.append({"role": "user", "parts": [{"text": prompt}]})
        result = send(contents, api_key)
        model_content = save_response(result, args.output_dir, turn_number)
        # Preserve the full returned content, including inline image data,
        # text, and any signatures on parts, for the next request.
        contents.append(model_content)


if __name__ == "__main__":
    try:
        main()
    except (OSError, ValueError, RuntimeError) as exc:
        print(f"error: {exc}", file=sys.stderr)
        sys.exit(1)
한 번 요청하려면 python nano21.py를 실행하세요. 세 차례 요청을 모두 실행하려면 python nano21.py --chain을 실행합니다. 디스크에 있는 포스터를 새 대화에서 편집하려면 python nano21.py --upload outputs/turn-1-image-1.png를 실행하세요. 이는 위 파일을 실행하는 Python 명령 예시이지, Ofox 전용 CLI 명령이 아닙니다.
이미지가 포함된 응답에서는 saved image: outputs/turn-1-image-1.png (image/png) 형태의 줄과 반환된 텍스트 및 usageMetadata를 볼 수 있습니다. 이 줄은 출력 형식의 예시일 뿐, 이 스크립트를 별도로 실행한 결과를 옮긴 기록은 아닙니다. 실제 검증한 포스터 요청은 HTTP 200과 STOP을 반환했고, 1024 × 1024 PNG 이미지를 포함했습니다. 보고된 토큰 사용량은 입력 토큰 54개, 텍스트 출력 토큰 80개, 이미지 출력 토큰 1,120개, 추론 토큰 639개였습니다. 원시 응답에는 눈에 보이는 텍스트 부분이 없었지만, TEXT 출력 토큰은 80개로 보고되었습니다. 이 수치는 눈에 보이는 문장이 아니라 반환된 사용량 메타데이터로 취급하세요. 실제로 반환되는 텍스트, 메타데이터, 처리 시간, 이미지는 달라질 수 있습니다.
이 코드는 첫 번째 후보의 모든 이미지 inlineData 부분을 저장하므로, 첫 부분이 반드시 이미지라고 가정하지 않습니다. 응답 MIME 유형에 따라 파일 확장자를 선택하며, 인식할 수 없는 이미지 MIME 유형은 PNG로 잘못 표시하지 않고 .bin으로 저장합니다. HTTP 오류는 가능한 경우 JSON으로 파싱하며, 이미지가 없는 응답은 성공이 아닌 실패로 처리합니다. 자동 재시도는 의도적으로 넣지 않았습니다. 시간 초과 뒤 요청을 무작정 반복하면 이미지가 하나 더 생성되어 추가 요금이 발생할 수 있습니다. 요청이 실패하면 다시 제출할지 결정하기 전에 상태 코드, 오류 JSON, 계정 상태를 확인하세요. Google 문제 해결 가이드는 Gemini 측 오류 범주를 해석하는 데 도움이 되지만, Ofox 게이트웨이의 응답은 그 자체로 확인해야 합니다.
편집 대화 기록에 전체 응답이 필요한 이유
저장된 PNG는 결과물입니다. 대화 기록을 대신할 수는 없습니다. --chain 작업 흐름에서 다음 요청에는 앞선 사용자 입력 다음에 모델이 반환한 candidates[0].content 전체를 넣고, 그 뒤에 새로운 사용자 입력을 추가합니다. 이 콘텐츠에는 텍스트, 인라인 이미지 데이터, 각 부분의 추론 서명이 포함될 수 있습니다. 이미지 파일과 화면에 보이는 텍스트만으로 내용을 재구성하면 유효한 후속 요청에 필요한 데이터가 누락될 수 있습니다.
이 때문에 업로드 경로는 의도적으로 별도로 구성했습니다. --upload는 로컬 파일의 MIME 유형과 base64 바이트를 포함하는 inlineData 부분을 지시문과 함께 전송합니다. 업로드한 파일을 이전 모델 대화의 한 차례인 것처럼 취급하거나, 그 파일의 서명을 재구성하지는 않습니다. 다른 제품 보존 작업 방식은 마스크를 사용해 제품 보존하기와 장면 참조 이미지 한 장과 두 장 비교를 참고하세요.
“바꾸는 부분은 이것뿐”이라는 지시는 강력한 편집 요청이지, 픽셀을 고정하는 기능은 아닙니다. 세 단계 테스트에서 2.1과 이전 모델은 모두 첫 포스터에 요청한 영문 헤드라인과 시간을 표시했습니다. 편집 요청에서는 두 모델 모두 헤드라인을 ORCHARD FAIR로 바꾸면서 SATURDAY 10 AM, 빨간 사과 세 개, 파란 그릇을 유지했습니다. 세 번째 요청에서는 두 모델 모두 그릇을 짙은 녹색으로 바꾸고 요청한 문구를 유지했습니다. 어느 출력에서도 편집 가능한 레이어가 제공되지는 않았습니다. 또한 “테두리 없음”이라고 지시했지만 두 모델의 구도 모두 바깥 여백과 그림자가 있는 종이 위에 포스터를 배치했습니다. 특히 정확한 문구, 제품 세부 정보, 레이아웃이 중요하다면 편집 결과를 수락하기 전에 실제 반환 이미지를 확인하세요.
테스트는 동일한 프롬프트와 1K, 1:1 설정을 사용해 모델마다 세 단계 체인을 한 번씩 실행했으며, 시드나 추론 수준은 지정하지 않았습니다. 여섯 요청 모두 HTTP 200과 STOP을 반환했고, 결과는 1024 × 1024 PNG였습니다. 이 테스트는 반복적인 신뢰성 검증이나 종합적인 품질 순위 평가가 아닙니다. 모델마다 기본값이 다를 수도 있습니다. 아래 이미지는 Playground 실행 화면의 스크린샷이 아니라 API 요청의 결과입니다.
| 단계 | Nano Banana 2.1 | 이전 Nano Banana 2 |
|---|---|---|
| 포스터 | 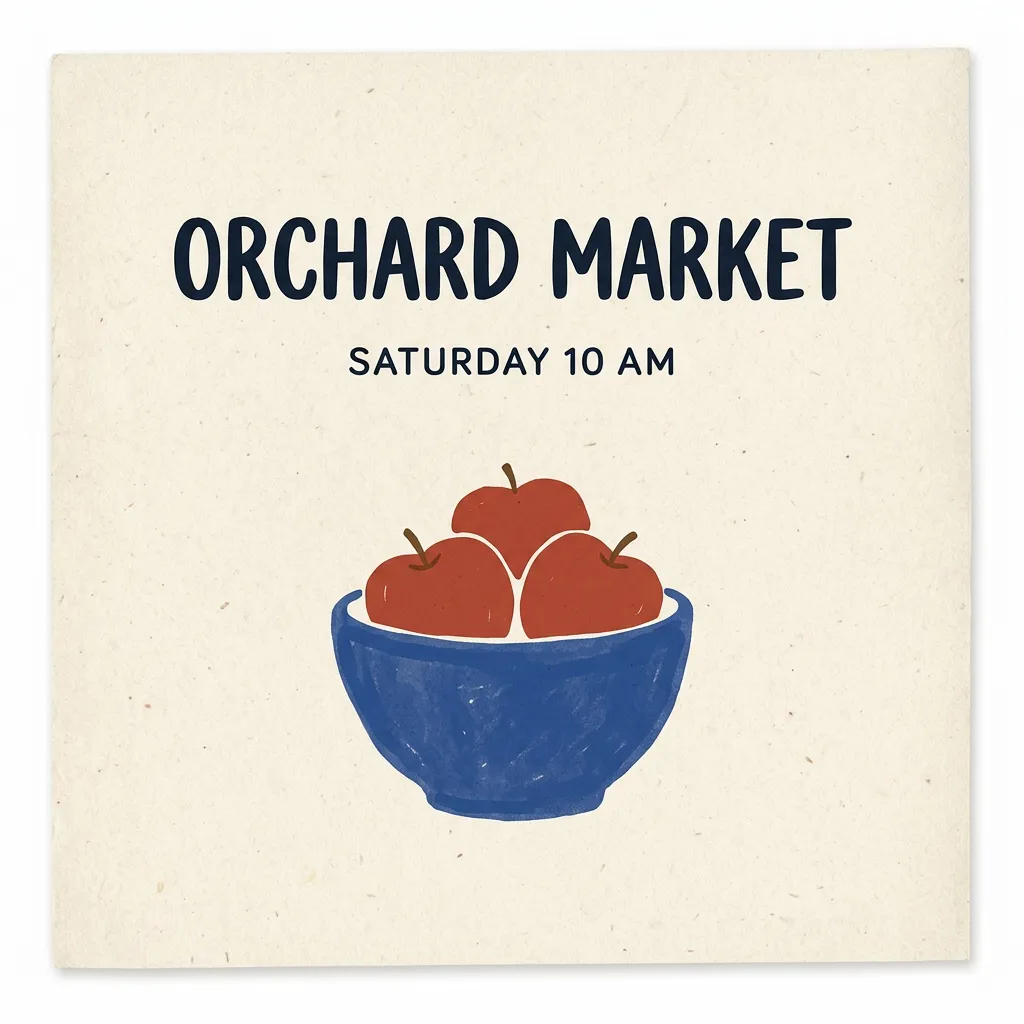 | 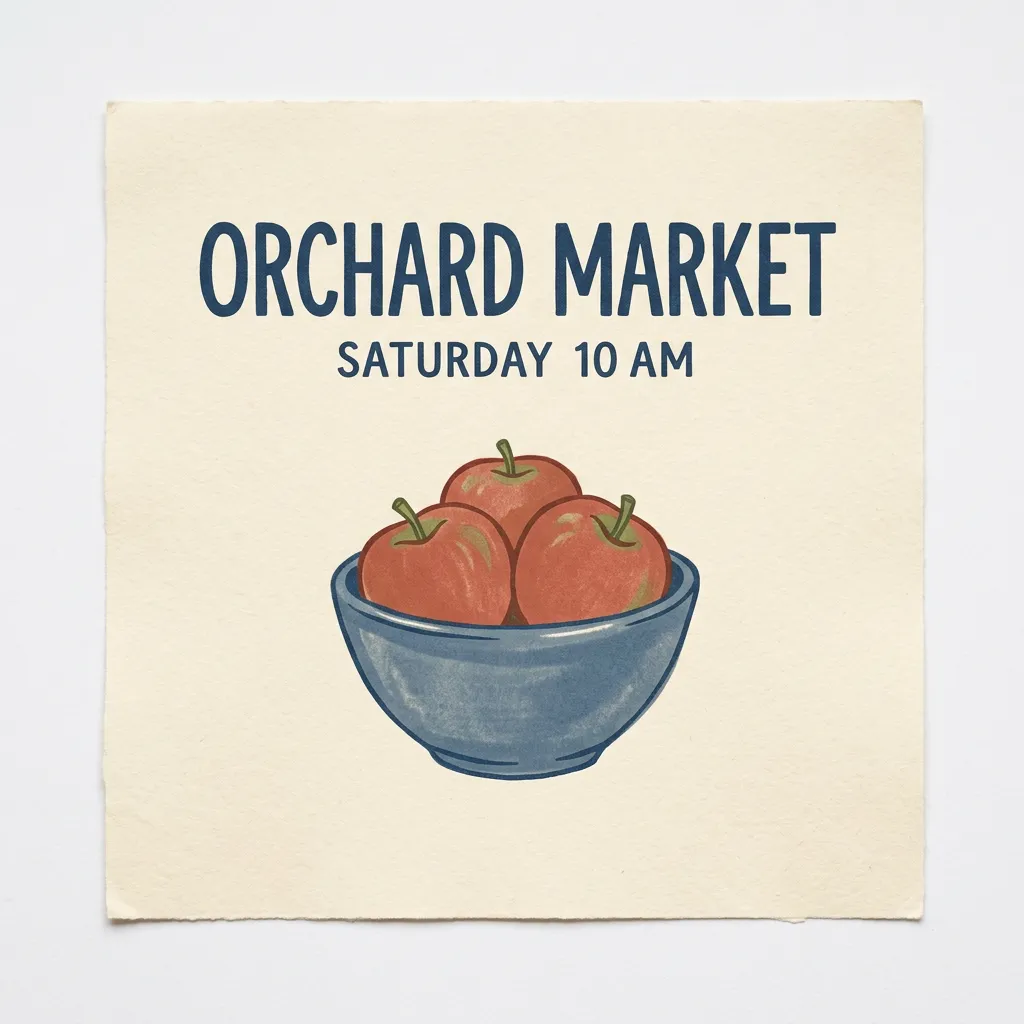 |
| 헤드라인 편집 | 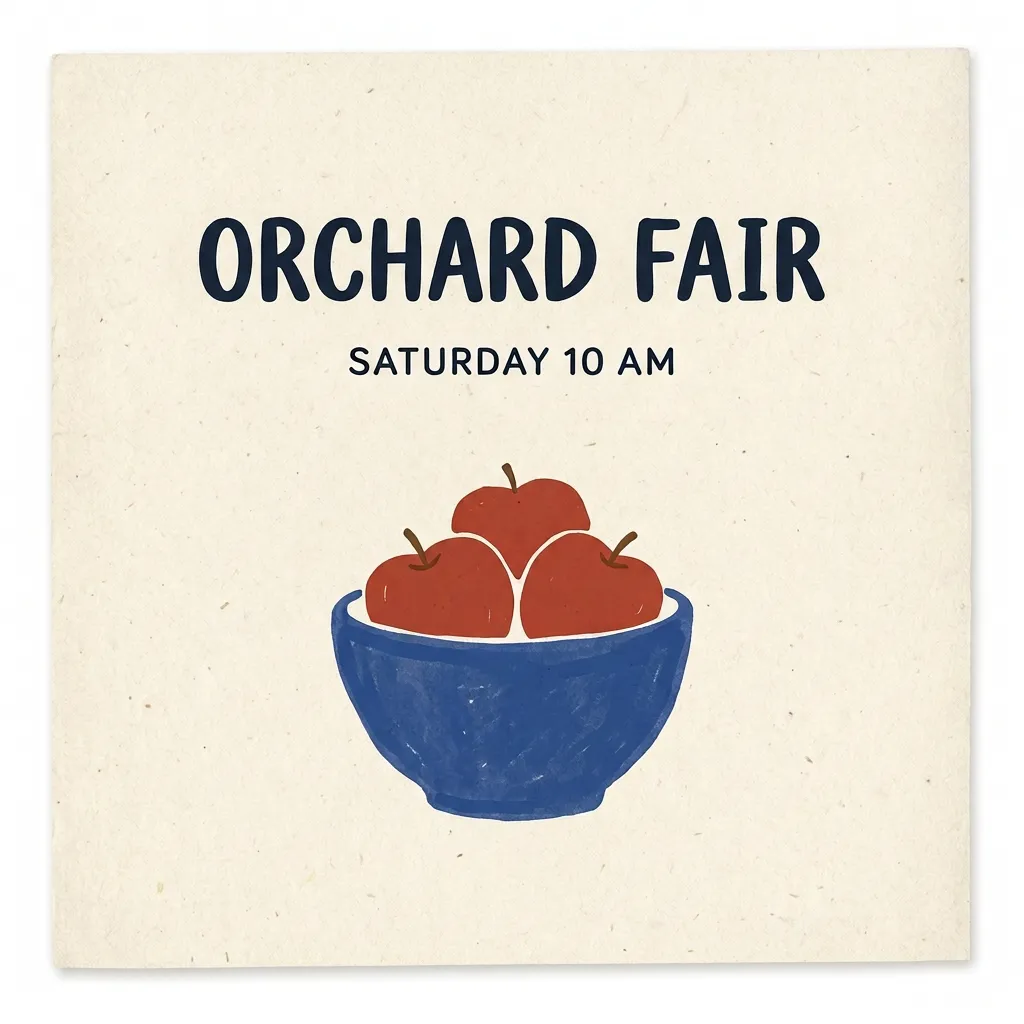 | 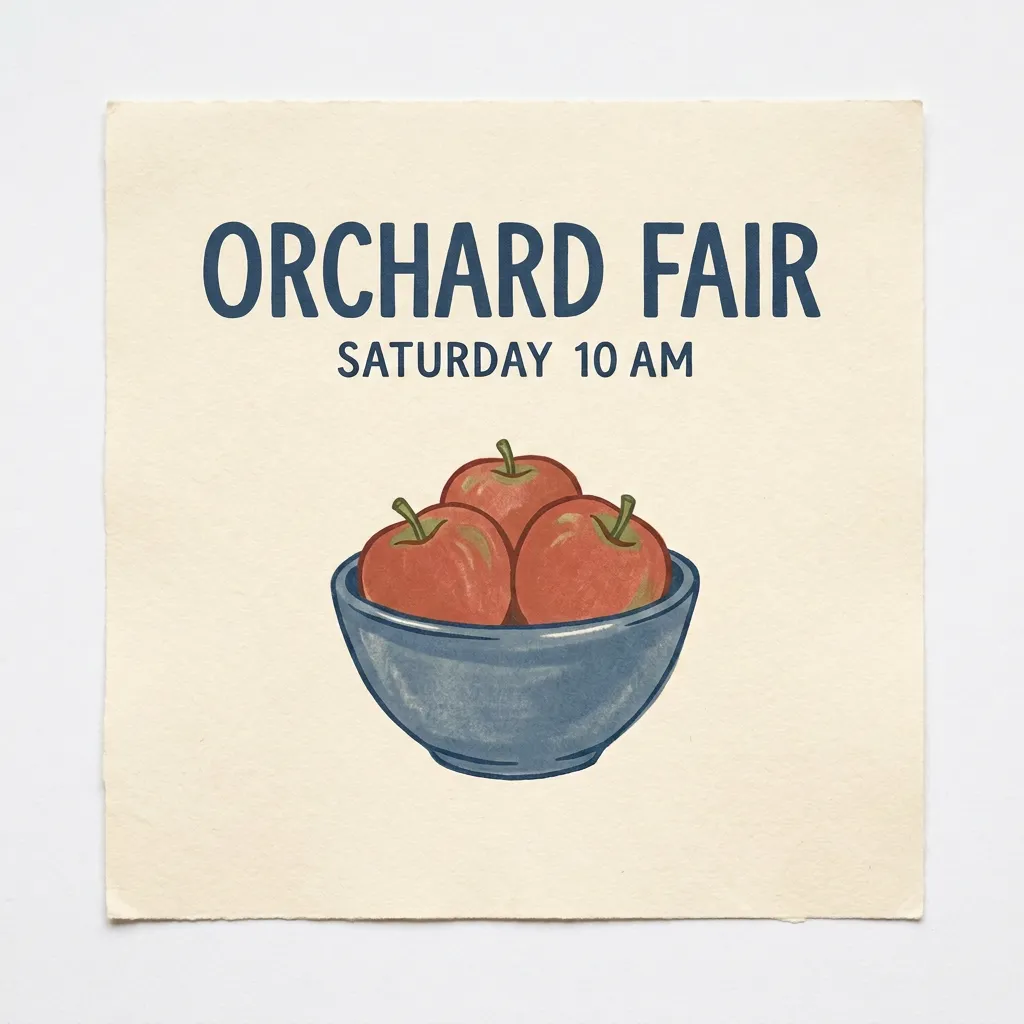 |
| 그릇 편집 | 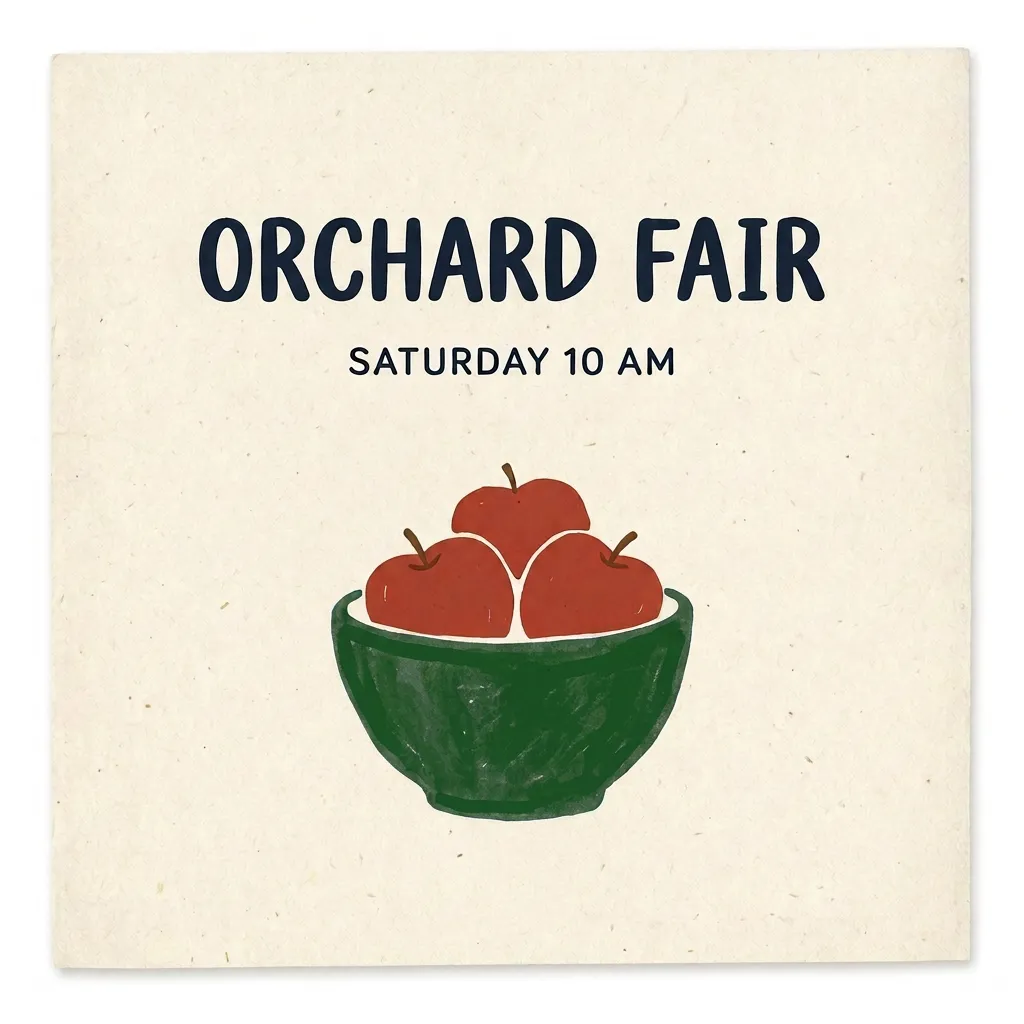 | 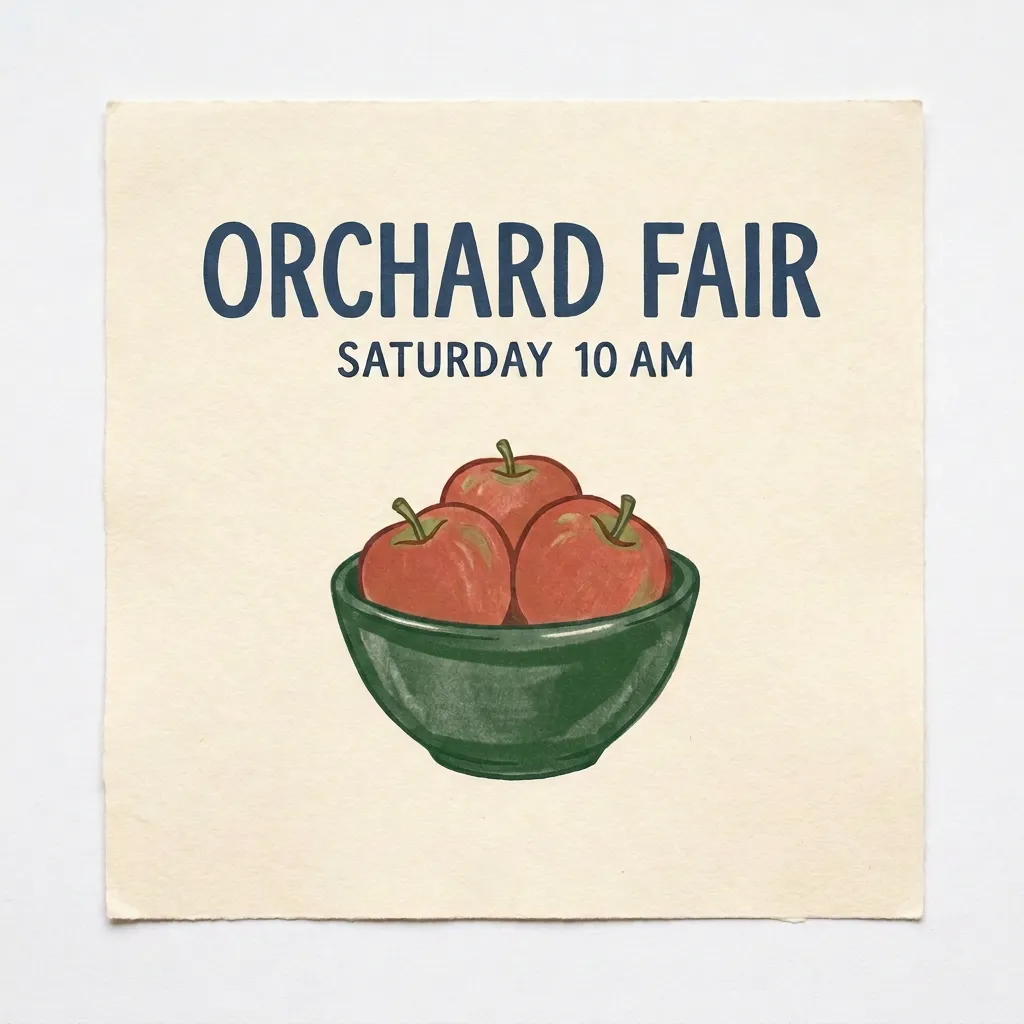 |
다운로드 가능한 비교 자료 묶음에 관련 파일이 들어 있습니다. 기존 연동을 옮기는 중이라면 2.1과 2 비교에서 관찰된 동작과 전반적인 마이그레이션 판단을 구분해 살펴보세요.
공개 모델 페이지와 인증된 API 실행은 다릅니다
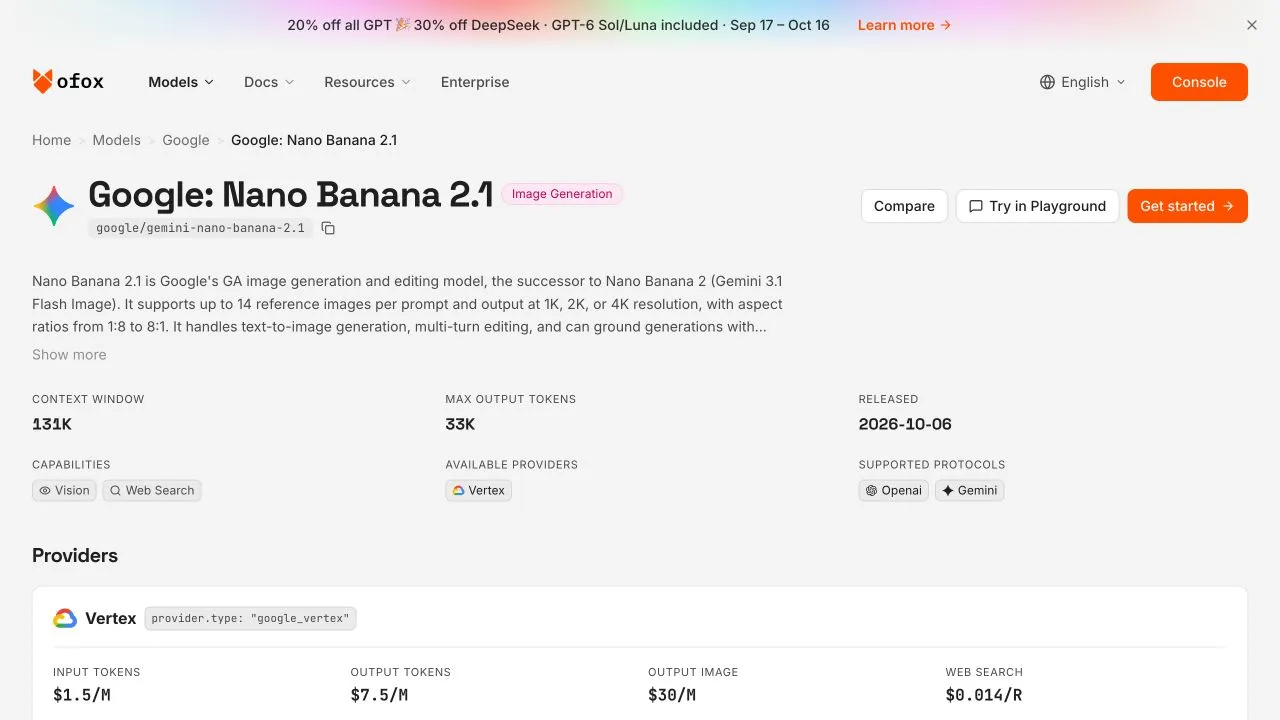
이 스크린샷은 모델 정보, 프로토콜, 요금과 Playground 진입 버튼을 보여 줍니다. 열린 Playground의 입력 항목이나 해당 인터페이스에서 생성한 결과를 보여 주는 것은 아닙니다.
모델 페이지에는 프롬프트 입력란, 첨부 기능, 후속 요청 기능이 있는 내장 Playground가 표시됩니다. Playground를 사용하려면 로그인해야 합니다. 화면 비율에 관한 안내에는 요청한 비율이 가능한 한 맞추지만 보장되지는 않는다고 명시되어 있으므로, UI에서 비율을 선택했다고 해서 모든 결과에서 그 비율이 보장된다고 해석해서는 안 됩니다. 이 가이드에서는 인증된 Ofox Agent 인터페이스를 테스트했다거나 Agent가 반드시 2.1을 선택한다고 주장하지 않습니다. 재현 가능한 연동이 필요하다면 위 예시처럼 정확한 모델 ID를 사용하고 API 응답을 확인하세요.
이전 작업 전 확인할 사항: 한도와 비용
google/gemini-3.1-flash-image에서 google/gemini-nano-banana-2.1로 ID를 바꾸는 일은 단순히 이름을 고치는 작업이 아닙니다. 응답 파서, 이미지 크기 선택, 출력 토큰 한도, 텍스트 또는 추론 관련 출력에 대한 가정을 점검하세요. 측정한 포스터 요청에서 2.1은 이전 모델의 포스터 응답에 보고되지 않았던 텍스트 출력 및 추론 토큰을 보고했습니다. 보고되지 않은 항목이 사용량 0을 뜻하지는 않습니다. 동일한 프롬프트를 사용해도 사용량이나 기본값이 같다고 보장할 수 없습니다. 이전 모델의 계산 방식을 그대로 적용하지 말고 전체 응답을 보존해 반환된 사용량을 기록하세요.
현재 공개 카탈로그 스냅샷에는 2.1의 요금이 입력 토큰 100만 개당 $1.50, 텍스트 출력 토큰 100만 개당 $7.50, 이미지 출력 토큰 100만 개당 $30으로 표시되어 있습니다. 웹 검색 요금은 별도의 요청당 항목입니다. 이전 모델에 표시된 요금은 다릅니다. 이 수치는 카탈로그에서 확인한 내용이지, 검증된 청구서나 생성 이미지 한 장당 고정 요금이 아닙니다. Google의 요금 페이지에도 2.1의 1K 출력에 이미지 토큰 1,120개가 표시되어 있지만, 공개된 Google 자료마다 4K 이미지 토큰 수치는 다릅니다. 여기서는 게이트웨이를 통해 4K 실행을 하지 않았습니다. 배치 작업의 예상 비용을 계산하거나 이미지 토큰 요금이 낮으면 전체 요청 비용도 낮아진다고 가정하기 전에 요금 분석을 참고하세요.
Google의 모델 문서는 여러 이미지 참조를 포함한 기능을 설명하고, 이미지 생성 가이드는 이미지 설정을 다룹니다. 공식 문서에 기능이 기재되어 있다고 해서 이 Ofox 경로에서 모든 설정, 참조 이미지 수, 해상도를 실행해 봤다는 뜻은 아닙니다. 특히 Vertex 기반 모델에서 작동할 것이라는 가정만으로 검증되지 않은 시드, temperature 또는 topP 조정 방법을 이 요청에 추가하지 마세요.
마지막으로 생성 오류 진단과 사용 권한은 별개의 문제입니다. 이미지가 없는 응답이나 요청 오류가 발생하면 실제 JSON과 상태 코드를 확인하세요. 자세한 내용은 이미지가 반환되지 않는 오류 가이드를 참고하세요. 게시하거나 상업적으로 사용할 때는 제공한 이미지에 필요한 권리가 있는지 확인하고 적용되는 Gemini 약관을 따르세요. SynthID 관련 정보는 눈에 보이는 워터마크, 소유권, 독점성, 비침해 또는 기밀 데이터 보호를 보장하지 않습니다.