Как резюмировать длинный PDF по частям и сохранить ссылки на страницы
Разбейте PDF на проверяемые части, сохраните исходную нумерацию и учтите поправки. Пример на 24 страницах, скрипт и проверка пропусков в резюме.
 Ofox
Если PDF нельзя надёжно обработать за один проход, разделите его на именованные части, извлеките доказательства из каждой и объедините их до написания резюме. Разрезать файл недостаточно: нужно знать, какие исходные страницы получил ассистент, какие факты сохранились и заменяет ли поздняя поправка прежний ответ.
Здесь используются небольшой авторский отчёт на 24 страницах и локальный скрипт разделения. Файл намеренно прост для проверки. Он демонстрирует учёт страниц и противоречащих редакций, но не доказывает, что 24 страницы превышают контекст модели, и не измеряет качество запоминания длинного контекста.
Сначала определите, какое ограничение сработало
«Слишком длинный» может означать разные проблемы. Загрузка отклоняется из-за размера файла; в скане нет извлекаемого текста; запрос превышает допустимый вход; ответ обрывается из-за малого выходного лимита. Инструмент может принять PDF, но использовать поиск фрагментов, поэтому нельзя считать, что весь документ попал в один запрос к модели.
Исправления различаются. Сжатие изображений уменьшает байты, но не обязательно извлечённый текст. Просьба сократить резюме меняет выход, а не обязательно вход. Новое имя модели не исправит маршрут загрузки, который не принимает PDF.
Посмотрите точную ошибку, возможность поиска текста, число страниц и заданную задачу. Записывайте модель и дату: лимиты и поддерживаемые входы меняются. Объяснение контекстного окна отделяет контекст от ограничения ответа. Не вычисляйте жёсткий токеновый предел, умножая мегабайты или страницы на универсальную константу.
Возьмите документ с известным ответом
Скачайте отчёт на 24 страницах, скрипт разделения и эталонные факты. Последний файл не передавайте ассистенту до оценки извлечения.
На странице 1 указан начальный бюджет USD 120 000, на странице 12 — запуск 15 декабря 2026 года. Страница 17 меняет дату, страница 22 — бюджет. Страница 9 прямо обозначена как намеренно пустая, кроме идентифицирующей заметки. Это позволяет различать «проверено, существенного содержания нет» и «не обработано».
Нужный результат — таблица решений с текущими датой и бюджетом, прежними значениями и исходными страницами, а также условием, способным заблокировать пилот. Гладкий обзор без поправок задачу не решает. Денежные суммы остаются в USD, без перевода в рубли.
Создайте манифест охвата до отправки
Для упражнения используйте Python 3 и PyMuPDF в отдельном окружении:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install pymupdf
python split_report.py sample-project-report.pdf report-batches \
  --max-pages 6 --max-chars 12000
Скрипт создаёт новую папку, четыре PDF, четыре текстовых файла и manifest.json. Можно скачать готовые части упражнения: их создал скрипт, не модель. Существующая папка не переиспользуется, чтобы не подменить предыдущий тест. Каждая текстовая страница начинается с имени источника и исходного номера. Манифест хранит SHA-256 оригинала, общее число страниц и распределение по частям.
Предел символов управляет процессом, но не является токенизатором. Шесть страниц выбраны для удобства проверки. Настройте оба ограничения под модель, плотность содержания и объём ответа. Если одна страница превышает цель по символам, скрипт отмечает её как слишком большую, а не молча обрезает. Разделите её по смысловым разделам и оставьте исходную страницу у каждого фрагмента.
Проверка скрипта подтверждает, что каждая исходная страница назначена один раз. Это охват файлов, не доказательство прочтения моделью. Дальше нужны результаты по частям и итоговая сверка.
Проверьте страницы без текста и с неверным порядком чтения
Страница без извлечённого текста получает needs-visual-review-or-OCR, а не автоматически статус пустой. Там может быть скан таблицы, схема или рукописная заметка. Откройте оригинал, определите значимость и передайте изображение или OCR через подходящий интерфейс.
Документация PyMuPDF (на английском) описывает извлечение текста и OCR как отдельные операции. Наш начальный скрипт только извлекает текст; он не запускает OCR автоматически и не обещает понимания диаграмм. Даже текстовый PDF может иметь неверный порядок чтения. Проверяйте колонки, сноски и таблицы на отрисованной странице.
Если таблица пересекает границу, перенесите разрез к естественному завершению или явно включите соседнюю страницу повторно. Запишите перекрытие в манифесте и удаляйте повторные доказательства по странице и факту, не по общему сходству предложений. Предоставленный скрипт делает неперекрывающиеся группы страниц и не определяет автоматически границы таблиц или разделов.
Извлекайте доказательства отдельно по каждой части
Для задач с важной вёрсткой используйте PDF части; для текстового маршрута — размеченный текст. Сохраняйте результаты так, чтобы было понятно, к какой части относится каждый из них. Приложите нужную часть и manifest.json либо вставьте её карту страниц в запрос. Например, часть 3 содержит исходные страницы 13–18: её пятая страница — исходная 17. В текстовом файле исходные номера уже отмечены. JSON с эталонным ответом не прикладывайте.
В ассистенте с поддержкой файлов, например Ofox Chat проверьте вложение и опирайтесь на карту оригинала, а не счётчик разделённого PDF. Для каждой части используйте следующий промпт. Английский оригинал сохранён для повторения:
Read only this attached batch of the synthetic project report.
The supplied manifest maps batch pages to original PDF pages.

Return two tables:
1. Coverage: every assigned original page, status (reviewed, no relevant
   content, unreadable, or missing), and a short reason.
2. Evidence: decision/risk, exact value or date, approval/effective date
   if stated, original source page, a short supporting excerpt, and whether
   the source says it supersedes another value.

Extract the pilot launch date, budget, blocking dependencies and their
amendments. Preserve old and new values; do not silently reconcile them.
Do not guess facts from another batch. A blank page is reviewed only after
you inspect it. Report unreadable pages and missing attachments explicitly.
Do not use web sources or invent page references.
Сохраняйте каждый ответ с номером части. Один итоговый абзац не оставляет материала для сверки, если модель пропустила страницу. Для конфиденциальных отчётов отправляйте только разрешённые к обработке материалы и уберите ненужные чувствительные разделы.
Объедините доказательства до написания текста
Когда у четырёх частей появятся таблицы, объедините их, а не просите модель помнить четыре длинных разговора. Для каждого подтверждённого утверждения сохраните отдельную запись. Принимайте новое значение только если документ устанавливает замену прежнего: одной хронологии не всегда достаточно.
Merge these four evidence tables for the same source report.
For each current decision, retain the earlier value, the amendment,
approval date, original pages and supporting excerpts. Mark unresolved
conflicts instead of choosing silently. Identify missing batch outputs.

Produce:
- A current-decisions table.
- A superseded-values table.
- A page coverage table for original pages 1 through 24.
- A short summary supported only by the reconciled evidence.
List any claim that still requires checking against the original PDF.
В образце текущая дата запуска — 12 января 2027 года: страница 17 явно заменяет страницу 12. Текущий бюджет — USD 135 000: страница 22 заменяет страницу 1. На странице 8 сказано, что проверка безопасности поставщика должна завершиться до начала пилота. Держите ссылки рядом с утверждениями.
Не подставляйте известные ответы в запрос извлечения, чтобы затем объявить их найденными моделью. Они нужны только для оценки. При ошибке сохраните первый результат, а исправление покажите отдельно.
Проверьте три вида полноты
Охват входа: все 24 исходные страницы распределены, все ожидаемые части существуют. Успешная загрузка не доказывает обработку каждого файла.
Охват обработки: каждый ответ перечисляет назначенные страницы, включая отсутствие существенного содержания на странице 9. Самоотчёт полезен для учёта, но недостаточен как доказательство. Проверьте содержимое самостоятельно.
Полнота ответа: итог содержит нужные дату, бюджет и зависимость с верными поправками и страницами. Сверяйте начало, середину и конец, а не только первый абзац. В настоящих документах проверьте также важное исключение, о котором не спрашивали: резюме могло скрыть ограничение.
Упражнение пройдено, только если совпадают все три уровня. Счётчик 24/24 с устаревшей датой — ошибка ответа. Верная дата со ссылкой на выдуманную страницу 25 — тоже ошибка.
Что дал реальный тест четырёх частей
7 ноября 2026 года мы приложили четыре разделённых PDF и manifest.json к одному разговору Ofox Chat, без эталона и полного оригинала. Запрос требовал сначала отдельный лист доказательств каждой части, затем объединение решений, строку на каждую исходную страницу, цитаты, прежние значения и лист исключений. Это один разговор с четырьмя подготовленными частями, а не четыре изолированных сеанса и не испытание максимального контекста. Запуск был на английском; перевод не означает новый русский тест.
Скачайте полученные в этом запуске книгу проверки и отчёт решений в Markdown. В книге четыре листа частей и Coverage, Decisions, Exceptions.
| Критерий | Наблюдение, проверенное независимо |
|---|---|
| Исходные страницы | Ровно одна строка на каждую страницу 1–24, без пропусков и повторных ID |
| Подтверждающие выдержки | Все 29 цитат совпали с указанными страницами после нормализации пробельных символов |
| Поправка даты | 12 января 2027 на странице 17; прежнее 15 декабря 2026 со страницы 12 сохранено |
| Поправка бюджета | USD 135 000 на странице 22; прежние USD 120 000 со страницы 1 сохранены |
| Проверка безопасности | Предусловие со страницы 8 сохранено; завершение осталось неизвестным |
| Страница 9 | Учтена как не содержащая существенных сведений, а не молча пропущена |
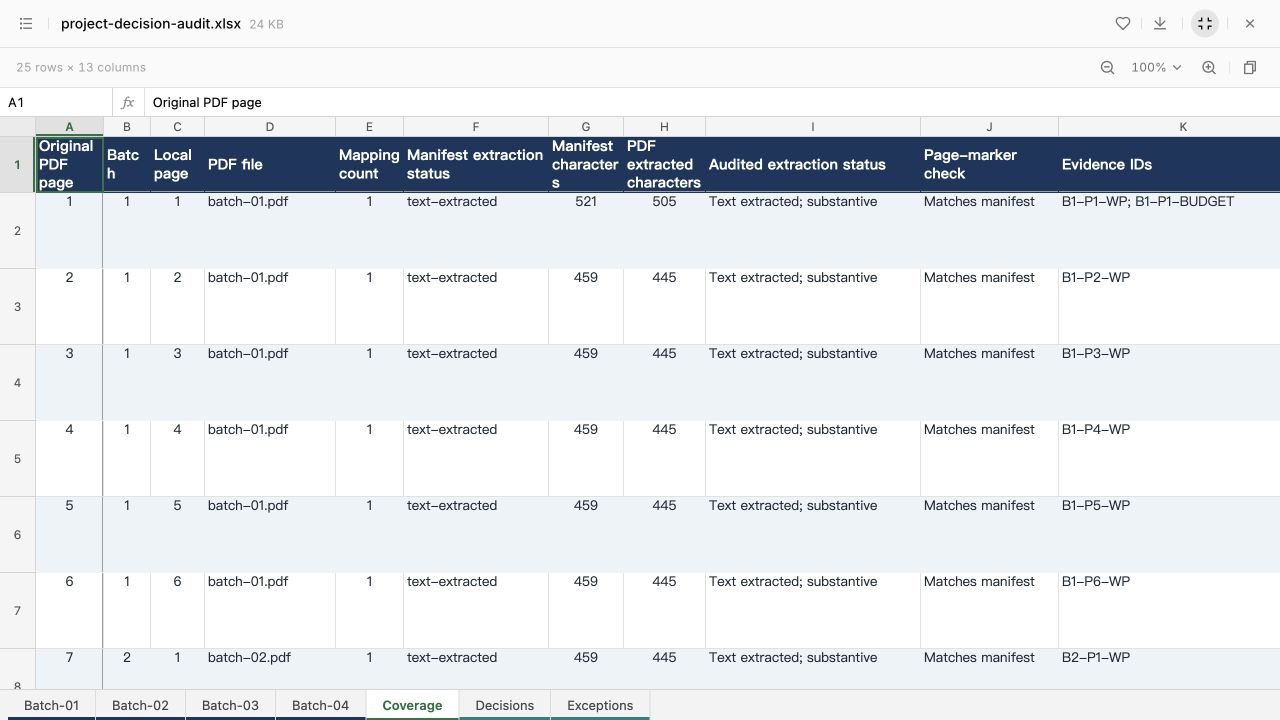
Модель отметила два ограничения аудита. Она не могла проверить хеш полного PDF, потому что его не приложили; позднее мы сверили его локально с оригиналом. Число извлечённых символов отличалось от манифеста на всех страницах. Мы воспроизвели причину: подготовка считает get_text(sort=True).strip(), а значения аудита соответствовали get_text() без удаления крайних пробелов. Различия в порядке текста и пробельных символах меняют счётчики без потери страниц. Исходное предупреждение сохранено: мы не переписали его так, будто модель сама решила эту проблему.
Расхождение требует расследования, а не автоматического удаления или общего вердикта о провале. Записывайте метод извлечения и согласуйте нормализацию перед сравнением чисел. Проверяйте цитируемый текст отдельно: одинаковые счётчики тоже не доказывают правильного понимания.
В образце короткие доступные для поиска страницы с явными поправками. Он показывает происхождение фактов и сверку, но не надёжное чтение любого длинного, сканированного или сложного отчёта. Если полномочия на утверждение поправки неясны, оставьте эту неопределённость в таблице решений.
Восстановите результат без повторения всей обработки
| Ошибка | Адресное восстановление |
|---|---|
| Отсутствует целая часть | Обработать её и заново объединить доказательства |
| Факт верен, номер страницы неверен | Открыть источник и исправить карту исходных страниц |
| В итоге старый бюджет | Передать обе строки доказательств и текст поправки, сохранив заменённую сумму |
| В сканированной странице нет текста | Отрисовать её или выполнить OCR и добавить с прежним исходным ID |
| Ответ оборвался | Отметить незавершённость, уменьшить часть или объём ответа и повторить её |
| Запрос объединения стал слишком большим | Сначала собрать таблицы по разделам со ссылками, затем объединить их; сохранить оригиналы |
Полезный запрос на исправление указывает, какой факт или ссылку нужно перепроверить: «Перепроверь исходную страницу 17 и её указание о странице 12; обнови дату запуска, а старую сохрани в таблице заменённых значений». У фразы «сделай резюме точнее» нет проверяемой цели.
Передайте результат, который сможет проверить коллега
Храните вместе оригинал, его хеш, манифест, результаты частей, объединённые доказательства, итог и открытые вопросы. При экспорте отчёта в PDF используйте проверку скачанного результата (на английском), а не только предпросмотр. Для нескольких независимых документов есть отдельный процесс сравнения нескольких PDF.
Начните с упражнения в Ofox Chat и сохраняйте столбец источника в каждой редакции. Цель не просто вместить файл в запрос, а оставить достаточно доказательств, чтобы коллега проверил ответ без повторения всей работы.