Lange PDFs abschnittsweise zusammenfassen und Quellen nachvollziehbar halten
Eine PDF in nachvollziehbare Pakete teilen, Originalseiten erhalten und Änderungen abgleichen. Mit 24-seitiger Beispieldatei, Skript und geprüftem Ergebnis.
 Ofox
Lässt sich eine PDF nicht zuverlässig in einem Durchgang verarbeiten, teilen Sie sie in eindeutig bezeichnete Pakete, extrahieren pro Paket Belege und führen diese vor dem Schreiben der Zusammenfassung zusammen. Das Aufteilen allein genügt nicht. Sie müssen nachvollziehen können, welche Originalseiten verarbeitet wurden, welche Fakten erhalten blieben und ob spätere Änderungen frühere Aussagen ersetzen.
Diese Anleitung enthält einen selbst erstellten Bericht mit 24 kurzen Seiten und ein lokales Aufteilungsskript. Er lässt sich bewusst leicht prüfen und demonstriert Seitenverfolgung sowie widersprüchliche Revisionen. Er belegt nicht, dass 24 Seiten ein Kontextfenster überschreiten, und ist kein Benchmark für das Erinnerungsvermögen bei langen Kontexten.
Vor dem Aufteilen die tatsächliche Grenze feststellen
„Zu lang“ kann eine Dateigrößengrenze beim Upload, fehlenden Text in einem Scan, zu viel Modelleingabe oder ein zu kleines Ausgabebudget bedeuten. Eine Oberfläche kann die Datei auch annehmen und nur ausgewählte Stellen per Retrieval weitergeben. Eine erfolgreiche Annahme beweist daher nicht, dass das ganze Dokument in einem einzelnen Modellrequest steckt.
Die Abhilfen unterscheiden sich. Bildkompression reduziert Bytes, aber nicht unbedingt extrahierten Text. Eine kürzere gewünschte Zusammenfassung verkleinert die Ausgabe, nicht automatisch die Eingabe. Ein anderer Modellname repariert keinen Upload-Endpunkt, der PDFs ablehnt.
Notieren Sie den genauen Fehler, die Durchsuchbarkeit, Seitenzahl und gewünschte Aufgabe. Halten Sie bei einem Diensttest Modell und Datum fest; Grenzen können sich ändern. Die Erklärung zum Kontextfenster (Englisch) trennt Kontext- und Ausgabelimits. Rechnen Sie Megabytes oder Seiten nicht mit einer universellen Konstante in eine harte Tokengrenze um.
Ein Dokument mit bekannten Referenzwerten verwenden
Laden Sie den 24-seitigen Projektbericht, das Aufteilungsskript und die Referenzfakten herunter. Die Referenz gehört erst zur Auswertung, nicht in den Extraktionsauftrag.
Seite 1 nennt zunächst 120.000 USD Pilotbudget, Seite 12 den Starttermin 15. Dezember 2026. Seite 17 ändert den Termin, Seite 22 das Budget. Seite 9 ist laut Hinweis bis auf ihre Kennzeichnung absichtlich leer. Damit lässt sich unterscheiden zwischen „geprüft, ohne relevante Inhalte“ und „nicht verarbeitet“.
Die gewünschte Ausgabe ist eine Entscheidungstabelle mit aktuellem Termin und Budget, früheren Werten, Quellseiten und einer möglicherweise blockierenden Abhängigkeit. Eine flüssig formulierte Übersicht ohne die Änderungen löst diese Aufgabe nicht.
Vor dem Hochladen eine Seitenübersicht erzeugen
Verwenden Sie Python 3 und PyMuPDF in einer isolierten Umgebung:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install pymupdf
python split_report.py sample-project-report.pdf report-batches \
  --max-pages 6 --max-chars 12000
Das Skript erstellt ein neues Verzeichnis, vier Paket-PDFs, vier Textdateien und manifest.json. Alternativ gibt es die vorbereiteten Pakete. Sie wurden vom Skript, nicht von einem Modell erzeugt. Ein vorhandenes Zielverzeichnis wird abgelehnt, damit frühere Tests erhalten bleiben. Jede Textseite beginnt mit Quelldatei und Originalseitennummer. Das Manifest enthält Quell-SHA-256, Seitenzahl und die Zuordnung der Originalseiten.
Die Zeichengrenze steuert den Ablauf und ersetzt keinen Tokenizer. Sechs Seiten pro Paket halten diese Übung überschaubar. Passen Sie beide Werte an Modell, Informationsdichte und Ausgabebudget an. Überschreitet eine einzelne Seite das Zeichenziel, markiert das Skript sie als übergroß, statt sie abzuschneiden. Teilen Sie sie dann an sinnvollen Abschnitten und erhalten Sie bei jedem Abschnitt die Quellseite.
Eine Assertion prüft, ob jede Originalseite genau einmal zugewiesen ist. Das belegt die Dateiabdeckung, nicht, dass das Modell jede Seite gelesen hat. Dafür brauchen Sie die Paketbelege und nachfolgenden Kontrollen.
Fehlenden oder irreführenden Text untersuchen
Eine Seite ohne extrahierten Text erhält needs-visual-review-or-OCR, nicht automatisch „leer“. Sie könnte eine gescannte Tabelle, Grafik oder handschriftliche Notiz enthalten. Öffnen Sie das Original, beurteilen Sie die Relevanz und übergeben Sie nötigenfalls ein Bild oder OCR-Ergebnis über einen geeigneten Eingabeweg.
Die PyMuPDF-Seitendokumentation (Englisch) behandelt Textextraktion und OCR getrennt. Das Beispielskript extrahiert Text, führt nicht automatisch OCR aus und verspricht keine Diagrammdeutung. Auch vorhandener Text kann in falscher Lesereihenfolge vorliegen. Prüfen Sie mehrspaltige Seiten, Fußnoten und Tabellen im gerenderten Dokument.
Überschreitet eine Tabelle eine Paketgrenze, verschieben Sie den Schnitt oder nehmen Sie die Nachbarseite als ausdrücklich dokumentierte Überlappung hinzu. Erfassen Sie diese im Manifest und deduplizieren Sie Belege anhand von Quellseite und Fakt, nicht durch pauschales Löschen ähnlicher Sätze. Das Skript erzeugt nicht überlappende Seitenpakete und erkennt keine fachlichen Abschnitts- oder Tabellengrenzen automatisch.
Pro Paket Belege extrahieren
Verwenden Sie die Paket-PDF, wenn das Layout relevant ist, und den gekennzeichneten Text bei einem passenden Text-Eingabeweg. Die Ergebnisse müssen einzelnen Paketen zugeordnet bleiben. Hängen Sie Paket und manifest.json an oder übernehmen Sie die zugehörige Zuordnung in den Prompt. Paket 3 umfasst beispielsweise Originalseiten 13–18; seine lokale Seite 5 ist Originalseite 17. Textdateien tragen bereits Originalseitenmarkierungen.
Laden Sie die Referenz-JSON nicht mit hoch. Prüfen Sie in Ofox Chat oder einem anderen Assistenten mit Dateiunterstützung die Anhänge und verwenden Sie die Originalseitenzuordnung statt des lokalen PDF-Seitenzählers. Der englische Prompt bleibt reproduzierbar; diese Übersetzung beschreibt den englischen Test, keinen neuen deutschsprachigen Modelllauf:
Read only this attached batch of the synthetic project report.
The supplied manifest maps batch pages to original PDF pages.

Return two tables:
1. Coverage: every assigned original page, status (reviewed, no relevant
   content, unreadable, or missing), and a short reason.
2. Evidence: decision/risk, exact value or date, approval/effective date
   if stated, original source page, a short supporting excerpt, and whether
   the source says it supersedes another value.

Extract the pilot launch date, budget, blocking dependencies and their
amendments. Preserve old and new values; do not silently reconcile them.
Do not guess facts from another batch. A blank page is reviewed only after
you inspect it. Report unreadable pages and missing attachments explicitly.
Do not use web sources or invent page references.
Speichern Sie jede Antwort mit Paketnummer. Ein einziger Abschlussabsatz lässt sich bei ausgelassenen Seiten kaum abgleichen. Für vertrauliche Berichte verwenden Sie nur Material, das Sie verarbeiten dürfen, und entfernen unnötige sensible Abschnitte vor der Übermittlung.
Belege vor der Zusammenfassung zusammenführen
Führen Sie nach den vier Extraktionen die Belegtabellen zusammen, statt das Modell an vier lange Unterhaltungen erinnern zu lassen. Jede belegte Aussage behält einen eigenen Eintrag. Ein neuerer Wert gilt nur dann als Ersatz, wenn das Dokument diese Beziehung tatsächlich herstellt; Chronologie allein reicht nicht.
Merge these four evidence tables for the same source report.
For each current decision, retain the earlier value, the amendment,
approval date, original pages and supporting excerpts. Mark unresolved
conflicts instead of choosing silently. Identify missing batch outputs.

Produce:
- A current-decisions table.
- A superseded-values table.
- A page coverage table for original pages 1 through 24.
- A short summary supported only by the reconciled evidence.
List any claim that still requires checking against the original PDF.
Im Beispiel ist der aktuelle Starttermin 12. Januar 2027, belegt durch Seite 17, die Seite 12 ausdrücklich ersetzt. Das aktuelle Budget beträgt 135.000 USD, belegt durch Seite 22 als Ersatz für Seite 1. Laut Seite 8 muss die Sicherheitsprüfung des Lieferanten vor dem Pilotstart abgeschlossen sein. Halten Sie diese Quellen unmittelbar bei den Aussagen fest.
Geben Sie diese Lösungen nicht in den Extraktionsprompt und behaupten Sie anschließend, das Modell habe sie selbst gefunden. Bei einem Fehler bewahren Sie die erste Ausgabe auf und zeigen die Korrektur getrennt.
Drei Arten von Vollständigkeit prüfen
Eingabeabdeckung: Das Manifest umfasst alle 24 Originalseiten und sämtliche Pakete sind vorhanden. Ein erfolgreicher Upload beweist keine Verarbeitung aller Dateien.
Verarbeitungsabdeckung: Jede Paketausgabe nennt ihre zugewiesenen Seiten, einschließlich Seite 9 ohne relevanten Inhalt. Eine selbst gemeldete Abdeckung ist nützliche Buchführung, aber kein eigenständiger Beweis. Vergleichen Sie die Seiteninhalte unabhängig.
Antwortabdeckung: Der Schlussbericht nennt Termin, Budget und Abhängigkeit mit richtigen Änderungen und Seiten. Prüfen Sie Anfang, Mitte und Ende. Bei echten Berichten sollte zusätzlich eine nicht ausdrücklich angeforderte, aber wesentliche Ausnahme kontrolliert werden, damit eine Zusammenfassung wichtige Einschränkungen nicht versteckt.
Alle drei Ebenen müssen übereinstimmen. Eine 24/24-Anzeige mit altem Termin ist ein Fehler. Ein richtiger Termin mit erfundener Quellseite 25 ebenfalls.
Ergebnisse des tatsächlichen Vier-Paket-Tests
Am 7. November 2026 wurden die vier Paket-PDFs und manifest.json in einer Ofox-Chat-Unterhaltung angehängt, ohne Referenzantworten und ohne ungeteilte PDF. Angefordert wurden getrennte Belegblätter vor dem Zusammenführen, eine Abdeckungszeile pro Originalseite, Zitate, frühere Werte und Ausnahmen. Dies waren keine vier isolierten Modellsitzungen und kein Test des maximalen Kontextfensters.
Laden Sie die tatsächliche Audit-Arbeitsmappe und den Markdown-Bericht herunter. Neben vier Paketblättern enthält die Datei Coverage, Decisions und Exceptions.
| Kontrolle | Beobachtetes, unabhängig geprüftes Ergebnis |
|---|---|
| Originalseiten | Genau eine Abdeckungszeile je Seite 1–24, keine fehlenden oder doppelten IDs |
| Belegzitate | Alle 29 Zitate nach Normalisierung von Leerraum auf der angegebenen Originalseite gefunden |
| Terminänderung | 12. Januar 2027 auf Seite 17; 15. Dezember 2026 auf Seite 12 bleibt dokumentiert |
| Budgetänderung | 135.000 USD auf Seite 22; 120.000 USD auf Seite 1 bleibt dokumentiert |
| Sicherheitsabhängigkeit | Voraussetzung aus Seite 8 erhalten; Abschlussstatus unbekannt |
| Seite 9 | Als inhaltlich nicht relevant erfasst, nicht ausgelassen |
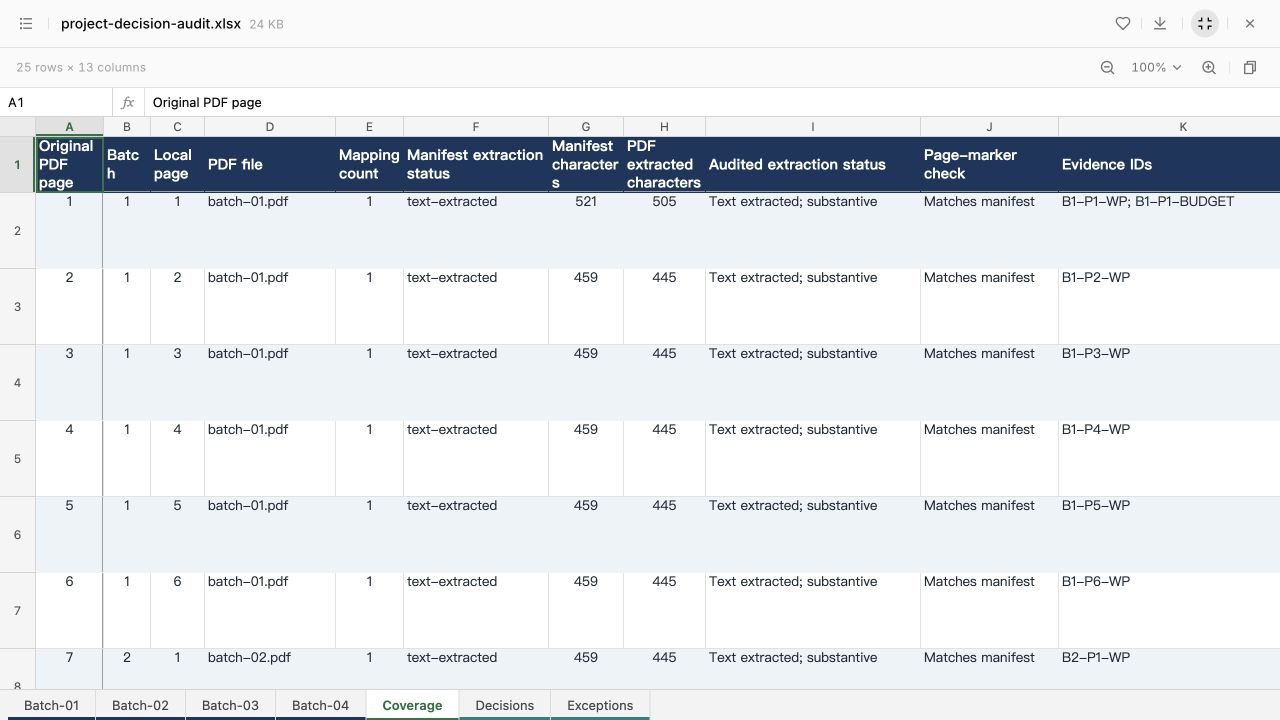
Das Modell meldete zwei Grenzen der Prüfung. Den Hash der ungeteilten PDF konnte es ohne diese Datei nicht prüfen; wir verglichen ihn anschließend lokal mit dem Original. Außerdem unterschieden sich auf allen Seiten die Zeichenzahlen. Wir reproduzierten die Ursache: Das Vorbereitungsskript zählt get_text(sort=True).strip(), die Auditwerte entsprachen get_text() ohne Abschneiden von Rand-Leerraum. Sortierung und Leerraum können Zählwerte verändern, ohne Seiten zu verlieren. Die ursprünglichen Vorbehalte wurden in der Ausgabe belassen; dem Modell wird keine nachträglich von uns gewonnene Erklärung zugeschrieben.
Eine Differenz sollte daher untersucht und nicht automatisch gelöscht oder als vollständiger Fehlschlag bewertet werden. Dokumentieren Sie die Extraktionsmethode und vereinheitlichen Sie die Zählweise vor einem Vergleich. Prüfen Sie die zitierten Textstellen zusätzlich: Gleiche Zeichenzahlen beweisen keine richtige Interpretation.
Die kurzen, durchsuchbaren Seiten enthalten ausdrückliche Änderungen. Der Test belegt Quellenverfolgung und Abgleich, nicht zuverlässige Verarbeitung beliebig langer, gescannter oder komplexer Berichte. Unklare Freigabebefugnisse müssen auch in echten Entscheidungstabellen unklar bleiben.
Gezielte Wiederherstellung statt komplettem Neustart
| Fehler | Gezielte Korrektur |
|---|---|
| Ganzes Paket fehlt | Dieses Paket verarbeiten und Zusammenführung der Belege wiederholen |
| Fakt richtig, Seitennummer falsch | Quelle öffnen und Originalzuordnung reparieren |
| Altes Budget im Schlussbericht | Beide Belegzeilen und Änderungswortlaut vorlegen; alten Wert behalten |
| Eine Scanseite hat keinen Text | Diese Seite rendern/OCR anwenden und mit ursprünglicher ID ergänzen |
| Antwort bricht ab | Als unvollständig markieren, Paket oder Ausgabeumfang verkleinern, betroffenes Paket wiederholen |
| Zusammenführungsauftrag zu groß | Zuerst Abschnittstabellen mit Quellen bilden, dann diese zusammenführen; Originale behalten |
Eine konkrete Anweisung lautet etwa: „Prüfe Originalseite 17 und ihre Aussage über Seite 12 erneut; korrigiere den aktuellen Starttermin und erhalte den früheren Wert.“ „Mach die Zusammenfassung genauer“ gibt dagegen kein überprüfbares Ziel vor.
Einen prüfbaren Bericht übergeben
Bewahren Sie Original-PDF, Quellhash, Manifest, Paketausgaben, zusammengeführte Belege, Zusammenfassung und offene Fragen gemeinsam auf. Bei einem PDF-Export hilft die Prüfung heruntergeladener Ergebnisse (Englisch). Für mehrere unabhängige Dokumente statt eines langen Berichts gibt es den Mehr-PDF-Vergleich (Englisch).
Beginnen Sie mit der Übung in Ofox Chat und behalten Sie die Quellseite bei jeder Revision. Ziel ist ein Ergebnis, das Kollegen prüfen können, ohne die gesamte Arbeit zu wiederholen.