Claude Haiku 5.5 与 4.5:分类、提取和摘要任务对比
用真实 API 请求比较 Claude Haiku 5.5 与 4.5 的分类、信息提取和摘要结果,检查 JSON 格式、字段与事实,附可复现测试包及迁移验收步骤。
 Ofox
对于重复性的应用任务,Claude Haiku 5.5 值得纳入评估,但在替换 Haiku 4.5 之前,新模型应先通过你的输出契约测试。在 Ofox 的小规模测试中,两个版本都返回了预期的分类和提取结果,但摘要的结构不同;即使提示词要求返回 JSON,两个版本也都用 Markdown 代码围栏包裹了响应。答案看起来正确,并不代表它能直接作为严格 JSON 解析器的有效输入。
本文比较了通过真实 API 发送的三个虚构任务,展示记录到的结果,并为维护批处理流程或应用后端的开发者提供迁移步骤。这项测试不能证明哪个模型在准确率、延迟或成本方面总体更优。每个模型对每项任务只发送了一次请求,总计六次请求,且没有使用结构化输出 schema。
Anthropic 于 10 月 7 日发布 Haiku 5.5,并将其定位于分类和摘要等高调用量任务。这些产品层面的主张与下文范围有限的测试观察是两回事。
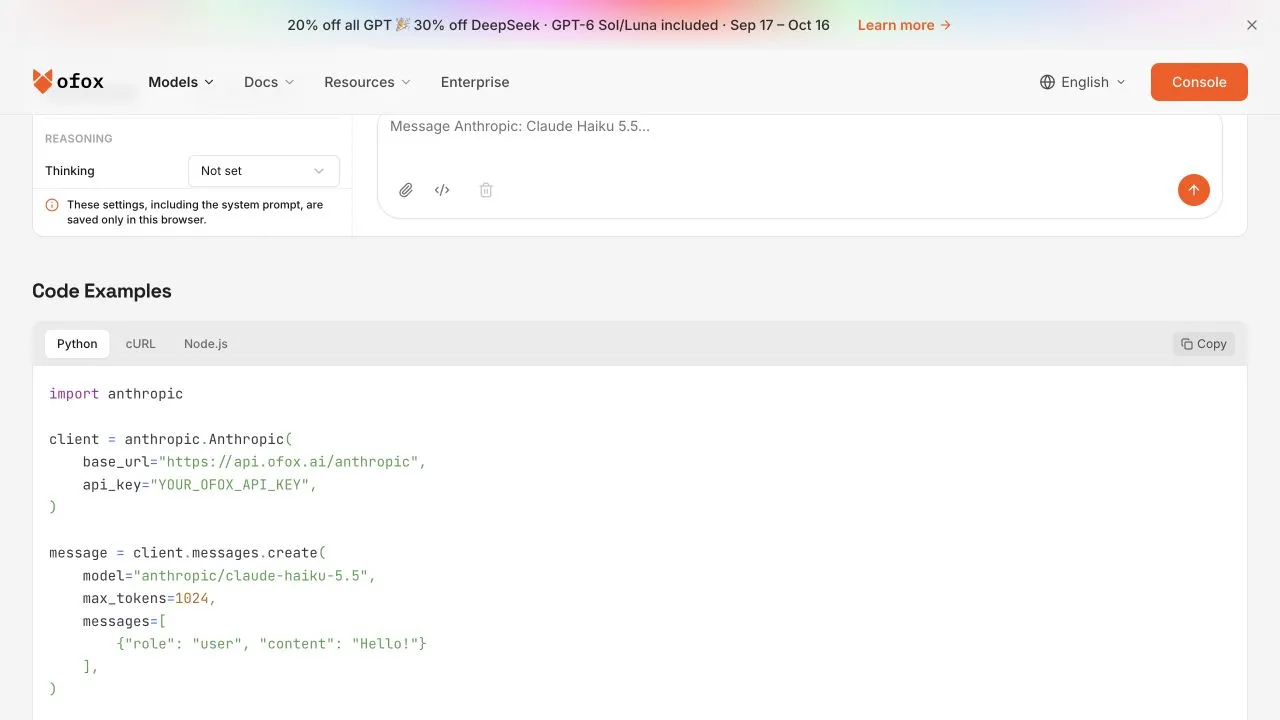
这是 10 月 12 日截取的 Ofox 实际界面,展示了模型标识符和 Anthropic SDK 示例。下文的比较使用的是单独指定的 Chat Completions 路由;这张截图仅用于展示设置参考,不能证明评测成功。
测试约定
我们使用了 https://api.ofox.ai/v1/chat/completions、max_tokens: 1800 和以下确切的 Ofox ID:
anthropic/claude-haiku-4.5
anthropic/claude-haiku-5.5
我们没有明确设置 temperature 或 reasoning 控制参数。不同提供方的默认设置、路由和 token 统计方式可能不同。因此,相同的用户文本并不保证实际计算预算也相同。输入不包含客户数据、真实订单或个人信息。
可下载的测试工具包包含提示词、经过脱敏的响应证据和脚本。运行 API 脚本会发起真实请求,并可能产生用量费用;请先检查脚本,并设定有上限的测试预算。原始观察结果对应当时那批请求,不会在每次有人访问本页面时重新生成。
| 任务 | 预期信息 | 验收标准 |
|---|---|---|
| 对四条工单分类 | A:账单;B:技术;C:账户;D:账单 | ID 与标签的对应关系必须完全符合预期 |
| 提取订单信息 | BX-71;数量 12;没有交付日期;EUR | 保留整数和 null 类型;不得编造日期 |
| 总结会议内容 | Maya;10 月 14 日截止;仅英文试点;价格未定 | 保留已批准的决定和未解决事项;另行检查输出结构 |
摘要提示词要求返回指定字段,但没有提供正式 schema。这个测试适合用于发现集成风险,却不能据此断言模型无法遵循强制执行的 schema。
结果:字段值和响应结构要分别检查
| 任务 | Haiku 4.5 | Haiku 5.5 |
|---|---|---|
| 工单标签 | 返回了四个预期标签 | 返回了四个预期标签 |
| 订单提取 | 返回了预期字段和值,包括 null 交付日期 | 返回了预期字段和值,包括 null 交付日期 |
| 摘要表示形式 | 顶层包含一个 tasks 数组,每项单独列出 | 请求的字段位于顶层 |
| 文本能否直接作为严格 JSON 解析 | 包含 Markdown 代码围栏 | 包含 Markdown 代码围栏 |
对于分类和提取任务,移除唯一一层外部代码围栏后,字段值符合预期。如果你的使用方直接执行 json.loads(response_text),同一响应就会解析失败。请明确记录使用方是否接受单层代码围栏;不要默默修补任意格式错误的输出,直到它看起来像预期答案为止。
Haiku 5.5 返回的摘要是一个扁平对象:
{
  "owner": "Maya",
  "deadline": "2026-10-14",
  "decision": "English-only pilot approved",
  "unresolved": "Price undecided"
}
Haiku 4.5 则把草拟邮件、批准试点和价格未定分别归入不同的任务条目。这种表示形式包含了有用信息,但如果使用方期待顶层的 owner 和 deadline,就无法找到这些字段。由于样本只有一个,而且 schema 也未充分定义,负责任的结论应是测试并强制执行你的集成契约,而不是声称某个版本的摘要总是更好。
扁平对象也没有明确写出起草邮件这一行动。如果业务需要同时记录行动和决定,就应要求模型返回不同字段。“符合 schema”和“包含所有业务所需事实”是两项不同的验收测试。
观察到的延迟和 token 数
以下是客户端观察到的请求耗时,以及 API 返回的 token 数量。这些数据包含所选网关路径的影响,并非仅针对模型推理的测量结果。
| 任务 | 4.5 耗时(秒) | 5.5 耗时(秒) | 4.5 输入 / 输出 token | 5.5 输入 / 输出 token |
|---|---|---|---|---|
| 分类 | 1.833 | 1.791 | 64 / 43 | 89 / 45 |
| 提取 | 1.750 | 1.779 | 61 / 49 | 88 / 46 |
| 摘要 | 1.979 | 2.411 | 64 / 142 | 87 / 191 |
这次测试中,向 5.5 发送摘要请求花费的时间更长。单次观察既不能推翻供应商更广泛的产品定位,也不能预测你的生产环境延迟。在调整服务级别预期之前,请重复测试有代表性的案例,纳入失败情况,并收集延迟分布。
不要把可见答案中的词数当作计费输出 token 数。请记录响应中返回的用量字段,并与提供方的请求记录核对。表格报告的是 API 返回的数据;它不能解释内部计量方式的所有差异,也不代表已经确认的美元账单金额。
制定预算时,应比较每个通过验收的结果的成本,而不只是输入和输出单价。可以使用下面这份实用的计算表:
cost per accepted result =
  reconciled spend across initial attempts, retries and fallbacks
  / number of results that pass your acceptance rules
分子中不能漏掉被拒绝的输出或回退调用。如果没有任何结果通过验收,这个比率就是未定义,而不是零。计算支出前,请查询所用提供方当前的准确费率,以及适用的缓存或上下文档位。本文有意不对 Ofox 能节省多少费用作出固定承诺。
使用更严格的提取契约
先编写一条明确说明缺失值和类型规则的提示词。下面是改进后的模板,不是上文测量所用的提示词:
Extract only facts explicitly present in the input.
Return a single JSON object, without Markdown or commentary.
Keys must be exactly:
order_id: string
quantity: integer
delivery_date: ISO YYYY-MM-DD string, or null if not stated
currency: three-letter currency code, or null if not stated
Do not infer a delivery date from today's date.
Do not convert an unknown value to an empty string.
Input:
Order BX-71 contains 12 notebooks. Delivery is not scheduled.
Total: 48 EUR.
请在代码中验证生成的对象。如果所选路由支持 schema 约束输出,请先使用准确的模型和端点验证该功能再采用;我们的纯提示词测试没有验证这项功能。
import json

def validate_order(text):
    value = json.loads(text)  # Strict: intentionally rejects code fences.
    expected = {"order_id", "quantity", "delivery_date", "currency"}
    if not isinstance(value, dict) or set(value) != expected:
        raise ValueError("Unexpected object shape")
    if not isinstance(value["order_id"], str):
        raise ValueError("order_id must be a string")
    if type(value["quantity"]) is not int:
        raise ValueError("quantity must be an integer")
    # Fixture-specific assertions; replace with production business rules.
    if value != {"order_id": "BX-71", "quantity": 12,
                 "delivery_date": None, "currency": "EUR"}:
        raise ValueError("Fixture facts do not match")
    return value
这个精确值断言适用于这份合成测试数据。生产环境中的验证器还需要定义货币允许值、日期有效性和记录标识符等领域规则;不能拿每条客户记录都和 BX-71 比较。
迁移时不要丢失失败记录
将模型 ID 作为明确的配置项,并保留原模型,直到替代模型通过有代表性的评估。对每条输入,记录稳定的记录 ID、提示词版本、模型 ID、尝试次数、返回的用量、验证状态和输出。把错误也作为记录保存,不要在批处理中直接丢弃这些行。
从一个包含常见情况和边界情况的小型标注集开始,例如缺少日期、信息矛盾、未知类别、空输入、异常长文本,以及嵌入输入中的指令。把输入文档当作数据处理,不能让文档替换提取指令或选择任意工具。
分别比较语义验收结果、JSON 语法和结构。扩大部署范围前,请先检查分歧。在有限范围内推出时,将旧路由保留为受控回退,限制重试次数,并跟踪重复处理。如果请求超时,它仍可能已经到达提供方;不要直接假定没有产生任何用量。
对于分类任务,要定义没有合适标签时该怎么处理。对于摘要任务,要定义哪些事实可以省略。对于提取任务,要定义有歧义的字段应返回 null,还是转交人工审核。与单纯更改模型字符串相比,这些决策通常更关系到应用正确性。
如果你也在使用 Claude Code,请通过对比 curl 与客户端的连接诊断指南单独验证它的连接。文本 API 调用成功,并不能证明编程客户端的工具或配置正常。
常见问题
- Haiku 5.5 在这三项测试中都胜出了吗?
- 不能据此给出这样的总体排名。两个版本都返回了预期的分类和提取结果,但摘要结构有所不同;所有测得的响应都包含 Markdown 代码围栏,而这不符合我们的严格解析契约。
- Haiku 5.5 每次完成任务的成本都更低吗?
- 这项测试无法证明这一点。请根据实际通过验收的输出、全部重试和回退、提供方当前费率以及核对后的用量进行比较。单看更低的费率,无法完整衡量任务成本。
- 我只改模型 ID 就可以切换吗?
- 这或许足以发送请求,但不足以验证应用迁移是否成功。还需要重新检查输出语法、字段、语义完整性、限制、延迟和回滚行为。