Ist Gemini 4 Hydrogen ein Budgetmodell? Kostenvergleich mit Claude Haiku 5.5 und GPT-6 Luna
Hydrogen kostet pro Token das 15-Fache von Haiku 5.5 und Luna. Wir vergleichen offizielle Preise, die Kosten pro Aufgabe laut Artificial Analysis und einen Triage-Test mit 24 Aufrufen, um zu zeigen, wann sich der Aufpreis lohnt.
 Ofox
Nein. Gemini 4 Hydrogen ist Googles Allzweckmodell im mittleren Preissegment, nicht seine Budgetstufe. Zu Googles kostenpflichtigen Standard-Preisen kostet es 1,50 USD pro Million Eingabe-Token und 7,50 USD pro Million Ausgabe-Token. Das ist das 15-Fache der Preise für kurze Prompts bei Claude Haiku 5.5 und GPT-6 Luna (jeweils 0,10 USD und 0,50 USD). Pro erledigter Aufgabe kann der Abstand noch größer ausfallen, denn Hydrogen denkt standardmäßig auf der Stufe high und verbraucht für dieselbe Arbeit mehr Ausgabe-Token. Googles eigener Leitfaden empfiehlt für Klassifizierung und Routing in großem Umfang Gemini 3.5 Flash-Lite, nicht Hydrogen.
Ein Fehlkauf ist Hydrogen deshalb nicht. Im Intelligence Index von Artificial Analysis erreicht es etwa doppelt so viele Punkte wie Haiku 5.5 und Luna in ihren Standardeinstellungen. Bei einer einfachen, klar spezifizierten Triage-Aufgabe hat diese zusätzliche Leistung allerdings keinen Unterschied gemacht: Haiku und Luna waren in unserem Test genauso genau und deutlich günstiger.
Dieser Artikel wird von Ofox veröffentlicht. Bei unserer Prüfung am 19. November 2026 ließen sich alle vier Modelle über Ofox aufrufen. Jede Angabe unten ist einer von drei Quellen zugeordnet: offizielle Dokumentation (geprüft am 19. November 2026), Daten von Artificial Analysis (abgerufen am 19. November 2026) oder unser eigener kleiner Testlauf über Ofox am selben Tag. Die Dollarbeträge im Test haben wir anhand der offiziellen Listenpreise der Anbieter berechnet; es sind keine Ofox-Abrechnungen. Die Preise von Ofox selbst stehen auf den Modellseiten, die am Ende verlinkt sind.
Offizielle Listenpreise auf gleicher Basis
Alle Preise in USD pro Million Token, kostenpflichtige Standard-Stufe, First-Party-API. Bei allen vier Modellen enthalten die Ausgabepreise auch Thinking- bzw. Reasoning-Token.
| Modell (API-ID) | Eingabe | Ausgabe | Gecachte Eingabe | Preisbedingung | Batch Eingabe / Ausgabe |
|---|---|---|---|---|---|
Gemini 4 Hydrogen (gemini-4-hydrogen) | 1,50 | 7,50 | 0,075 (nur implizit) | Ein Preis bei jeder Prompt-Länge | 0,75 / 3,75 |
Claude Haiku 5.5 (claude-haiku-5-5) | 0,10 | 0,50 | Lesen 0,01; 5-Min.-Schreiben 0,125 | Prompt ≤100.000 Token | 0,05 / 0,25 |
| Claude Haiku 5.5, Prompt >100K | 0,50 | 2,50 | Lesen 0,05; 5-Min.-Schreiben 0,625 | Gilt für die gesamte Anfrage | 0,25 / 1,25 |
GPT-6 Luna (gpt-6-luna) | 0,10 | 0,50 | 0,01 | Eingabe ≤272K Token | 0,05 / 0,25 |
| GPT-6 Luna, Eingabe >272K | 0,20 | 0,75 | 0,02 | Gilt für die gesamte Anfrage | 0,10 / 0,375 |
Gemini 3.5 Flash-Lite (gemini-3.5-flash-lite) | 0,30 | 2,50 | 0,03 + Speicherung 1,00 pro 1 Mio. Token und Stunde | Einheitspreis | 0,15 / 1,25 |
Quellen: Google-Gemini-API-Preise (Englisch), Anthropic-Preise (Englisch), OpenAI-Preise (Englisch) und die Modellseite von GPT-6 Luna (Englisch).
Drei Details verändern den Vergleich stärker als das plakative Verhältnis von 15 zu 1.
Der niedrige Preis von Haiku 5.5 hat eine Obergrenze. Anthropic berechnet Haiku 5.5 nach Prompt-Länge. Eine Anfrage mit einem Prompt über 100.000 Token zahlt das Fünffache der Basispreise, und zwar für die gesamte Anfrage einschließlich der Ausgabe. Cache-Lese- und Cache-Schreibvorgänge zählen zu den 100K. Oberhalb dieser Grenze ist Hydrogen nur noch dreimal so teuer wie Haiku statt fünfzehnmal. Unser Leitfaden zum Haiku-5.5-Preis an der 100K-Grenze (Englisch) rechnet die Grenze mit genauen Zahlen durch. Luna hat eine ähnliche Stufe bei 272K Eingabe-Token. Hydrogens Preistabelle nennt keine Stufe für lange Kontexte.
Hydrogen hat eine kostenlose Stufe. Die Preisseiten von Anthropic und OpenAI nennen für Haiku 5.5 und Luna nur kostenpflichtige Preise. Google führt Hydrogen und 3.5 Flash-Lite in der kostenlosen Stufe als gebührenfrei, was beim Prototyping hilft. Googles Tabelle weist allerdings auch darauf hin, dass Inhalte aus der kostenlosen Stufe zur Verbesserung der Google-Produkte verwendet werden, und der Zugang hängt von der Berechtigung des Projekts und von Limits ab. Prüfung und Kontingente behandelt unser Hydrogen-Einrichtungsleitfaden.
Flash-Lite ist günstiger als Hydrogen, aber nicht günstiger als Haiku oder Luna. Der Eingabepreis liegt beim Dreifachen, der Ausgabepreis beim Fünffachen. Innerhalb von Googles Modellreihe ist es die günstige Option; im Vergleich mit den anderen Anbietern ist es nicht die billigste.
Was eine Aufgabe tatsächlich kostet: Daten von Artificial Analysis
Der Preis pro Token sagt nichts darüber, wie viele Token ein Modell verbraucht. Artificial Analysis (AA, Englisch) führt die Evaluierungen seines Intelligence Index auf jedem Modell aus und veröffentlicht gewichtete durchschnittliche Kosten pro Aufgabe, berechnet aus den tatsächlich verbrauchten Token und den Preisen des jeweiligen Modells. Wir haben die vier Modellseiten am 19. November 2026 abgerufen. Die erste Tabelle verwendet die dokumentierte Standardeinstellung des jeweiligen Anbieters: Thinking high für Hydrogen (Googles Hydrogen-Leitfaden, Englisch), Effort medium für Haiku 5.5 (Anthropics Modellübersicht, Englisch) und medium für Luna (OpenAI-Modellseite).
Die gerenderten Seiten von AA zeigen Kosten pro Aufgabe nur für die höchste Einstellung jedes Modells. Die Kosten für die übrigen Einstellungen stammen aus den Daten hinter denselben Seiten. Dort ist jeder Kostenwert mit seiner Variante gekennzeichnet (zum Beispiel claude-haiku-5-5-medium oder gemini-4-hydrogen-high). Die Effort-Bezeichnungen unten stammen also von AA selbst und nicht aus unserer Zuordnung. Die Indexwerte jeder Bezeichnung stimmen mit den gerenderten Seiten überein.
| Modell in Standardeinstellung | AA Intelligence Index | AA-Kosten pro Index-Aufgabe | AA-Ausgabegeschwindigkeit |
|---|---|---|---|
| Gemini 4 Hydrogen (high) | 51 | 1,87 USD | 165 Token/s |
| Claude Haiku 5.5 (medium) | 25 | 0,092 USD | 222 Token/s |
| GPT-6 Luna (medium) | 18 | 0,042 USD | 96 Token/s |
| Gemini 3.5 Flash-Lite (nur eine Variante gelistet) | 12 | 0,69 USD | 318 Token/s |
In den Standardeinstellungen kostet Hydrogen pro AA-Aufgabe etwa das 20-Fache von Haiku und etwa das 44-Fache von Luna. Beide Abstände sind größer als das 15-fache Token-Preisverhältnis, weil Hydrogen auf high mehr Token pro Aufgabe erzeugt. Der Leistungsabstand zeigt in dieselbe Richtung: Hydrogens Indexwert ist ungefähr doppelt so hoch wie der von Haiku und fast dreimal so hoch wie der von Luna.
Das Bild ändert sich, wenn man den Effort der günstigeren Modelle erhöht:
| Höchste gelistete Einstellung | AA Intelligence Index | AA-Kosten pro Index-Aufgabe |
|---|---|---|
| Gemini 4 Hydrogen (xhigh) | 54 | 3,16 USD |
| Claude Haiku 5.5 (max) | 36 | 0,41 USD |
| GPT-6 Luna (max) | 28 | 0,15 USD |
In den höchsten Einstellungen schrumpft der Abstand zu Haiku auf etwa das 7,7-Fache, weil Haiku auf max deutlich mehr Token verbraucht. Luna bleibt etwa 21-mal günstiger. Selbst auf max erreicht aber keines der beiden Modelle Hydrogens Wert auf medium (41 auf der AA-Seite). Laut den Seitendaten von AA kostet Hydrogen auf medium 0,80 USD pro Aufgabe, also etwa das Doppelte von Haiku auf max (0,41 USD), bei einem um 5 Punkte höheren Wert. Ähnelt Ihre Arbeitslast den anspruchsvollen Reasoning- und Agent-Aufgaben von AA, kann Hydrogen auf einer niedrigeren Stufe das bessere Geschäft sein als ein kleines Modell am Anschlag.
Beachten Sie bei diesen Zahlen ihre Grenzen:
- Der AA-Index besteht aus schwierigen Evaluierungen. Ein Wert von 25 bedeutet nicht, dass Haiku drei Viertel Ihrer Extraktionsjobs nicht schafft. Unser Test unten zeigt, dass Haiku und Luna bei einer einfachen, regelbasierten Aufgabe vollständig korrekt waren.
- Die Geschwindigkeitswerte von AA sind eigene Messungen. Für Hydrogen auf
highnennt AA 19,4 Sekunden bis zum ersten Antwort-Token, gegenüber 9,1 Sekunden für Haiku aufmediumund 5,3 Sekunden für Luna aufmedium. Darin ist die Thinking-Zeit enthalten. - Die AA-Kosten pro Aufgabe für Flash-Lite (0,69 USD) taugen nicht als Wert „pro Anfrage“. In der Aufschlüsselung von AA entfällt der größte Teil auf cachebezogene Eingabekosten, nicht auf die Ausgabe. Für eine kurze, einmalige Anfrage war Flash-Lite bei uns günstiger als Hydrogen, wie der Test zeigt.
Unser Test: 20 Triage-Einträge plus 3 kurze Reasoning-Aufgaben
Wir wollten sehen, was diese Zahlen für die Arbeit bedeuten, für die man Budgetmodelle typischerweise einsetzt: viele kurze Einträge, ein festes Regelwerk, eine Antwort im JSON-Format. Am 19. November 2026 haben wir dieselben Prompts über Ofox’ OpenAI-kompatiblen Endpunkt (https://api.ofox.ai/v1/chat/completions) mit genau diesen Modell-IDs ausgeführt: google/gemini-4-hydrogen, anthropic/claude-haiku-5.5, openai/gpt-6-luna und google/gemini-3.5-flash-lite.
Einstellungen. Standardeinstellungen der Modelle: keine Temperature, kein Thinking- oder Reasoning-Parameter. Der einzige gesetzte Parameter war max_tokens: 32000 als Ausgabenobergrenze; keine Antwort hat sie erreicht (jeder finish_reason war stop).
Arbeitslast A, Triage. Eine Anfrage mit 20 Kundensupport-Nachrichten. Für jede Nachricht gibt das Modell category (fünf Klassen), order_id (die erste gültige Kombination aus ORD- und sechs Ziffern, in Großbuchstaben, sonst null) und refund (nur bei einer ausdrücklichen Bitte um Geld zurück true) zurück. Den Lösungsschlüssel haben wir geschrieben, bevor wir irgendein Modell aufgerufen haben. Mehrere Einträge sind absichtlich knifflig: eine fünfstellige Bestellnummer, die abgelehnt werden muss, eine Telefonnummer und eine Ticketnummer als Ablenkung, ein ausdrückliches „keine Rückerstattung gewünscht“, eine spanische Nachricht, Sarkasmus, eine Fehlerseite, die auf der Abrechnungsseite erscheint, aber ein Bug ist, und Nachrichten mit zwei Anliegen, bei denen das erste entscheidet. Jedes Modell hat diese Anfrage zweimal ausgeführt.
Arbeitslast B, Reasoning. Drei separate Prompts mit jeweils einer überprüfbaren Antwort: eine Berechnung von Wiederholungskosten (Antwort: 3,8064 USD), zwei SLA-Fristen in Geschäftszeiten (Montag 13:00; Dienstag 17:00) und drei Erstattungsentscheidungen nach Richtlinie, bei denen Tage gezählt werden müssen (ja, nein, ja). Je ein Lauf.
Die vollständigen Prompts, das Regelwerk, der Lösungsschlüssel, das Ausführungs- und das Bewertungsskript sind unten im Abschnitt zur Reproduktion verlinkt.
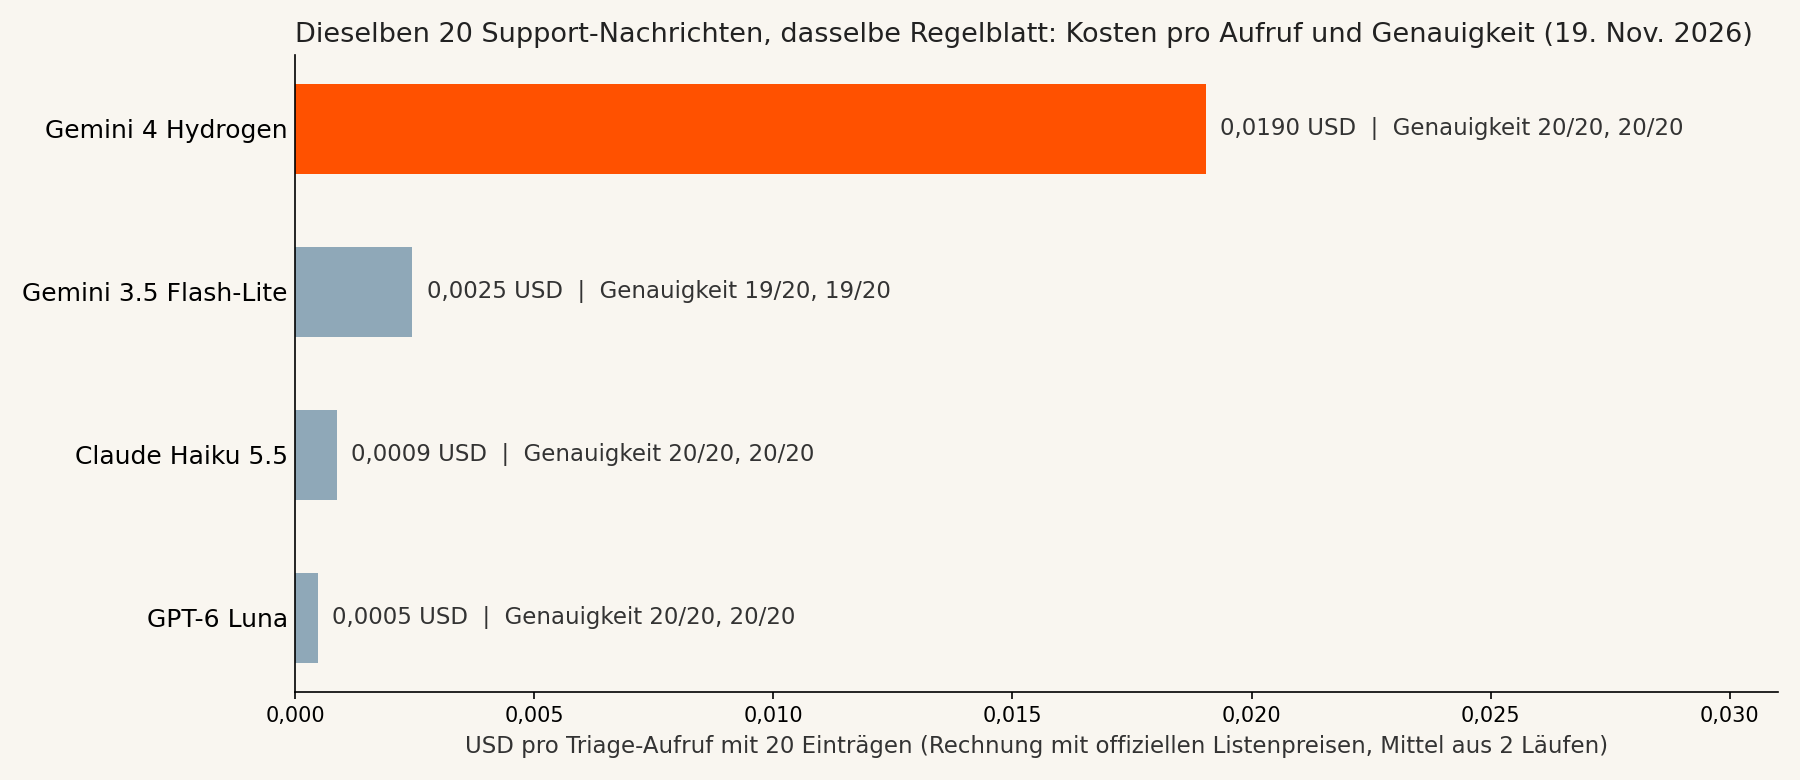
Diagramm mit Daten aus unseren Läufen vom 19. November 2026: Mittelwert aus zwei Triage-Aufrufen pro Modell, berechnet mit den offiziellen First-Party-Listenpreisen. Keine Ofox-Abrechnung.
Ergebnisse zu Genauigkeit und Kosten
| Modell | Triage-Genauigkeit (2 Läufe) | Reasoning-Aufgaben | Ø Triage-Latenz | Ø Ausgabe-Token pro Triage-Aufruf (Thinking) | Triage-Kosten pro Aufruf | Gleicher Satz pro 1.000 Nachrichten |
|---|---|---|---|---|---|---|
| Gemini 4 Hydrogen | 20/20, 20/20 | 3/3 | 16,1 s | 2.336 (≈1.698) | 0,0190 USD | ≈0,95 USD |
| Claude Haiku 5.5 | 20/20, 20/20 | 3/3 | 7,8 s | 1.476 (≈831) | 0,00086 USD | ≈0,043 USD |
| GPT-6 Luna | 20/20, 20/20 | 3/3 | 8,3 s | 780 (≈239) | 0,00048 USD | ≈0,024 USD |
| Gemini 3.5 Flash-Lite | 19/20, 19/20 (je 59/60 Felder) | 2/3 | 3,6 s | 861 (keine gemeldet) | 0,00245 USD | ≈0,12 USD |
Die Kosten sind eine Rechnung mit offiziellen Listenpreisen: die in jeder Antwort gemeldeten Eingabe- und Ausgabe-Token, multipliziert mit den First-Party-Standard-Preisen aus der ersten Tabelle. Haiku und Luna wurden hier zu ihren niedrigeren Stufen berechnet, da jeder Prompt weit unter 100K Token lag. Die Latenz ist die tatsächlich verstrichene Zeit von unserem Client über Ofox bis zu einer vollständigen, nicht gestreamten Antwort, einschließlich Netzwerkzeit. Es ist nicht die Zeit bis zum ersten Token. Die Spalte „pro 1.000 Nachrichten“ skaliert lediglich die gemessenen Batch-Kosten mit dem Faktor 50. Sie setzt dieselbe Prompt-Struktur und keine Wiederholungen voraus.
Über alle fünf Aufrufe pro Modell betrugen die Summen 0,0578 USD für Hydrogen, 0,0024 USD für Haiku, 0,0012 USD für Luna und 0,0071 USD für Flash-Lite. Bei dieser Arbeitslast kostete Hydrogen etwa das 24-Fache von Haiku und das 46-Fache von Luna. Der 15-fache Token-Preisaufschlag wuchs, weil Hydrogen für dieselben Antworten mehr Ausgabe-Token erzeugte, überwiegend Thinking.
Was die Läufe gezeigt haben:
- Hydrogens zusätzliche Leistung hat das Ergebnis nicht verändert. Hydrogen, Haiku und Luna haben in beiden Triage-Läufen jedes Feld richtig ausgefüllt und alle drei Reasoning-Aufgaben gelöst. Bei einer klar spezifizierten Aufgabe mit eindeutigem Regelwerk reichten die günstigeren Modelle aus.
- Luna war am tokeneffizientesten. Es meldete rund 240 Reasoning-Token pro Triage-Aufruf, gegenüber rund 1.700 bei Hydrogen und 830 bei Haiku. Wegen unterschiedlicher Tokenizer sind Token-Zahlen zwischen Anbietern nicht perfekt vergleichbar, aber der Kostenunterschied ergibt sich aus genau diesen Zahlen.
- Flash-Lite war am schnellsten und lag zweimal falsch. Beide Triage-Läufe gaben für Eintrag 7
ORD-77812zurück, eine fünfstellige ID, die laut Regelwerk abzulehnen ist. Bei der Erstattungsaufgabe zählte es vom 10. Oktober bis zum 15. November 21 statt 36 Tage und genehmigte eine Erstattung, die die 30-Tage-Regel hätte verhindern müssen. Flash-Lite meldete keine Reasoning-Token. Der Gemini-Thinking-Leitfaden von Ofox weist darauf hin, dass die Flash-Lite-Reihe standardmäßig nicht denkt. - Ein Haiku-Aufruf war langsam. Der Prompt zu den Wiederholungskosten dauerte 18,8 Sekunden, die beiden anderen Reasoning-Aufrufe etwa 4 Sekunden. Ein einzelner Lauf sagt nicht, ob das typisch ist.
Wird Hydrogen günstiger, wenn man das Thinking senkt?
Laut Google bietet low den geringsten Token-Verbrauch und die niedrigste Latenz. Deshalb haben wir die Triage-Anfrage auf Hydrogen erneut ausgeführt: zweimal mit angefordertem reasoning_effort: "low" auf der OpenAI-kompatiblen Route und zweimal mit angefordertem thinkingConfig.thinkingLevel: "low" auf der Gemini-nativen Route von Ofox. Beides sind die dokumentierten Wege, die Stufe bei Ofox zu setzen. Beide Routen haben die Anfrage angenommen (HTTP 200), aber keine Antwort gibt an, welche Stufe angewendet wurde. Die Wirkung der Einstellung ist daher nicht bestätigt.
| Hydrogen-Triage, je 2 Läufe | Genauigkeit | Thinking-Token | Listenpreiskosten pro Aufruf | Latenz |
|---|---|---|---|---|
| Standard (kein Parameter) | 20/20, 20/20 | 1.585 / 1.811 | 0,0182 / 0,0199 USD | 16,2 / 16,1 s |
reasoning_effort: "low" angefordert | 20/20, 20/20 | 1.564 / 1.650 | 0,0180 / 0,0187 USD | 15,8 / 17,1 s |
Natives thinkingLevel: "low" angefordert | 20/20, 20/20 | 1.478 / 1.630 | 0,0174 / 0,0185 USD | 19,1 / 18,8 s |
Bei diesem Prompt hat die Anforderung von low Thinking-Token, Kosten und Latenz kaum verändert. Die Einstellung low wurde angefordert; ihre Wirkung ist nicht bestätigt. Aus der Antwort lässt sich nicht ablesen, ob die Stufe angewendet wurde und das Modell den Batch mit 20 Einträgen schlicht so viel Thinking wert fand, oder ob die Einstellung auf diesen Routen nicht angewendet wurde. In beiden Fällen gilt: Gehen Sie nicht davon aus, dass eine niedrigere Stufe Hydrogens Kosten auf das Niveau von Haiku oder Luna drückt. Messen Sie mit Ihren eigenen Prompts. Unser Begleitartikel zu den Thinking-Stufen von Gemini 4 geht ausführlicher auf die Stufen ein.
Grenzen dieses Tests
Das ist eine Veranschaulichung, kein Benchmark: 24 Aufrufe, eine Batch-Struktur, ein Regelwerk und drei Reasoning-Prompts, alle an einem Tag ausgeführt. Volle Punktzahl bei 20 Einträgen zeigt, dass die Aufgabe für diese Modelle machbar war. Eine Fehlerquote lässt sich daraus nicht ableiten. Lange Dokumente, Bilder, Audio, Tool-Aufrufe und mehrstufige Agenten haben wir nicht getestet, und gerade dort dürfte Hydrogens höherer AA-Wert am ehesten ins Gewicht fallen. Die Latenz über Ofox kann von der direkten API des jeweiligen Anbieters abweichen. Der gesamte Test einschließlich der Folgeläufe kostete zu offiziellen Listenpreisen etwa 0,14 USD.
Wann sich Hydrogens Aufpreis lohnt
Entscheiden Sie nach der Aufgabe, nicht allein nach niedrigen Kosten pro Token. Auf Basis der Dokumentation, der AA-Daten und unserer Läufe:
Nutzen Sie Haiku 5.5 oder Luna, wenn die Aufgabe kurz, klar spezifiziert und überprüfbar ist. Klassifizierung, Routing, Feldextraktion nach Schema, einfache Berechnungen nach vorgegebenen Regeln. Beide waren auf unserem Testset genau und kosteten pro Aufruf etwa 1/20 bis 1/40 von Hydrogen. Anthropic beschreibt Haiku 5.5 als gebaut “for high-volume, latency-sensitive tasks such as classification, extraction, and routing” (also für latenzkritische Aufgaben mit hohem Volumen wie Klassifizierung, Extraktion und Routing). Zwischen beiden wählen Sie am besten anhand Ihrer eigenen Stichprobe: Luna verbrauchte in unserem Lauf die wenigsten Token, Haiku hatte den höheren AA-Wert in der Standardeinstellung (25 zu 18) und bei maximalem Effort (36 zu 28). Extraktionsmuster mit Luna zeigt Luna Structured Outputs für Datenextraktion (Englisch), Durchsatz-Jobs mit Haiku Haiku 5.5 vs. 4.5 bei Batch-Aufgaben (Englisch).
Zahlen Sie für Hydrogen, wenn die Aufgabe Reasoning, Tools oder Modalitäten braucht, die den kleinen Modellen fehlen:
- Schwierigere mehrstufige Arbeit. Hydrogens AA-Wert auf
medium(41) liegt über dem von Haiku aufmax(36). Wenn Sie ein kleines Modell bereits auf maximalen Effort stellen und es Ihre Prüfungen trotzdem nicht besteht, ist Hydrogen auf einer niedrigeren Stufe ein sinnvoller nächster Test. Google positioniert es für “everyday coding and agentic workflows” (alltägliches Programmieren und agentische Workflows). - Audio- und Videoeingabe. Googles Model Card nennt für Hydrogen Text, Bilder, Audio und Video als Eingaben. Anthropic nennt für seine aktuellen Modelle Text- und Bildeingabe; Lunas Modellseite führt die Modalitäten Text und Bild.
- Lange Prompts. Hydrogens Preis ändert sich nicht mit der Prompt-Länge. Sobald eine Anfrage 100K Prompt-Token überschreitet, steigt Haikus Preis auf das Fünffache und der Abstand zu Hydrogen schrumpft auf das Dreifache. Über 272K verdoppelt sich Lunas Eingabepreis. Sind die meisten Ihrer Anfragen lang, rechnen Sie mit den höheren Stufen neu.
- Kostenloses Prototyping bei Google. Mit Hydrogens kostenloser Stufe können Sie bauen, bevor Sie zahlen, vorbehaltlich Googles Datennutzungsbedingungen und Projektlimits. Siehe unseren Leitfaden zur kostenlosen API-Stufe von Gemini 4.
Nutzen Sie Gemini 3.5 Flash-Lite, wenn Sie Googles niedrigste Latenz oder günstige Audio- und Videoeingabe brauchen und die Ausgaben validieren können. Googles Hydrogen-Leitfaden empfiehlt selbst, 3.5 Flash-Lite “for high-volume classification, routing, and sub-second latency targets” (für Klassifizierung und Routing mit hohem Volumen sowie Latenzziele unter einer Sekunde) beizubehalten. In unserem Test war es das schnellste Modell, verfehlte aber eine strikte ID-Regel und eine Datumsberechnung, und sein Ausgabepreis ist fünfmal so hoch wie der von Haiku oder Luna. Unser früherer Extraktionsvergleich Luna vs. Gemini 3.5 Flash-Lite (Englisch) behandelt Unterschiede bei Eingabeformaten im Detail.
Ein praktikables Muster ist Routing nach Schwierigkeit. Schicken Sie jeden Eintrag zuerst an Haiku oder Luna. Prüfen Sie die Ausgabe gegen Ihr Schema und den Quelltext. Eskalieren Sie nur Fehlschläge, Einträge mit geringer Sicherheit oder lange multimodale Eingaben an Hydrogen. Unser Leitfaden zu den Kosten pro korrektem Ergebnis zeigt, wie man das kalkuliert, und Routing-Schwellen von Luna zu Sol (Englisch) liefert eine durchgerechnete Eskalationsregel. Wenn Sie stattdessen zwischen Hydrogen und der nächsthöheren Stufe abwägen, lesen Sie den Begleitvergleich Hydrogen vs. Claude Sonnet 5.5 vs. GPT-6.1 Terra, und für die gesamte Modellreihe Modellstufen von Gemini 4, Claude und GPT im Vergleich.
Den Test mit eigenen Daten reproduzieren
Wir haben für alle vier Modelle einen Ofox-Schlüssel und die OpenAI-kompatible Chat-Completions-Route verwendet; zwischen den Modellen änderte sich also nur der model-String. Die minimale Anfrage sieht so aus:
curl https://api.ofox.ai/v1/chat/completions \
  -H "Authorization: Bearer $OFOX_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "anthropic/claude-haiku-5.5",
    "max_tokens": 32000,
    "messages": [
      {"role": "system", "content": "<your rule sheet>"},
      {"role": "user", "content": "<your batch of items>"}
    ]
  }'
Ersetzen Sie das Modell durch google/gemini-4-hydrogen, openai/gpt-6-luna oder google/gemini-3.5-flash-lite. Lesen Sie aus jeder Antwort usage.prompt_tokens, usage.completion_tokens und usage.completion_tokens_details.reasoning_tokens. Bei den Gemini-Modellen enthalten die Completion-Token bereits die Reasoning-Token; zählen Sie sie also nicht doppelt.
Unsere Materialien zum Wiederholen oder Anpassen: das vollständige Testset mit Regelwerk, Einträgen und Lösungsschlüssel, das Ausführungsskript, das Bewertungsskript und unsere bewerteten Ergebnisse mit Nutzung pro Aufruf. Der Hydrogen-Folgelauf mit niedrigem Thinking nutzte dieses Skript für die native Route und ist in results_extra.json bewertet. Die Skripte verwenden nur die Python-Standardbibliothek und lesen den Schlüssel aus OFOX_API_KEY. Testset und Prompts bleiben so auf Englisch, wie sie gesendet wurden. Zusammengefasst:
- Regelwerk (System-Prompt, im Original auf Englisch): fünf Kategorien; die Bestell-ID ist das erste
ORD-gefolgt von genau sechs Ziffern, in Großbuchstaben, sonst null; refund ist nur bei einer ausdrücklichen Bitte um Geld zurück true; Lieferprobleme sindshipping, auch wenn eine Erstattung verlangt wird; Fehlerseiten sindbug, auch auf einer Abrechnungsseite; bei zwei Anliegen gilt das erste. - Triage-Einträge und Lösungen, zum Beispiel: “Order ORD-77812 never arrived. I want my money back.” →
shipping,null,true; “The page shows ‘Error 502’ whenever I open billing settings.” →bug,null,false; “Tracking for ORD-55120 and ORD-551209 both show delivered, but only one box came.” →shipping,ORD-551209,false. - Reasoning-Prompts: 12.000 Anfragen mit 1.800 Eingabe- und 250 Ausgabe-Token, 0,10 USD und 0,50 USD pro Million, 4 % einmal wiederholt (Antwort 3,8064 USD); ein Ticket am Freitag um 15:00 mit einem SLA von 6 Geschäftsstunden und ein Ticket am Montag um 22:30 mit 8 Stunden, Geschäftszeiten Montag bis Freitag 09:00–17:00 (Montag 13:00; Dienstag 17:00); drei Erstattungsanträge am 15. November 2026 unter einer Richtlinie mit 30 Tagen für Unbenutztes, 90 Tagen für Beschädigtes und digitalen Inhalten nur ohne Download (ja, nein, ja).
So passen Sie den Test an:
- Schreiben Sie 20 bis 50 Einträge, die Ihrem echten Traffic ähneln, einschließlich der Grenzfälle, die in Produktion Probleme machen. Schreiben Sie den Lösungsschlüssel, bevor Sie irgendetwas ausführen.
- Führen Sie jeden Kandidaten in der Standardeinstellung aus, dann eine Stufe höher oder niedriger. Erfassen Sie die Genauigkeit pro Feld, nicht nur „gültiges JSON“.
- Berechnen Sie jeden Aufruf aus der gemeldeten Nutzung mit den offiziellen Preisen, einschließlich Wiederholungen. Prüfen Sie bei großen Jobs, ob Batch-Verarbeitung passt; alle vier Modelle nennen Batch-Preise zum halben Standardpreis.
- Wählen Sie das günstigste Modell, das Ihre Genauigkeitsschwelle erreicht, und schicken Sie dessen Fehlschläge an ein stärkeres Modell.
Der Leitfaden zu strukturierten Ausgaben von Ofox zeigt, wie Sie schemagebundenes JSON anfordern. Prüfen Sie für Läufe mit hohem Volumen die Dokumentation zu Ratenlimits und bauen Sie Wiederholungen anhand des Leitfadens zur Fehlerbehandlung. Gibt ein Modell während Ihres Tests Fehler zurück, behandeln unser Leitfaden zu Gemini-4-API-Fehlern, Claude 529 overloaded beheben (Englisch) und OpenAI-Fehler model-not-found beheben (Englisch) die häufigsten Ursachen je Anbieter.
Die kurze Antwort
Hydrogen ist ein leistungsfähiges Allzweckmodell zu einem mittleren Preis. Für einfache Jobs mit hohem Volumen ist es nicht die Budgetwahl: Auf unserem Triage-Set war es genauso genau wie Haiku 5.5 und Luna und kostete 24- bis 46-mal so viel. Der Aufpreis ist sinnvoll, wenn eine Aufgabe so schwer ist, dass die kleinen Modelle Ihre Prüfungen nicht bestehen, wenn Audio- oder Videoeingabe nötig ist oder wenn Anfragen regelmäßig über Haikus 100K- oder Lunas 272K-Preisgrenze hinausgehen. Googles eigene günstige Gemini-Option ist 3.5 Flash-Lite. Es war das schnellste getestete Modell, kostet pro Token aber immer noch mehr als Haiku und Luna.
Weiterführende Dokumentation
- Gemini 4 Hydrogen bei Ofox (unterstützte Protokolle und aktueller Ofox-Preis)
- Claude Haiku 5.5 bei Ofox
- GPT-6 Luna bei Ofox
- Gemini 3.5 Flash-Lite bei Ofox
- Thinking-Einstellungen für Gemini
- Native Gemini-API
- Strukturierte Ausgaben
- Ratenlimits und Fehlerbehandlung
Häufig gestellte Fragen
- Rutscht Claude Haiku 5.5 bei einem großen Batch-Job in die höhere Preisstufe?
- Nein. Anthropic berechnet jede Anfrage nach der Länge ihres eigenen Prompts. Nur eine einzelne Anfrage, deren Prompt (einschließlich Cache-Lese- und Cache-Schreibvorgängen) 100.000 Token überschreitet, zahlt die höheren Preise. Diese gelten dann für die gesamte Anfrage, einschließlich der Ausgabe.
- Kann Gemini 4 Hydrogen ohne Thinking laufen?
- Google dokumentiert für Hydrogen vier Thinking-Stufen (low, medium, high und xhigh, Standard ist high) und beschreibt keine davon als ausgeschaltet. In unserem Triage-Lauf haben wir auf zwei Routen low angefordert; ob die Stufe gegriffen hat, ist nicht bestätigt, und die gemeldeten Thinking-Token haben sich bei diesem Prompt kaum verändert.