【AI 编程工具横评】9 个 coding agent harness 怎么选:先定 harness,再定模型
对比九款编程 agent harness 的模型、协议和工作流选择,保留八月六款工具同题实测,并更新十月用量数据、Copilot BYOK 与 Pi MCP 支持。
 Ofox
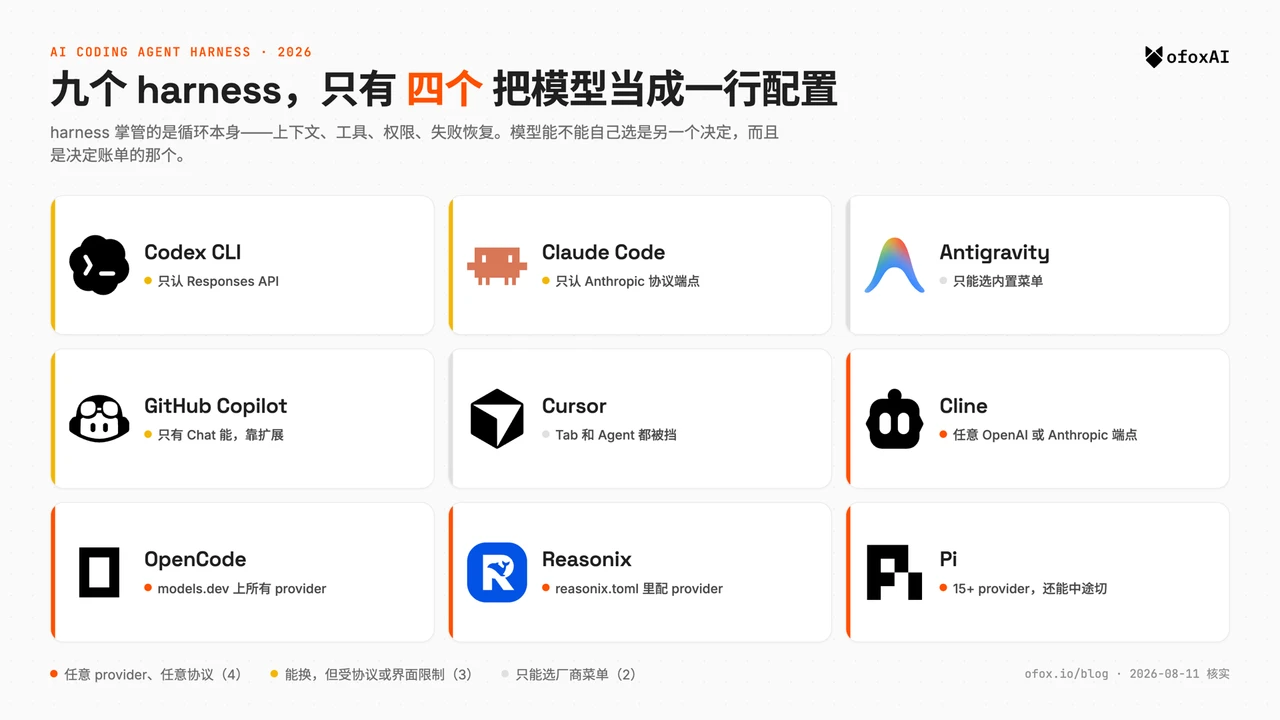
AI coding harness 是模型外面负责上下文、工具、权限、重试和会话状态的软件。 先按工作流选择工具,再验证它支持的模型和 API 协议。本文对比九款工具,不是一份能证明某款工具普遍最好的基准测试。Ofox 是本文发布方,也提供 API 网关;文中的集成链接是商业产品的配置入口,不是独立背书。
10 月 20 日更新: 本次重新核对了四个 OpenRouter app 页面、Copilot BYOK 文档、Cursor API key 文档和 Pi 当前功能页。原来“GLM 5.2 在 Claude Code 用量中领先”的开场结论已不适用:页面当前月度列表由 Claude Opus 5.5 领先。Copilot 的 BYOK 客户端范围扩大,Pi 也已内置 MCP。八月的实测和截图保留为历史证据,本次没有重跑那些模型与工具组合。原版封面图同样早于这些能力纠正。
一句话对照:九个 harness 怎么分
| Harness | 跑在哪 | 价格 | 能换模型吗 | 靠什么扩展 | 协议 |
|---|---|---|---|---|---|
 Codex CLI | 终端 | ChatGPT 订阅或 API key | 只认 Responses API | AGENTS.md、MCP | Apache-2.0 |
 Claude Code | 终端 | Claude 订阅或 API key | 能,改 ANTHROPIC_BASE_URL | hooks、子 agent、skills、MCP | 闭源 |
 Google Antigravity | 桌面端、IDE、CLI | 个人开发者免费 | 八月 CLI 未测试自定义路由 | agent 管理器、子 agent | 闭源 |
 GitHub Copilot | IDE、CLI、云端 | 套餐额度;BYOK 另计 | 支持的客户端可用本地 BYOK,受企业策略约束 | skills、MCP | 闭源 |
 Cursor | IDE | 订阅制 | 支持的聊天模型;不含 Tab | rules、MCP | 闭源 |
 Cline | VS Code、JetBrains | 自带 key | 兼容 OpenAI / Anthropic 路由,须验证工具 | plan 模式、MCP | Apache-2.0 |
 OpenCode | 终端、桌面端 | 自带 key | 能,models.dev 上所有 provider | AGENTS.md、MCP | MIT |
 Reasonix | 终端、桌面端、VS Code | 自带 key | 能,改 reasonix.toml | MCP、sidecar、plan 模式、checkpoint | MIT |
 Pi | 终端、RPC、SDK | 自带 key | 能,15+ provider,还能中途切 | 扩展、skills、MCP 和 Codemode | MIT |
自有 key、自定义端点和真正跑通 agent 循环是三种不同能力。需要检查具体客户端、账户策略、API 协议和工具行为;模型出现在菜单里,不代表文件编辑、工具调用或重试已经跑通。下文未标明十月更新的价格和产品描述保留原始横评语境,购买套餐前请查当前官方文档。
AI coding agent harness 到底是什么
harness 是包在模型外面的那层程序,它把「生成 token」变成「在你仓库里干活」。 模型是发动机,harness 是变速箱、底盘和刹车。
具体说,harness 干的是模型自己干不了的五件事:组装上下文,决定哪些文件和哪几轮历史发出去;定义并执行工具,让一次 read_file 调用真的读到文件;把关权限,让 rm -rf 是直接跑、先问一句还是干脆拒绝;管理恢复,决定补丁打不上或测试变红之后怎么办;以及保存会话状态,让中断的任务能接着跑而不是从头来。
这就是为什么两个人跑同一个模型,体验能差出十万八千里。把 GPT-5.6 Sol 从 Codex 挪到 Cline,模型一模一样,但读文件的策略、工具 schema、重试策略、审批流程全变了。大家搜的词五花八门(agent harness、coding agent、AI 编程工具),说的是同一层东西。
这些 harness 到底差在哪
四条轴,只有第四条是你上手前看不出来的。
跑在哪。 终端优先(Codex、Claude Code、OpenCode、Reasonix、Pi)、编辑器内(Cline、Cursor、Copilot),或者像 Antigravity 2.0 那样自带窗口的独立 agent 管理器。这决定了你能不能给它接管道、挂定时任务、或者 SSH 上去跑。
模型是不是你说了算。 这是本品类最干脆的二分:要么工具从配置里读 base URL,要么模型菜单是厂商定的,没得商量。
靠什么扩展。 一边是 hooks、子 agent、skills、MCP server 堆满,另一边是刻意留白、让你自己往上盖。Claude Code 和 Pi 是有意站在两个极端的。
控制循环在压力下的表现。 决定你会不会继续用下去的就是这条。改之前会不会先读对文件?diff 收不收得住?会不会跑你的检查?测试挂了能不能爬起来而不是反复横跳?被打断之后能不能续上?2026 年 7 月一条讨论 harness 怎么选的 r/AI_Agents 长帖最后收敛的正是这一点,最高赞的那条评论说得比我们好:
大家往往过度关注模型,而低估了执行循环。
本文就按这个框架来写。模型质量现在是入场券,循环行为是另一项差异,单看模型分数无法描述它。
八月原始实测:我们怎么测这个循环
既然结论押在循环上,那就真跑一次。我们搭了个小 Python 仓库,里面埋了个真 bug:重试函数 catch 的是 urllib.error.HTTPError,而 OpenAI SDK 抛的是 openai.RateLimitError,所以 429 分支永远进不去,测试挂掉。九个工具里的六个(Codex CLI、Claude Code、Cline、OpenCode、Reasonix、Pi)指向同一个网关,在同一个仓库里给完全相同的提示词:跑测试,用一句话说出根因,用 unified diff 给出修法,一个字都别改。
六个全都说对了根因,这是最没意思的一条结论,所以先说完拉倒。差别在下面。Codex CLI、OpenCode、Cline 先跑了测试再回答;Claude Code、Reasonix、Pi 靠读代码直接答。修完之后留下的那行没用的 import urllib.error,Codex 在正文里点出来了,Claude Code 在 diff 里悄悄删掉了,另外四个原样留着。还有,六个里有四个交出来的补丁仍然带着 if e.code != 429 这道判断。三个是明写出来的,一个是只改了 except 那行、把它原封不动留下了。一旦你 catch 的是 openai.RateLimitError,这道判断就永远进不去:它的 .code 是 API 返回的字符串错误码,从来不是 HTTP 状态码(状态码在 .status_code 里),所以 e.code != 429 恒为真,重试分支不可达。
最后这条更像是模型的问题而不是 harness 的问题,而这恰恰是重点:由 harness 决定循环要不要自己验一遍补丁,而这六个一个都没验。
Copilot、Cursor 和 Antigravity 没有参加那次六工具同题测试。当时的访问条件与可用账号限制了测试范围。这是历史测试边界,不代表现在所有 BYOK 用户都需要付费 Copilot 席位。下文的文档更新不是新的执行结果。
当前用量列表里出现了哪些模型
以下是 2026 年 10 月 20 日各页面“Top models used … this month”列表的快照。这里保留来源的“本月”标签,不能认定它与八月表格使用相同的滚动 30 天窗口。T 表示万亿 token。用量不是质量评分、价格比较、独立用户数或市场份额。
| Harness 与来源 | 列表第一 | 第二 | 第三 |
|---|---|---|---|
| Claude Code | Claude Opus 5.5 — 7.16T | GLM 5.3 Flash — 6.55T | DeepSeek V4.1 Flash — 5.37T |
| Codex | GPT-6 Luna — 2.73T | DeepSeek V4.1 Flash — 1.99T | GPT-6 Astra — 1.9T |
| Cline | Space Bunny Alpha — 8.33T | MiMo-V2.6-Flash — 3.47T | Muse Spark 1.3 Contributor — 2.75T |
| Pi | DeepSeek V4.1 Flash — 4.8T | GLM 5.3 Flash — 1.78T | Space Bunny Alpha — 1T |
这改变了原来的结论:GLM 5.2 已不是该页面当前 Claude Code 用量第一,DeepSeek V4 Flash 也不再同时领先 Cline 和 Pi。不要按八月的结论决定新的接入方案。这些计数只描述 OpenRouter 看得到的流量,直接订阅和其他提供商都不在样本中。用量列表里出现预览或匿名模型,也不代表适合让生产任务依赖它。
选择模型时,先在实际使用的提供商处核对精确 ID 和支持的协议,再跑一个有预期 diff 和测试结果的小型仓库任务。OpenRouter 用量不能证明 Ofox 提供相同模型,也不能证明另一条路由上的工具行为相同。
8 月 11 日历史快照
保留下图是为了让读者识别原文引用的数据。它覆盖截至 2026 年 8 月 11 日的 30 天,不是今天的选型建议,也不能与上表直接作同口径增长比较。
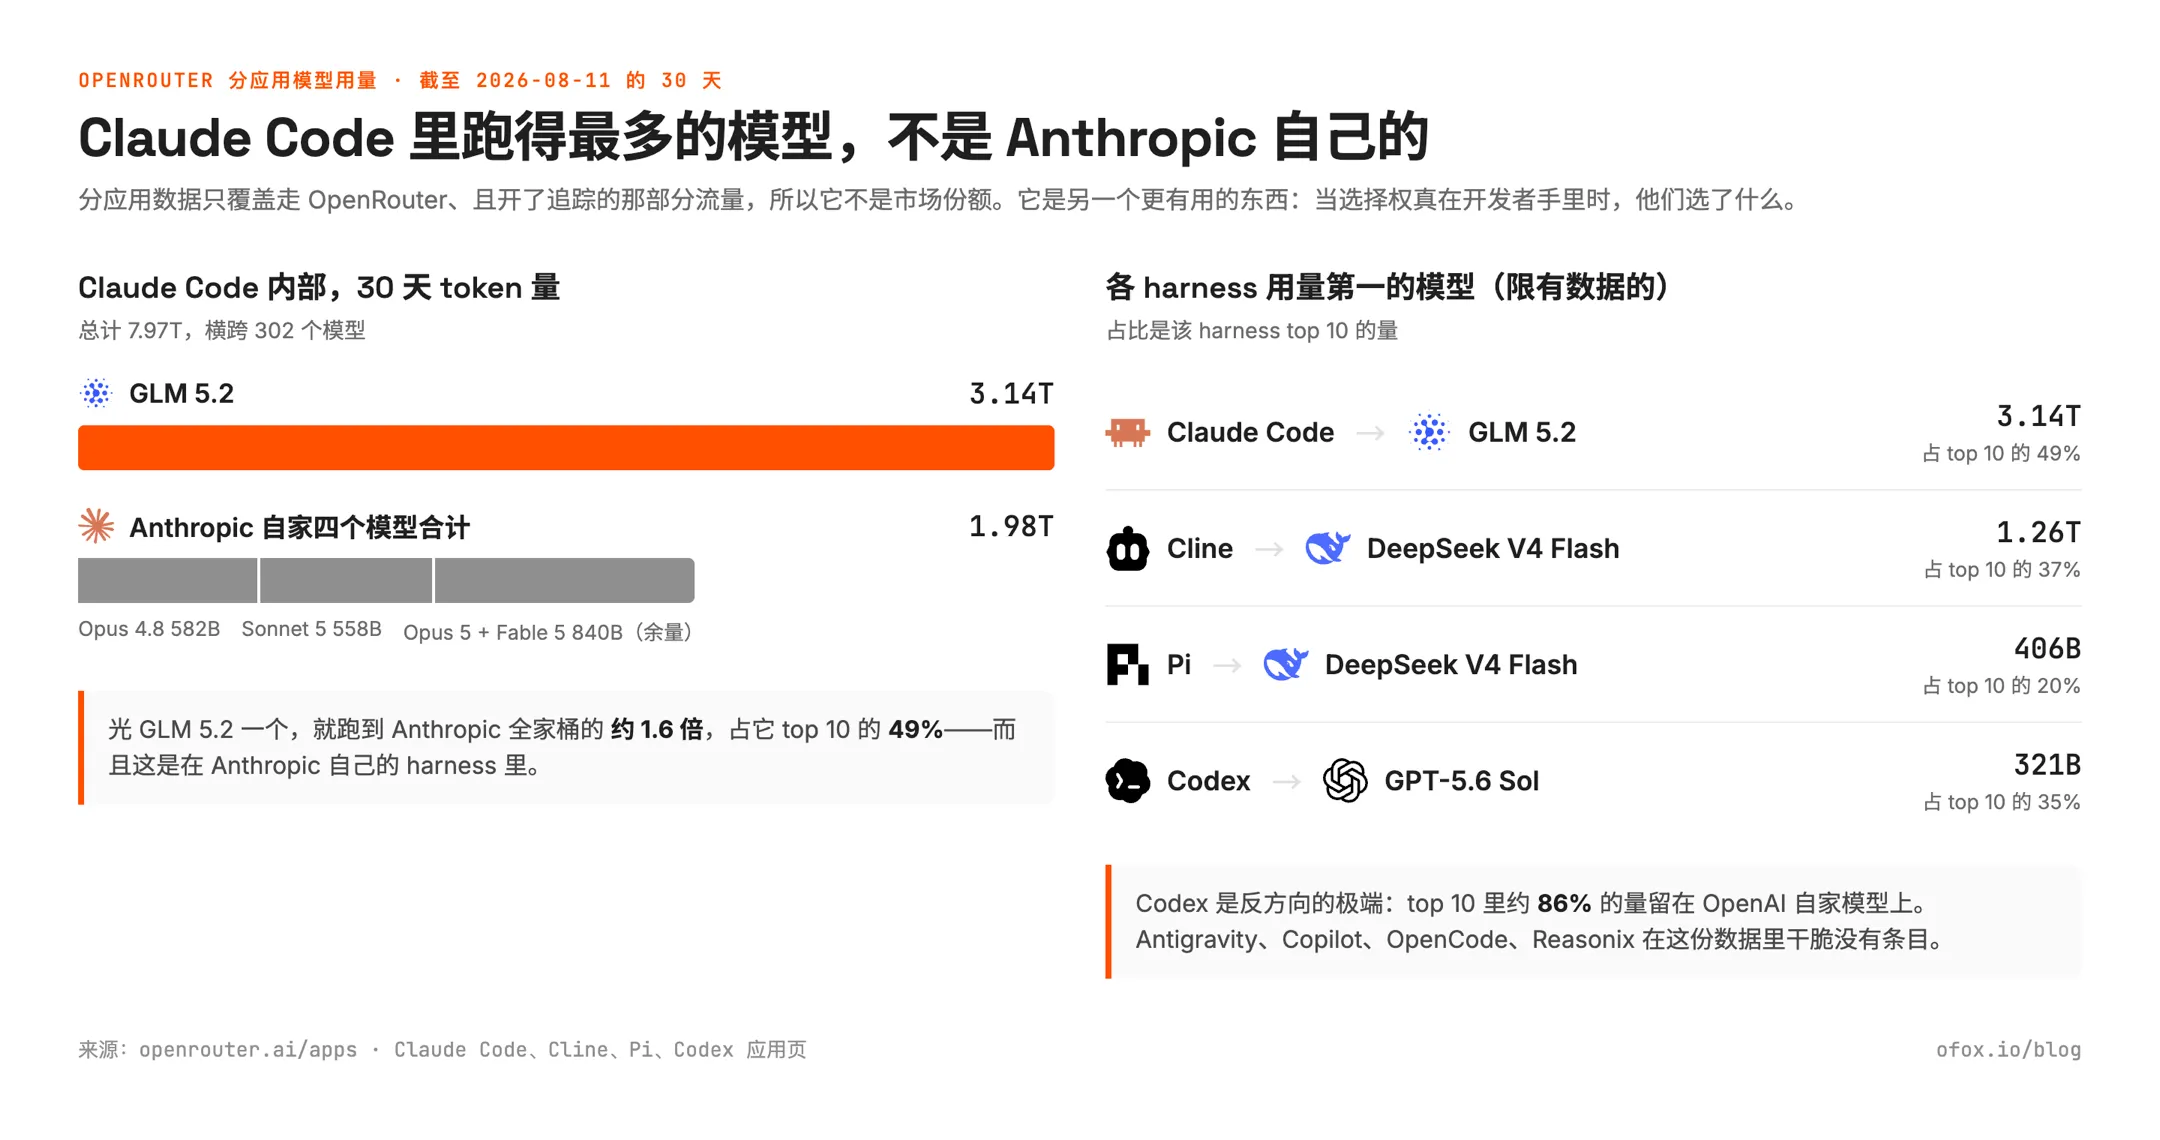
在旧快照中,Claude Code 的 GLM 5.2 用量为 3.14T token,四个已列出的 Anthropic 模型合计 1.98T;Codex 前十模型的用量中约 86% 来自 OpenAI。这些历史观察不能证明当前偏好、模型质量或用户选择某个模型的原因。
原始测试时期的模型搭配示例
以下保留原始模型搭配示例,不是当前可用性清单或最便宜模型排名。版本名称和历史用量理由用于说明原来的配置语境。复制 ID 前,请查当前目录并验证真实工具调用往返。表中“为什么”一列是原文发布时的判断:
| 你已经在用 | 优先试 | 为什么 |
|---|---|---|
 GLM 5.2 | Claude Code,其次 OpenCode | 历史配置使用 Anthropic 兼容接口,它当时也领先于该用量快照。仍须验证认证、模型选择和工具兼容性,不能认为改 URL 就够了。如果你在纠结托管还是自己拿权重部署,那笔硬件账和 harness 选型是两回事 |
 DeepSeek V4 Flash | Reasonix,其次 Cline | Reasonix 的循环是围着 DeepSeek 的前缀缓存造的;Cline 则是这个模型量最大的地方 |
| DeepSeek V4 Pro | OpenCode,其次 Pi | 两个都支持把 Flash 设为默认、按任务临时升配 |
 Kimi K3 | Claude Code | Anthropic 兼容端点,而且它已经在 Claude Code 的前十里了 |
 Qwen 3.8 Max | Codex CLI | 少数几个能走 Responses API 的非 OpenAI 模型之一,而 Codex 只认这个 |
 MiniMax M3 | Cline,其次 OpenCode | 标准 OpenAI 兼容 Chat Completions,不用折腾协议 |
 GPT-5.6 Sol | Codex CLI | 第一方默认配置,调优假设也对得上 |
Codex CLI:OpenAI 的 agent,以及定义了它的那个协议
跑在哪
只有终端,一个 Rust 二进制,npm i -g @openai/codex 装,另外配一个独立桌面应用。配置在 ~/.codex/config.toml,项目指令写 AGENTS.md。原来的 OpenRouter 排名描述的是八月数据集,不是整体采用率;直接通过 ChatGPT 套餐产生的用量不在该数据集中。
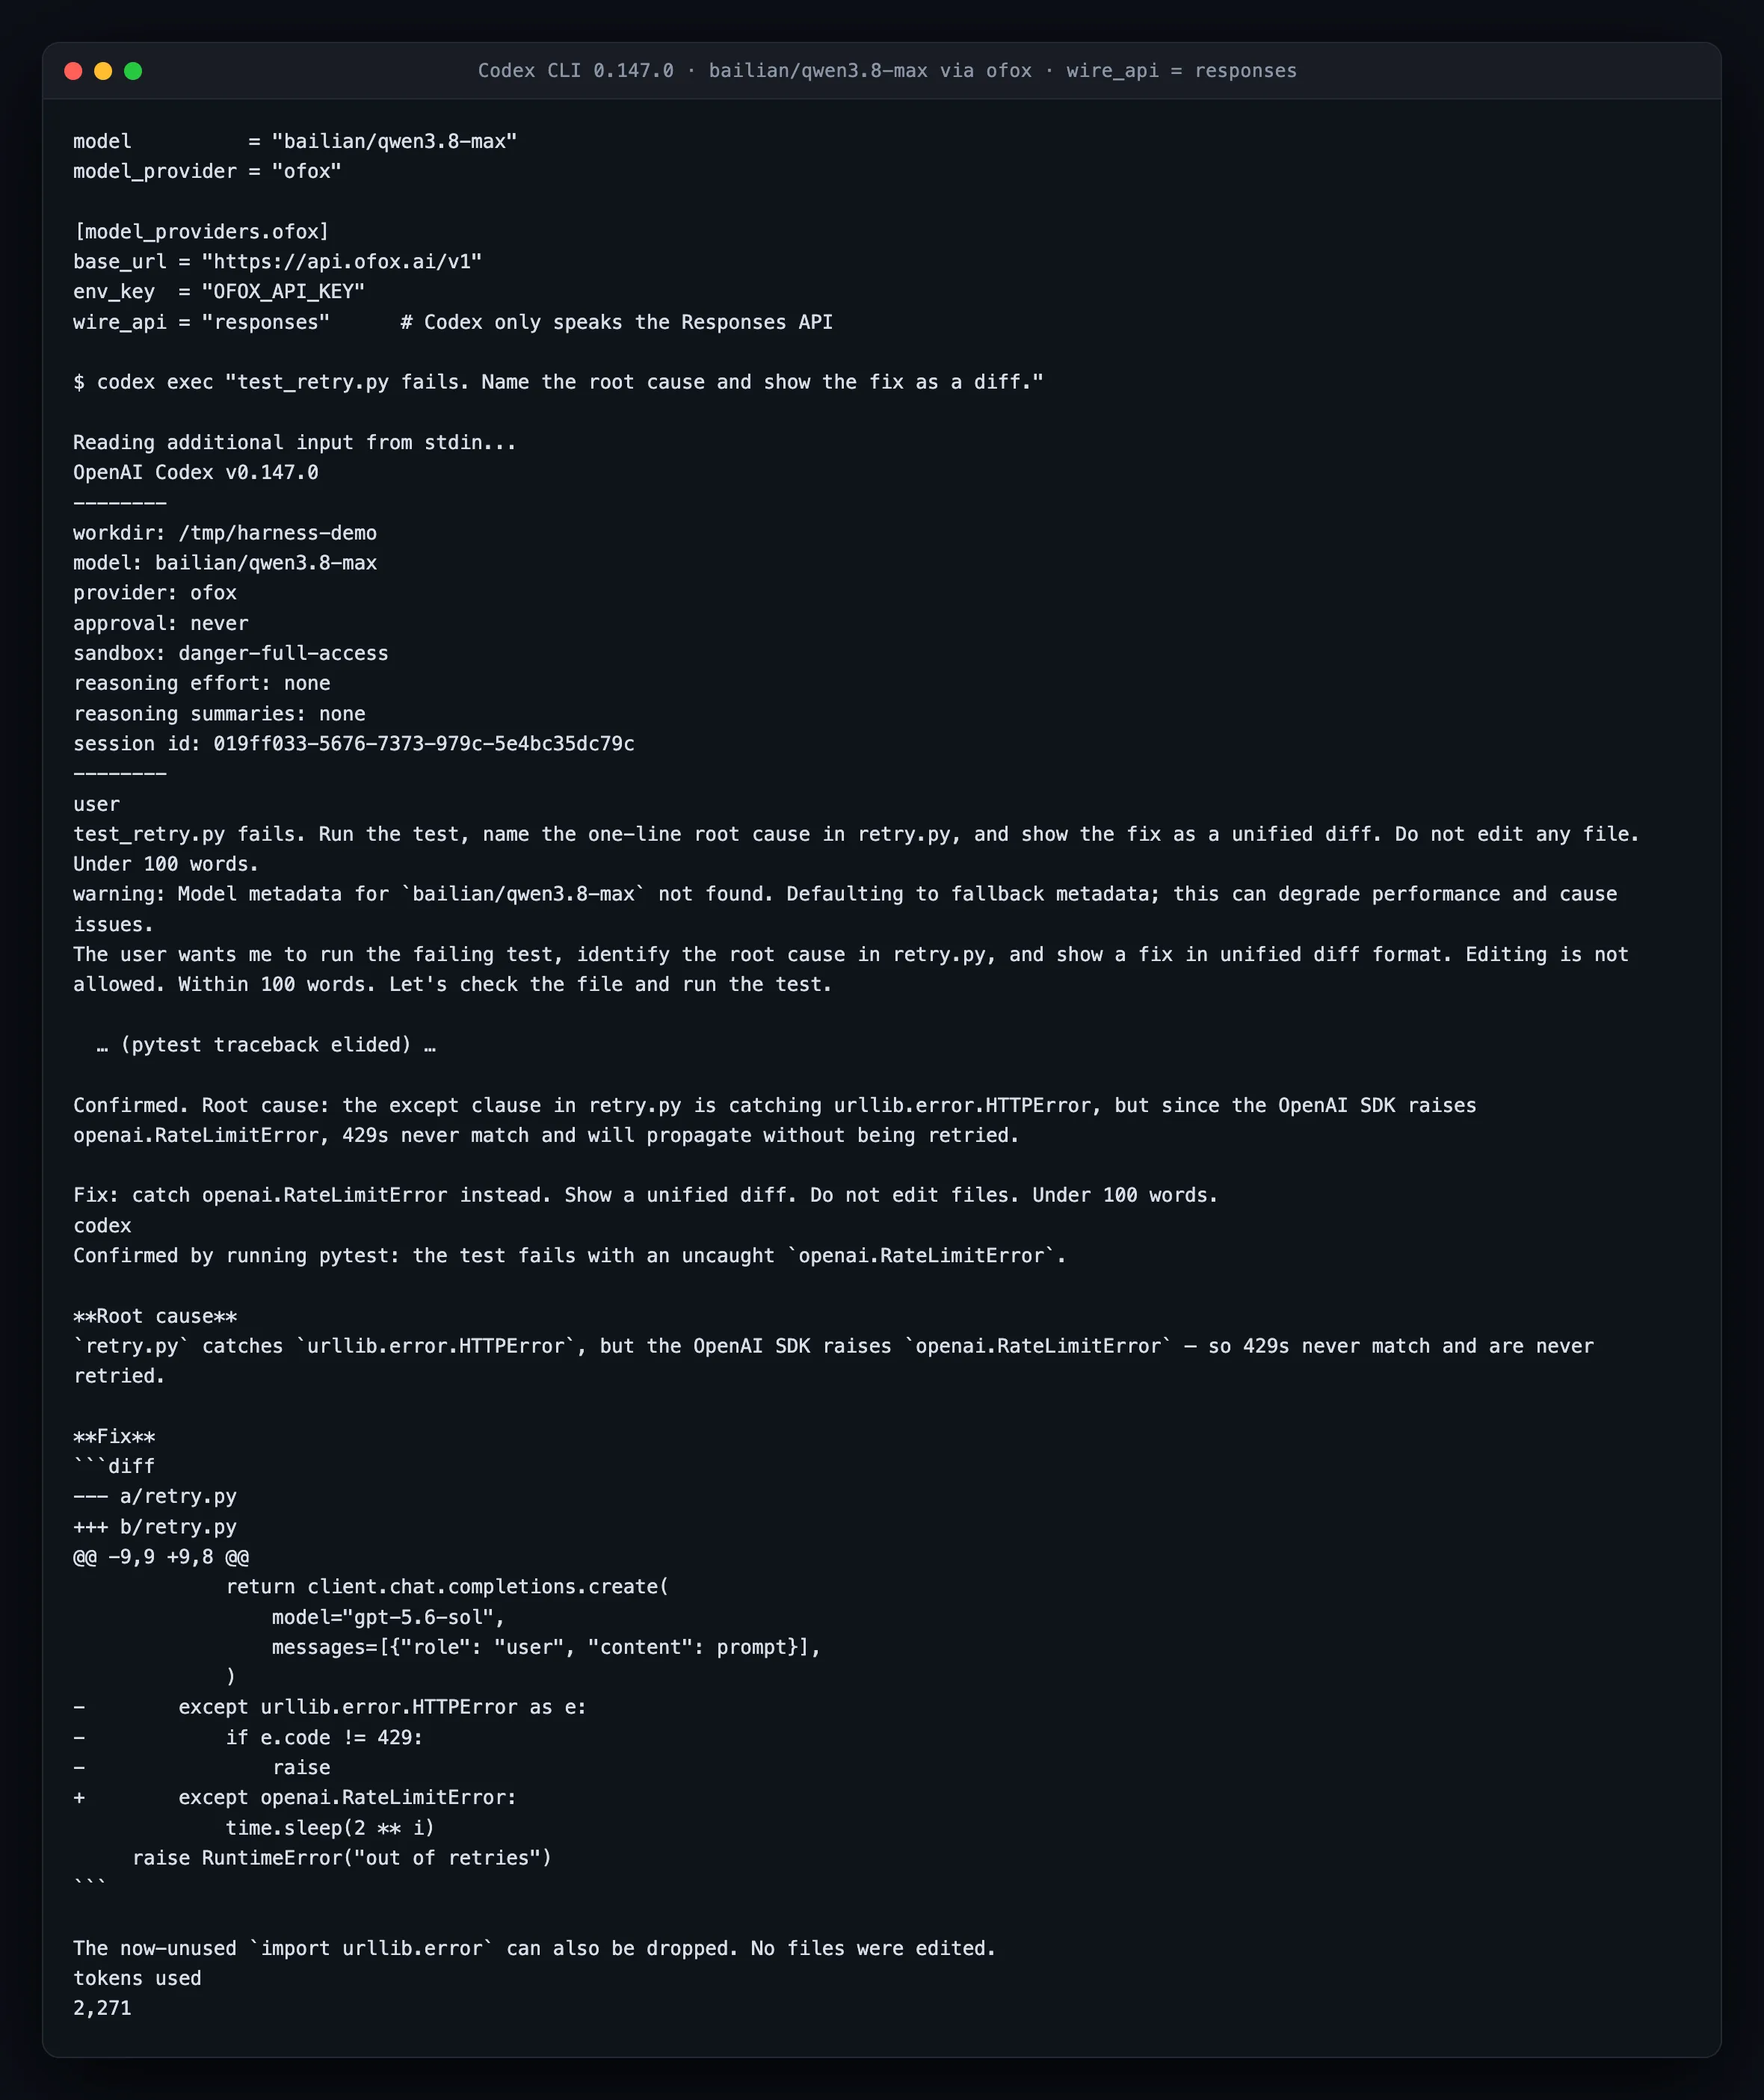
花多少钱
绑在 ChatGPT 订阅里,或者拿 API key 按量付。它 OpenRouter 上的数据被低估,就是因为这个绑定。
靠什么扩展
AGENTS.md、MCP server,还有一条能把 Claude Code 和 Cursor 配置导入过来的命令。原始横评检查了它的沙箱机制:操作系统级隔离,macOS 用 seatbelt,Linux 用 Landlock 加 seccomp,上面再叠审批模式。如果你习惯自动放行 shell 命令,这个差距是能折算成钱的。
会被锁在哪
被锁的是协议,不是厂商。所测 Codex 版本使用 OpenAI Responses API,并拒绝了已移除的 wire_api = chat 选项。所以网关必须暴露 /v1/responses,光有 /v1/chat/completions 不行,而且支持与否是按模型算的,不是按网关算的。有两个细节反复坑人:模型 ID 前缀只在自定义 model_providers 条目下才生效;网关目录里列了某个模型,不代表这个模型能走 Responses 通。配置细节见 ofox Codex 集成文档和模型 provider 页。
「按模型不是按网关」这句话听着容易点头,但很难想象具体长什么样,所以说说我们撞上它时的情形。Codex 0.147.0 配了正确的 provider 块,每个请求都返回 Invalid 'input[0].tools[0].description': empty string。我们在网关前面架了个会落盘的反向代理,把 Codex 实际发出去的请求体读了一遍:它在一条 developer 消息里声明工具命名空间,而 functions 这个命名空间带的是 description: ""。拿同一个请求体重放到五个模型上,三个拒绝,一个压根没有 Responses provider,一个通过。把那个空字符串填上,原本失败的模型立刻返回 200。这事既不是网关的错也不是我们的错,是客户端发了一个字段,有的上游按 minLength: 1 校验,有的直接忽略。
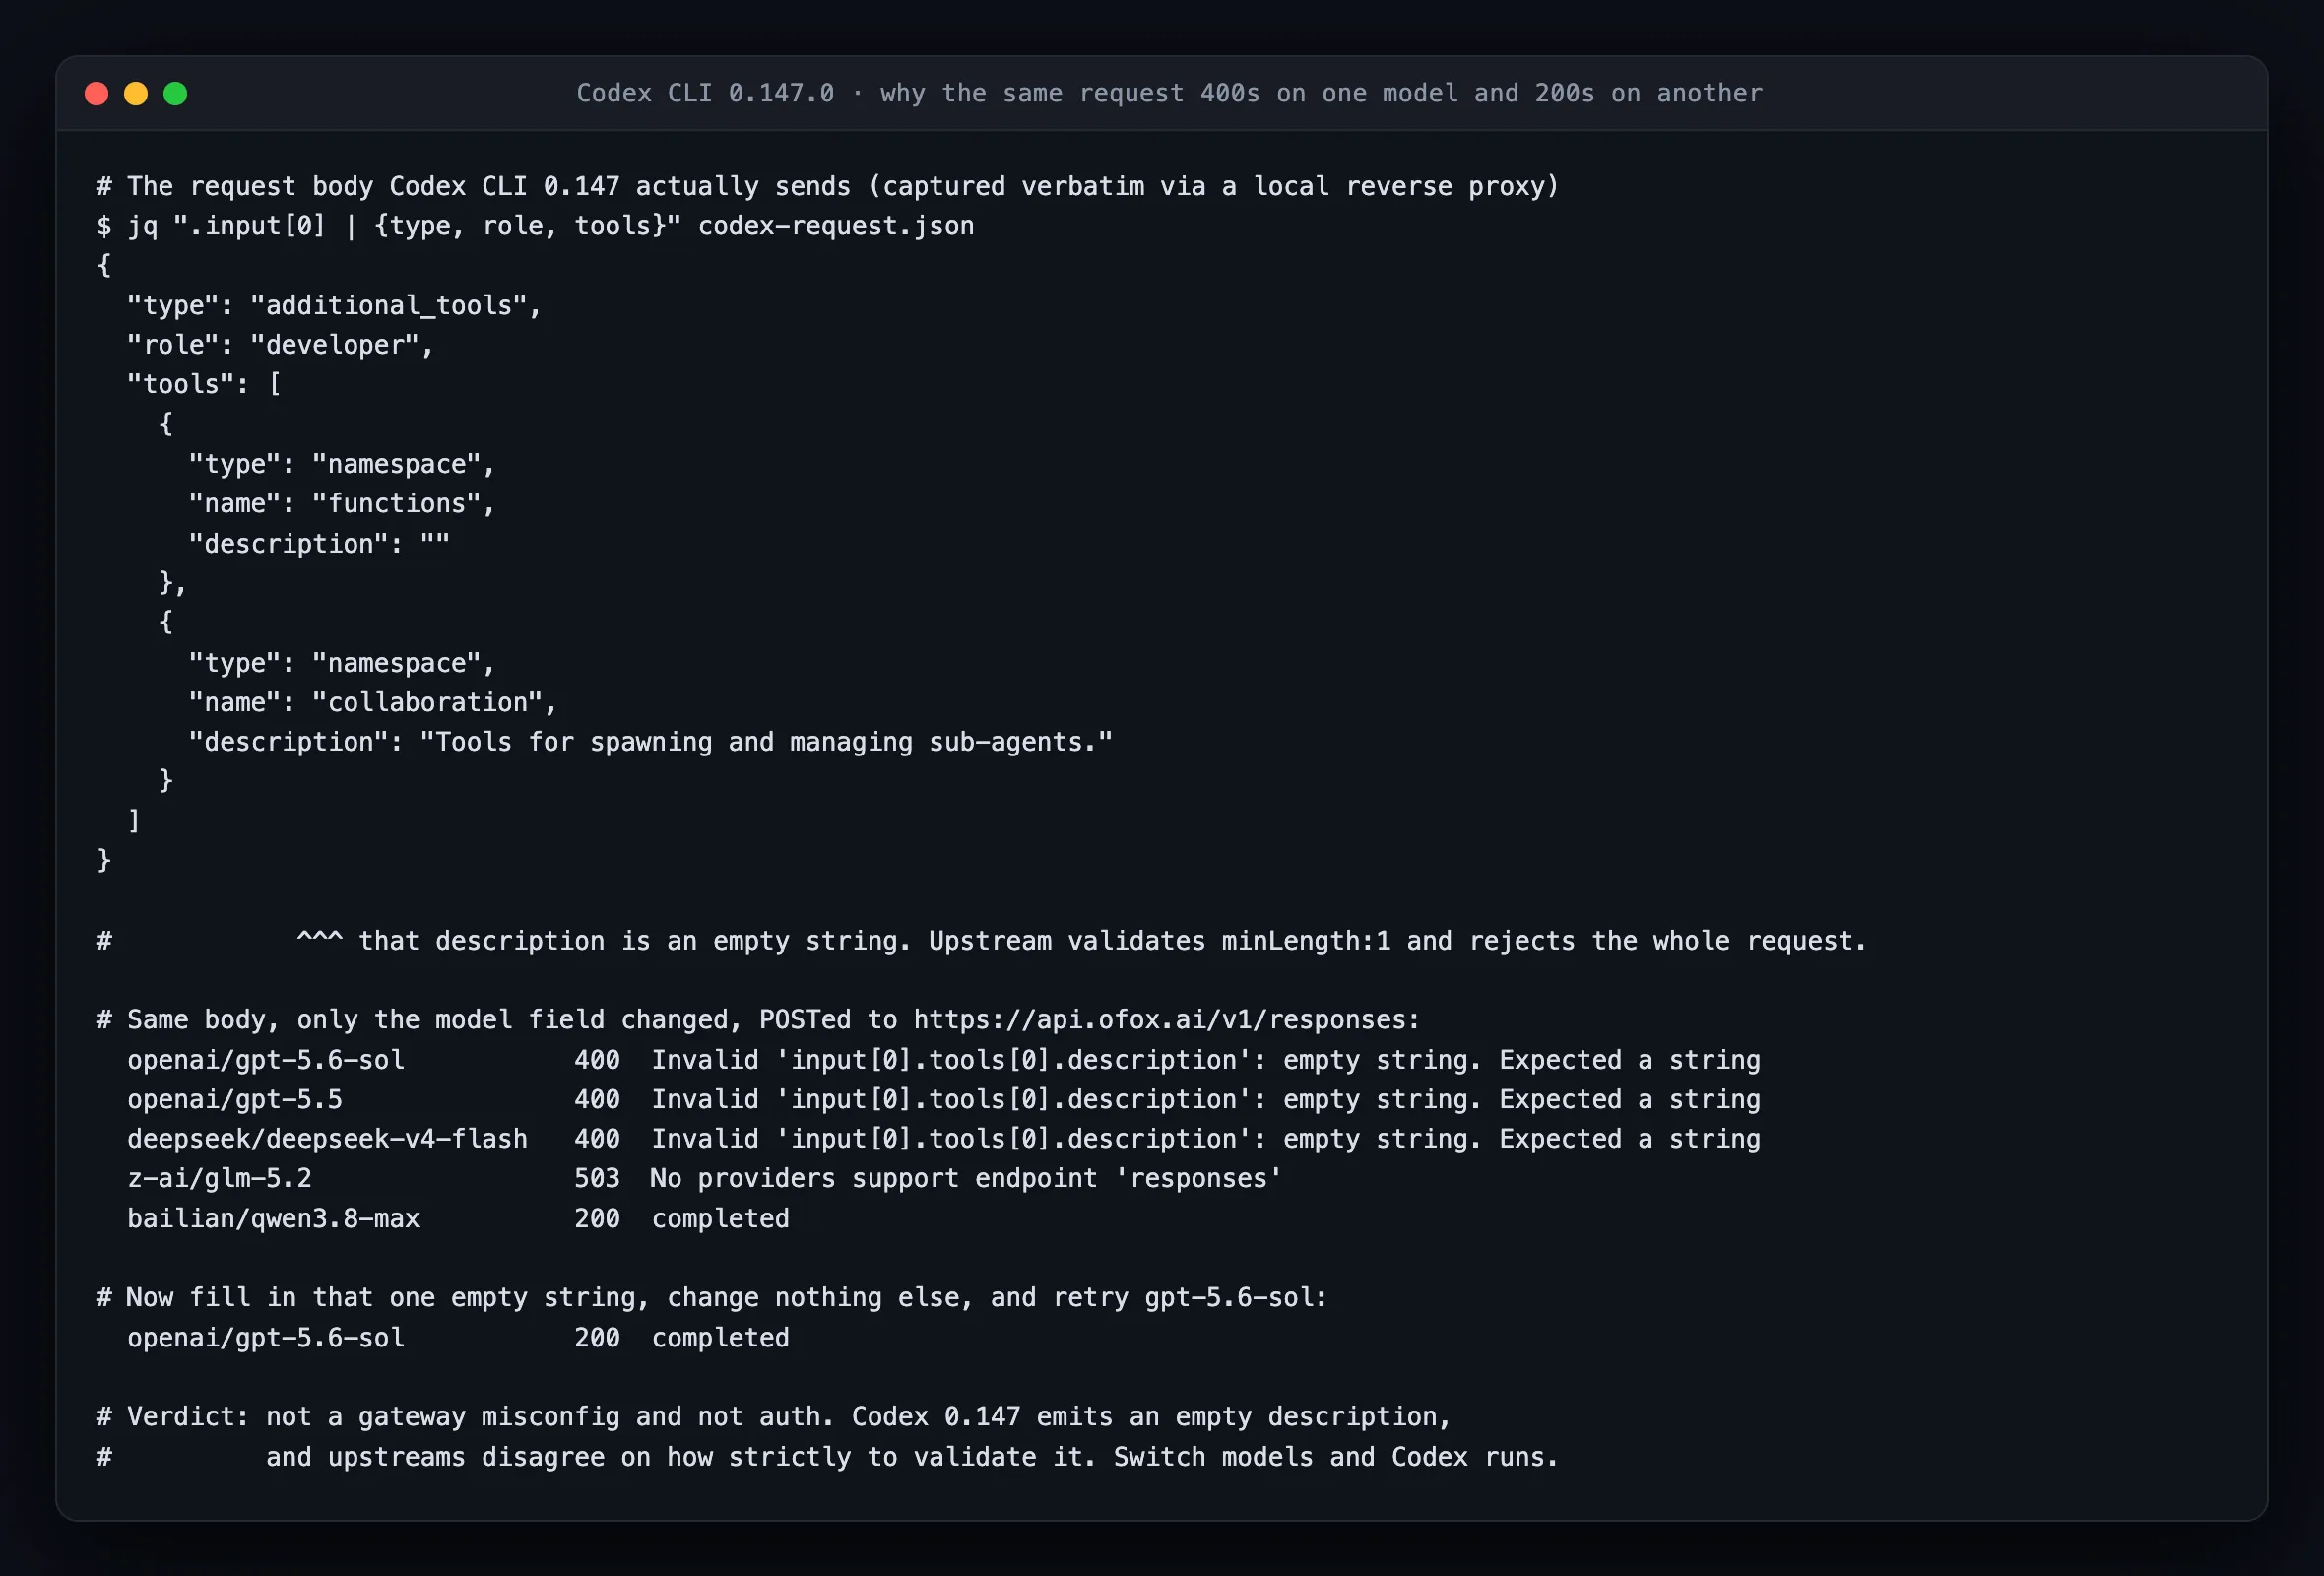
这里能带走的经验对任何 harness 都成立:客户端和网关吵起来的时候,先把线上的请求原文抓下来,再动配置。我们在这上面花了一个代理加五分钟;靠猜 wire_api 的值,得搭进去一个下午,还会得出错误结论。
Claude Code:hooks、子 agent 与模型兼容性
跑在哪
终端,npm 装,带插件生态和一个 IDE 桥接。八月原始 OpenRouter 快照记录了 7.97T token 和 302 个模型;上方更新的月度列表单独列出。
花多少钱
Claude 订阅、API 计费,或者第三方网关。三条路差别大到「Claude Code 要花多少钱」这问题根本没有单一答案。
靠什么扩展
hooks 在工具事件上触发,子 agent 在自己的上下文里跑限定范围的任务,skills 把可复用流程打包,MCP server 加工具,CLAUDE.md 承载项目指令。如果你想让 harness 承载团队流程而不只是个人习惯,可以评估这些能力是否符合需求。
会被锁在哪
比名字暗示的少得多。ANTHROPIC_BASE_URL 和 ANTHROPIC_AUTH_TOKEN 能把它指向任何讲 Anthropic Messages API 的端点,这正是 GLM 5.2、Kimi K3 和 DeepSeek 出现在它用量数据里的原因。下面的历史配置使用了这些环境变量,模型选择和工具兼容性仍须验证:
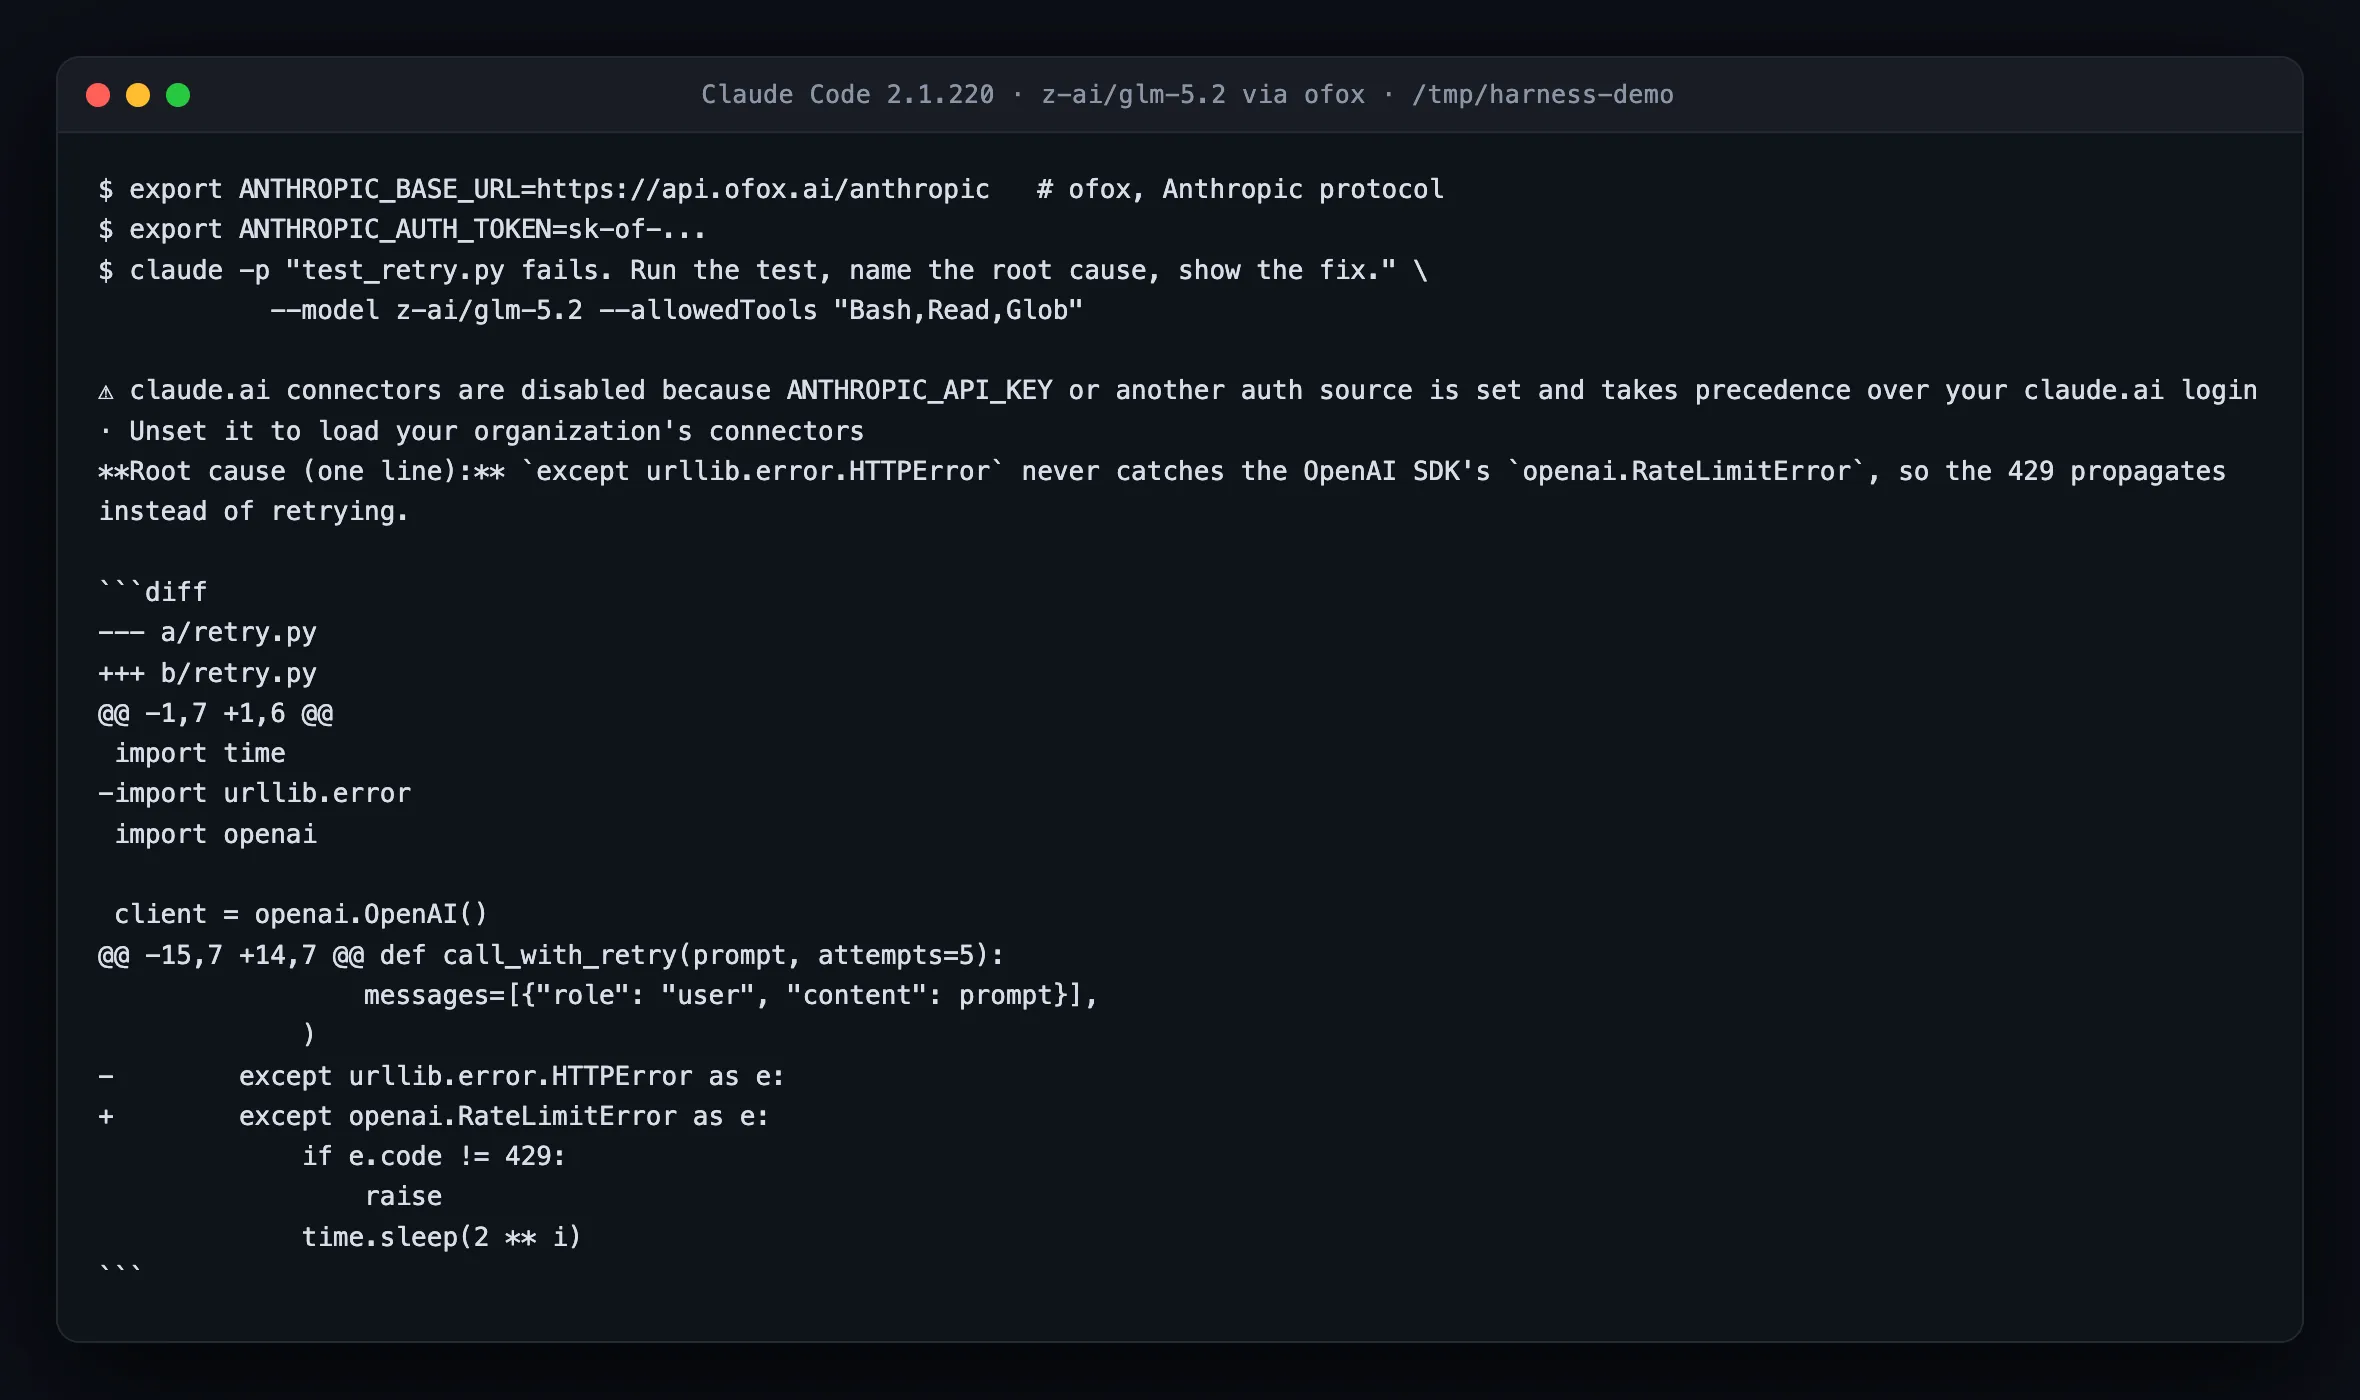
注意什么东西换过去了、什么没换过去。GLM 5.2 把异常类型不匹配这一点说对了,但它的补丁保留了 if e.code != 429 这道判断,而这道判断永远进不去:在 openai.RateLimitError 上,.code 是字符串错误码,不是 HTTP 状态码。同一个 harness、同一个提示词、换个模型,diff 就微妙地差一截。真正的锁定是行为层面的:系统提示词、工具 schema、上下文策略都是照着 Claude 模型调的,换进来的模型继承的是为别人准备的假设。具体变量见 ofox Claude Code 集成文档和它的模型 provider 页。如果你要往反方向走,我们写过从 Claude Code 迁到 Codex 的分步指南。
Google Antigravity:一个牌子,四个入口
跑在哪
到处都是,这正是让人犯迷糊的地方。Antigravity 现在是四样东西:Antigravity 2.0,一个能并行跑多个本地 agent 的桌面指挥台;Antigravity CLI,终端界面;Antigravity IDE,完整编辑器;以及一套自己写 agent 的 SDK。它 2025 年 11 月以 agent 优先的 IDE 身份发布,之后一路往外扩。
有些报道说 Gemini CLI 要停服、由 Antigravity CLI 接手。我们去找了一手来源,没找到。截至 2026-08-11,这个说法没有依据:google-gemini/gemini-cli 仓库没归档、没弃用声明,preview、stable、nightly 三条通道都还在发;antigravity.google 和 Google Developers Blog 都没这么说过。在 Google 亲口说之前,就当两个并存。
花多少钱
八月横评记录的是个人免费档、付费组织档,以及 Google 高档 AI 套餐更高的用量上限。依赖这些历史条件前,请核对当前套餐。你买的是额度,不是 token。
靠什么扩展
2.0 的管理器能同时跑多个 agent,还允许主 agent 派生临时子 agent,让并行任务不污染主上下文。内置浏览器给了它一条用眼睛而不是断言来验证 UI 改动的路。
会被锁在哪
原始横评描述的是内置模型菜单。八月 CLI 测试没有验证自定义网关路径;未出现在 OpenRouter app 列表中,不能证明某个产品是否支持其他提供商。
为完成这项有限检查,我们装了它的 CLI(brew install --cask antigravity-cli,版本 1.1.12),整份选项列表里没有 --base-url、没有 --provider、也没有 --api-key。让它列模型,列不出来,弹给你一堵登录墙。
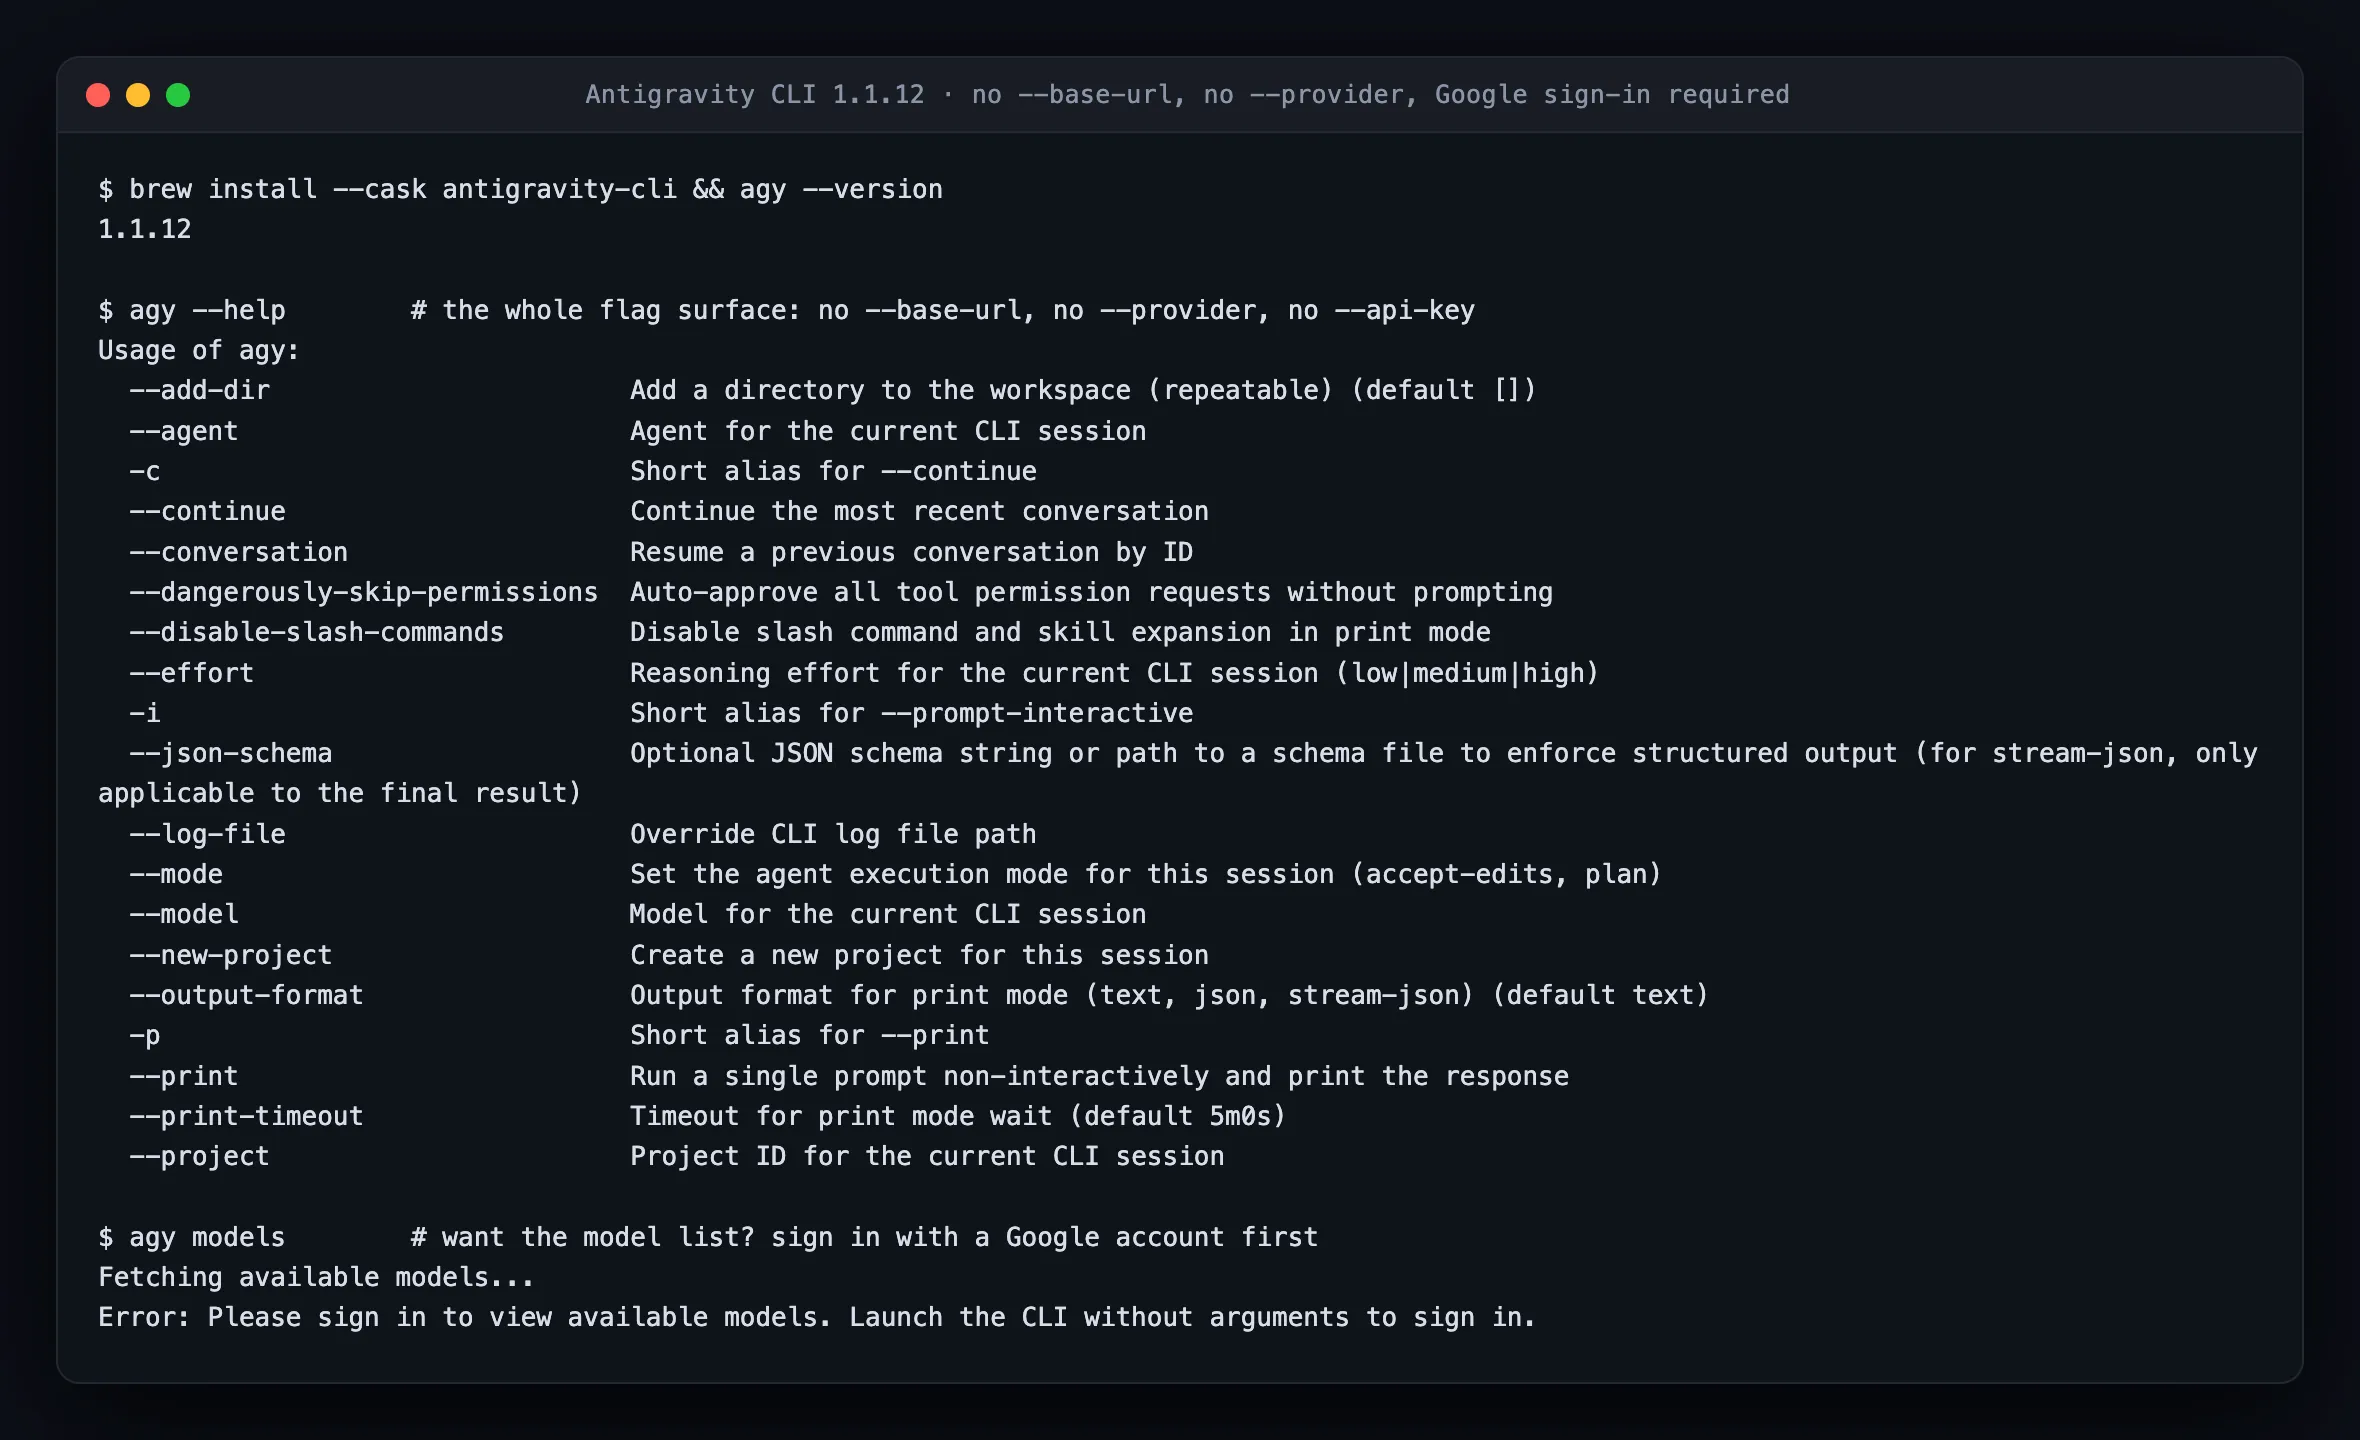
这记录的是八月 CLI 1.1.12 的测试限制。仅仅没有某个命令行参数,不能排除所有其他配置方式,也不能证明当前产品行为。Copilot 和 Cursor 同样未参加同题执行测试,当前 key 支持见下文。
GitHub Copilot:人人都有的默认选项,按 credit 计费
跑在哪
GitHub 能到的地方都有:VS Code 及其他 IDE、终端里的 Copilot CLI、能直接开 PR 的云端 coding agent,以及 GitHub 站内的代码评审。覆盖面就是它的卖点。
花多少钱
请查看 Copilot 当前套餐中的订阅额度和超额规则。本地 BYOK 的提供商账单与 Copilot 包含的用量分开。不要把八月原始套餐数字当作十月报价。
靠什么扩展
MCP server、自定义指令、仓库级配置,CLI 里还有按任务类型自动选模型的功能。
会被锁在哪
10 月 20 日纠正: GitHub 当前 BYOK 文档列出 VS Code、JetBrains、Xcode、Copilot CLI、Copilot app 和 SDK 的本地 key 支持。本地密钥保留在客户端;组织策略可以禁用 IDE 中的本地 BYOK。企业 BYOK 是独立的公开预览机制,由所有者集中配置自定义模型,并有许可和联网要求。因此,第三方 VS Code 扩展已不是唯一接入方式。仍须检查具体客户端支持的提供商与端点配置;这份文档不能证明 Ofox 端点或所有工具在每个 Copilot 界面上都能用。本次没有新增 Copilot 执行测试。
Cursor:编辑器功能与提供商 key 的边界
跑在哪
独立编辑器。八月原始 OpenRouter 快照中排名第 11,30 天用量为 471B token。这是特定网关的历史计数,不能证明整体采用率,也不能说明 OpenRouter 以外的流量有多少。
花多少钱
按席位订阅,上面再叠用量档位。
靠什么扩展
rules 文件、MCP server,以及一套很强的多文件编辑循环。它的 Tab 模型是最多人说「换不掉」的功能,也确实是即便 agent 活儿在别处干、也值得留着这个编辑器的理由。
会被锁在哪
10 月 20 日文档核对: Cursor API key 指南支持列明的提供商密钥,自定义 key 适用于受支持的聊天模型;Tab 仍使用 Cursor 内置模型。提供商模型费用与 Cursor 套餐费用须分开核对,尤其是 Teams 和 Enterprise。不能因为支持某个提供商 key,就推断任意 OpenAI 兼容网关都能用,或每个 agent 功能都已测试。本次没有重跑 Cursor 网关测试,早期 Ofox 兼容性说明也不能作为所有当前 Cursor 限制的证据。
Cline:提供商选择与先规划后执行的循环
跑在哪
VS Code 和 JetBrains 里的扩展。八月原始 OpenRouter 快照中,它排全站第 4、IDE 扩展类第 2。这些是历史排名,不是十月位置。
花多少钱
扩展免费,API 用量另行计费。token 热度本身不能说明用户为什么选某个提供商,也不能说明他们的任务花了多少钱。
靠什么扩展
先规划后执行的两段式、管理并行任务的任务板、MCP server,还有用来验证前端改动的浏览器自动化。它的规划界面确实比大多数终端 agent 强。
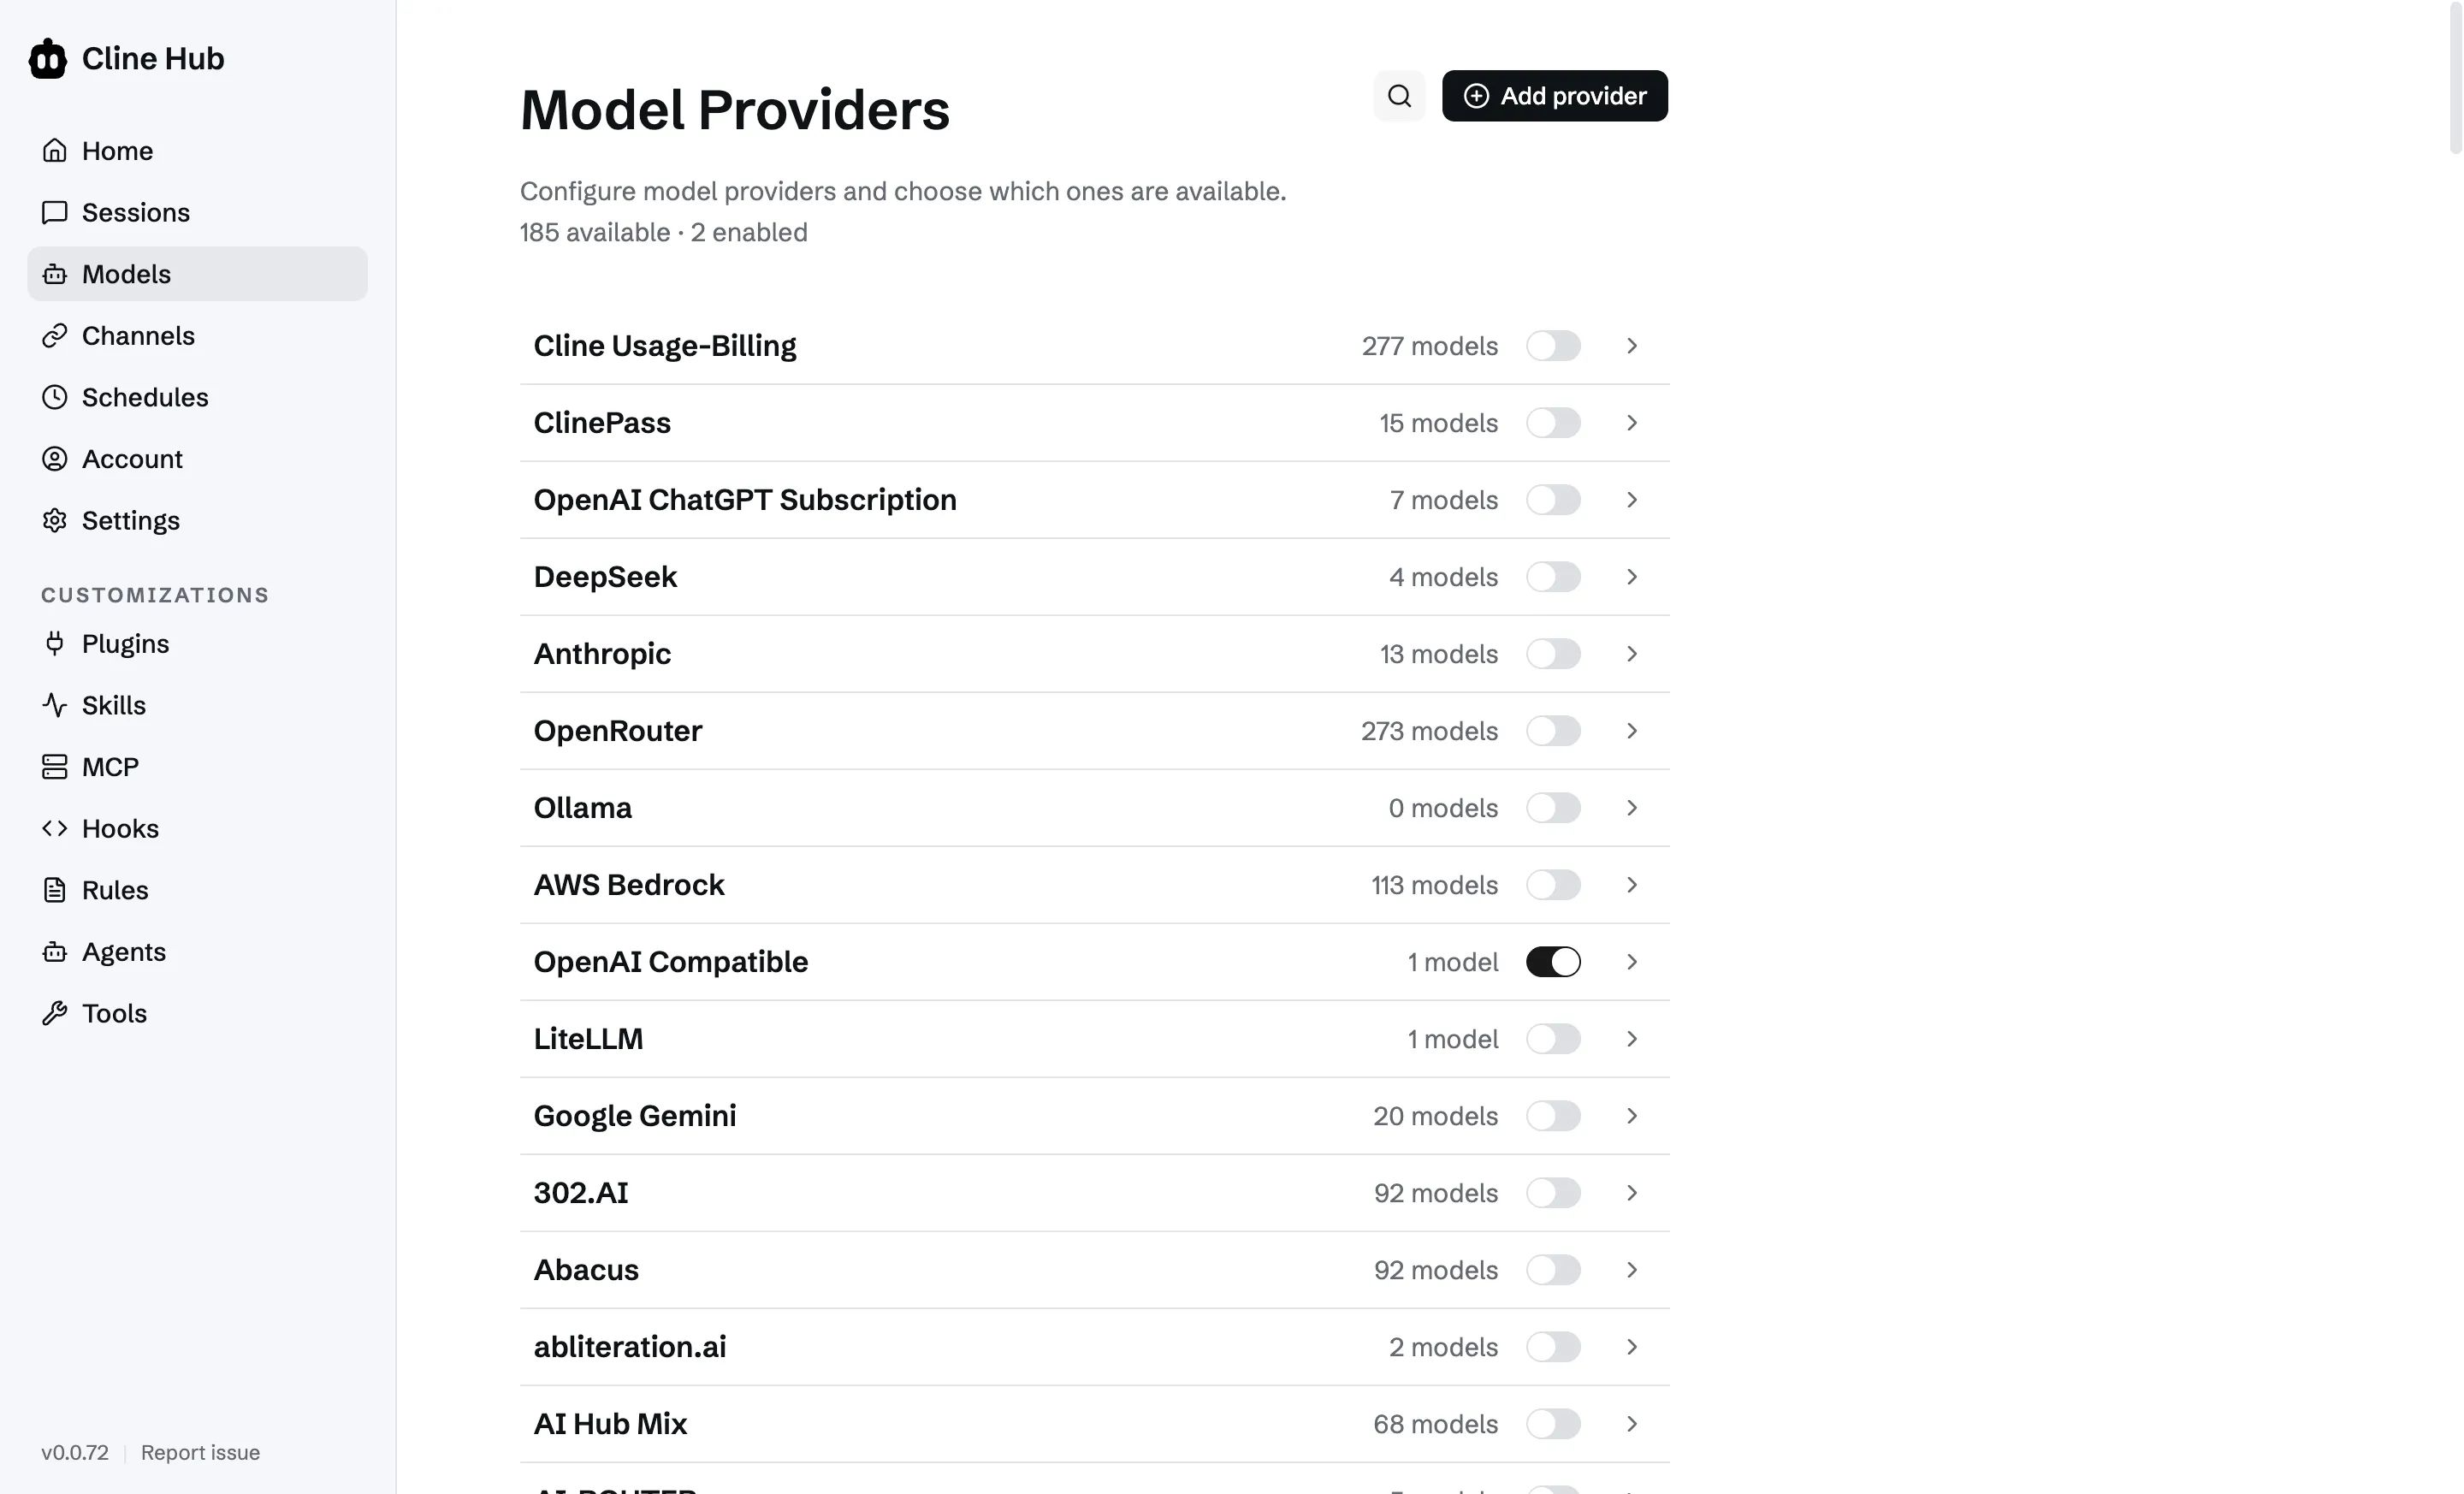
原始测试记录的列表包含 185 个 provider,并明确列出「OpenAI Compatible」入口。这是当时的界面观察,不是当前数量,也不代表每个 provider 的兼容性都已验证。
会被锁在哪
Cline 提供 OpenAI 兼容和 Anthropic 兼容的 provider 设置,但端点、模型和工具 schema 仍须测试。DeepSeek V4 Flash 在八月快照中占前十流量的 37%,这个比例不能解释用户的选择原因。下面的历史执行使用了 cline auth,只验证了一组网关与模型:
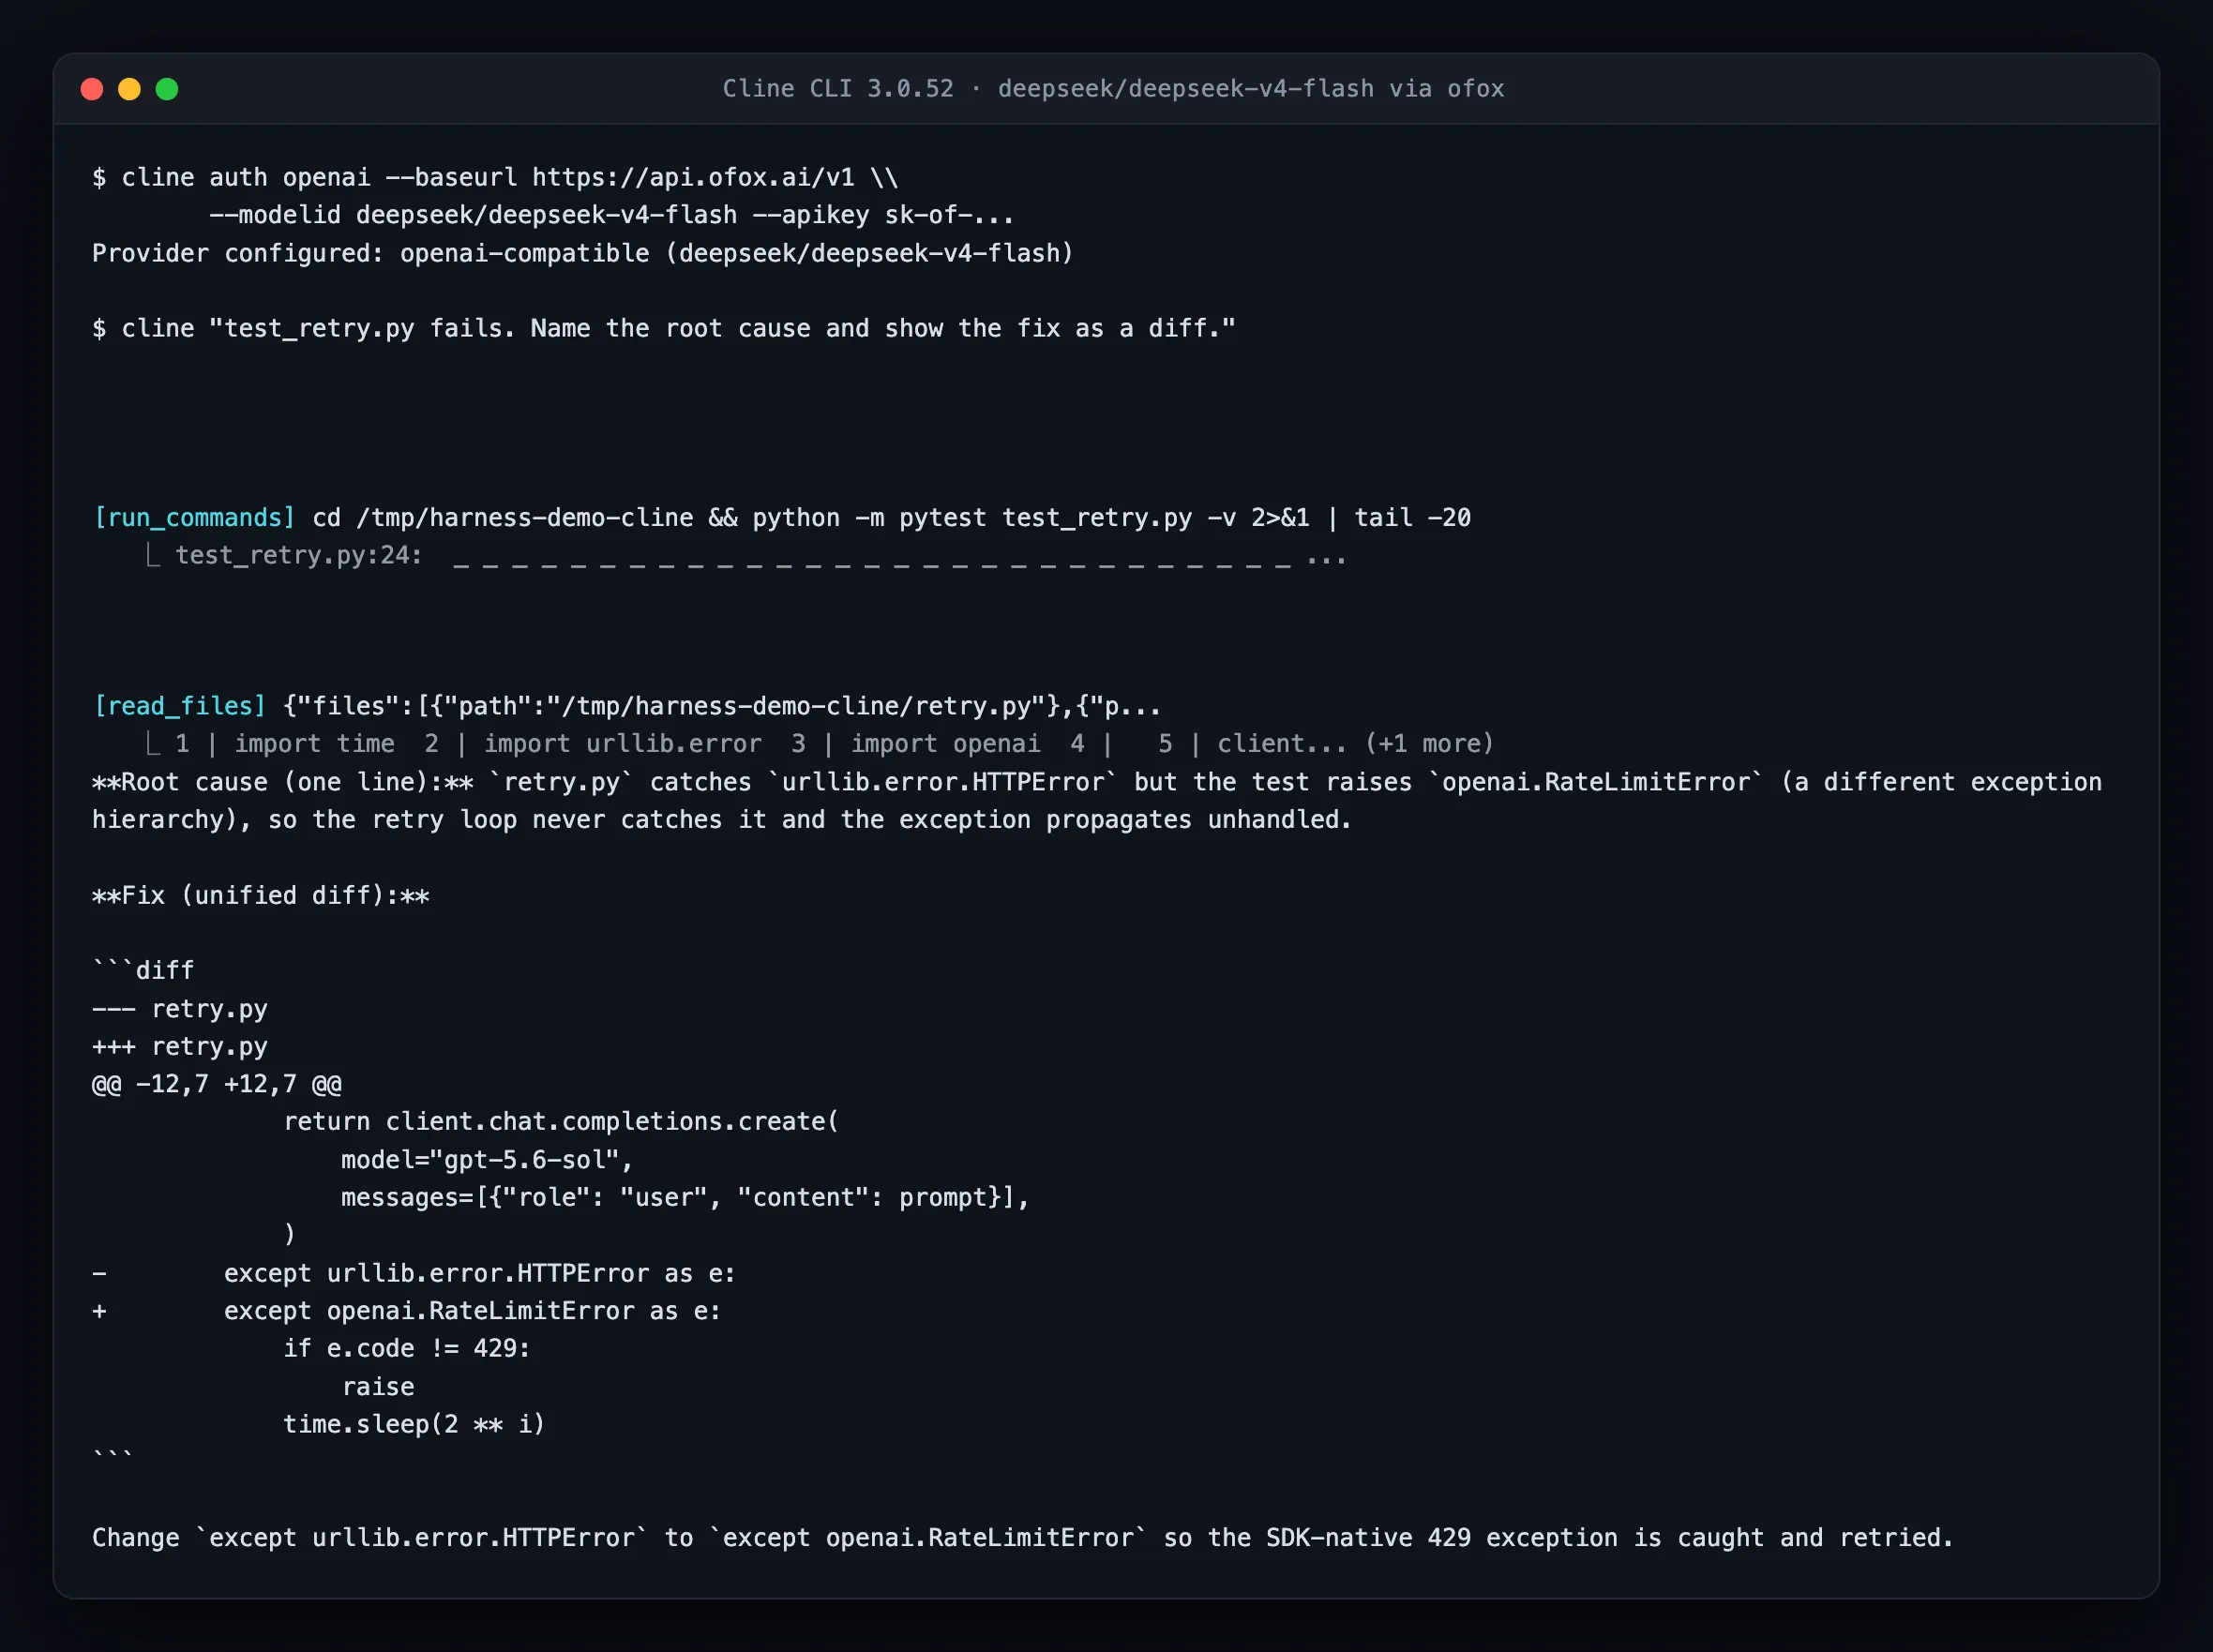
那条 r/AI_Agents 帖子提供了一个循环可靠性的例子:有用户说任务卡在格式错误的工具调用上,后来换用了处理得更稳的分支。这是单个用户的反馈,权重按一条算,但它指向的轴是对的,即循环而不是模型。我们自己也撞到一个相邻的粗糙处:把 CLI 通过 OpenAI 兼容通路指向一个带推理能力的 Claude 模型时,报了个内部错误 text part ... _reasoning_0 not found,而同一端点上的非推理模型跑得干干净净。配置见 ofox Cline 集成文档。
OpenCode:从设计上就不绑模型
跑在哪
终端优先,另有桌面应用和编辑器界面,npm 包名 opencode-ai,MIT 协议,项目指令用 AGENTS.md。它不在 OpenRouter 的 app 榜单上,反映的是没开追踪,不是没人用。
花多少钱
免费开源,你只付 token 钱。
靠什么扩展
AGENTS.md、MCP server,以及一层能覆盖 models.dev 上全部 provider 的 provider 层,我们 2026-08-11 查的时候是 183 个,而且支持会话中途切换。ofox 是内置 provider,所以配置是一个环境变量而不是一段 JSON。
会被锁在哪
结构上没有,这就是它的全部设计意图。同一道排错题,它是把过程展示得最完整的一个:先跑测试套件、打印 traceback,然后读源码再作答。
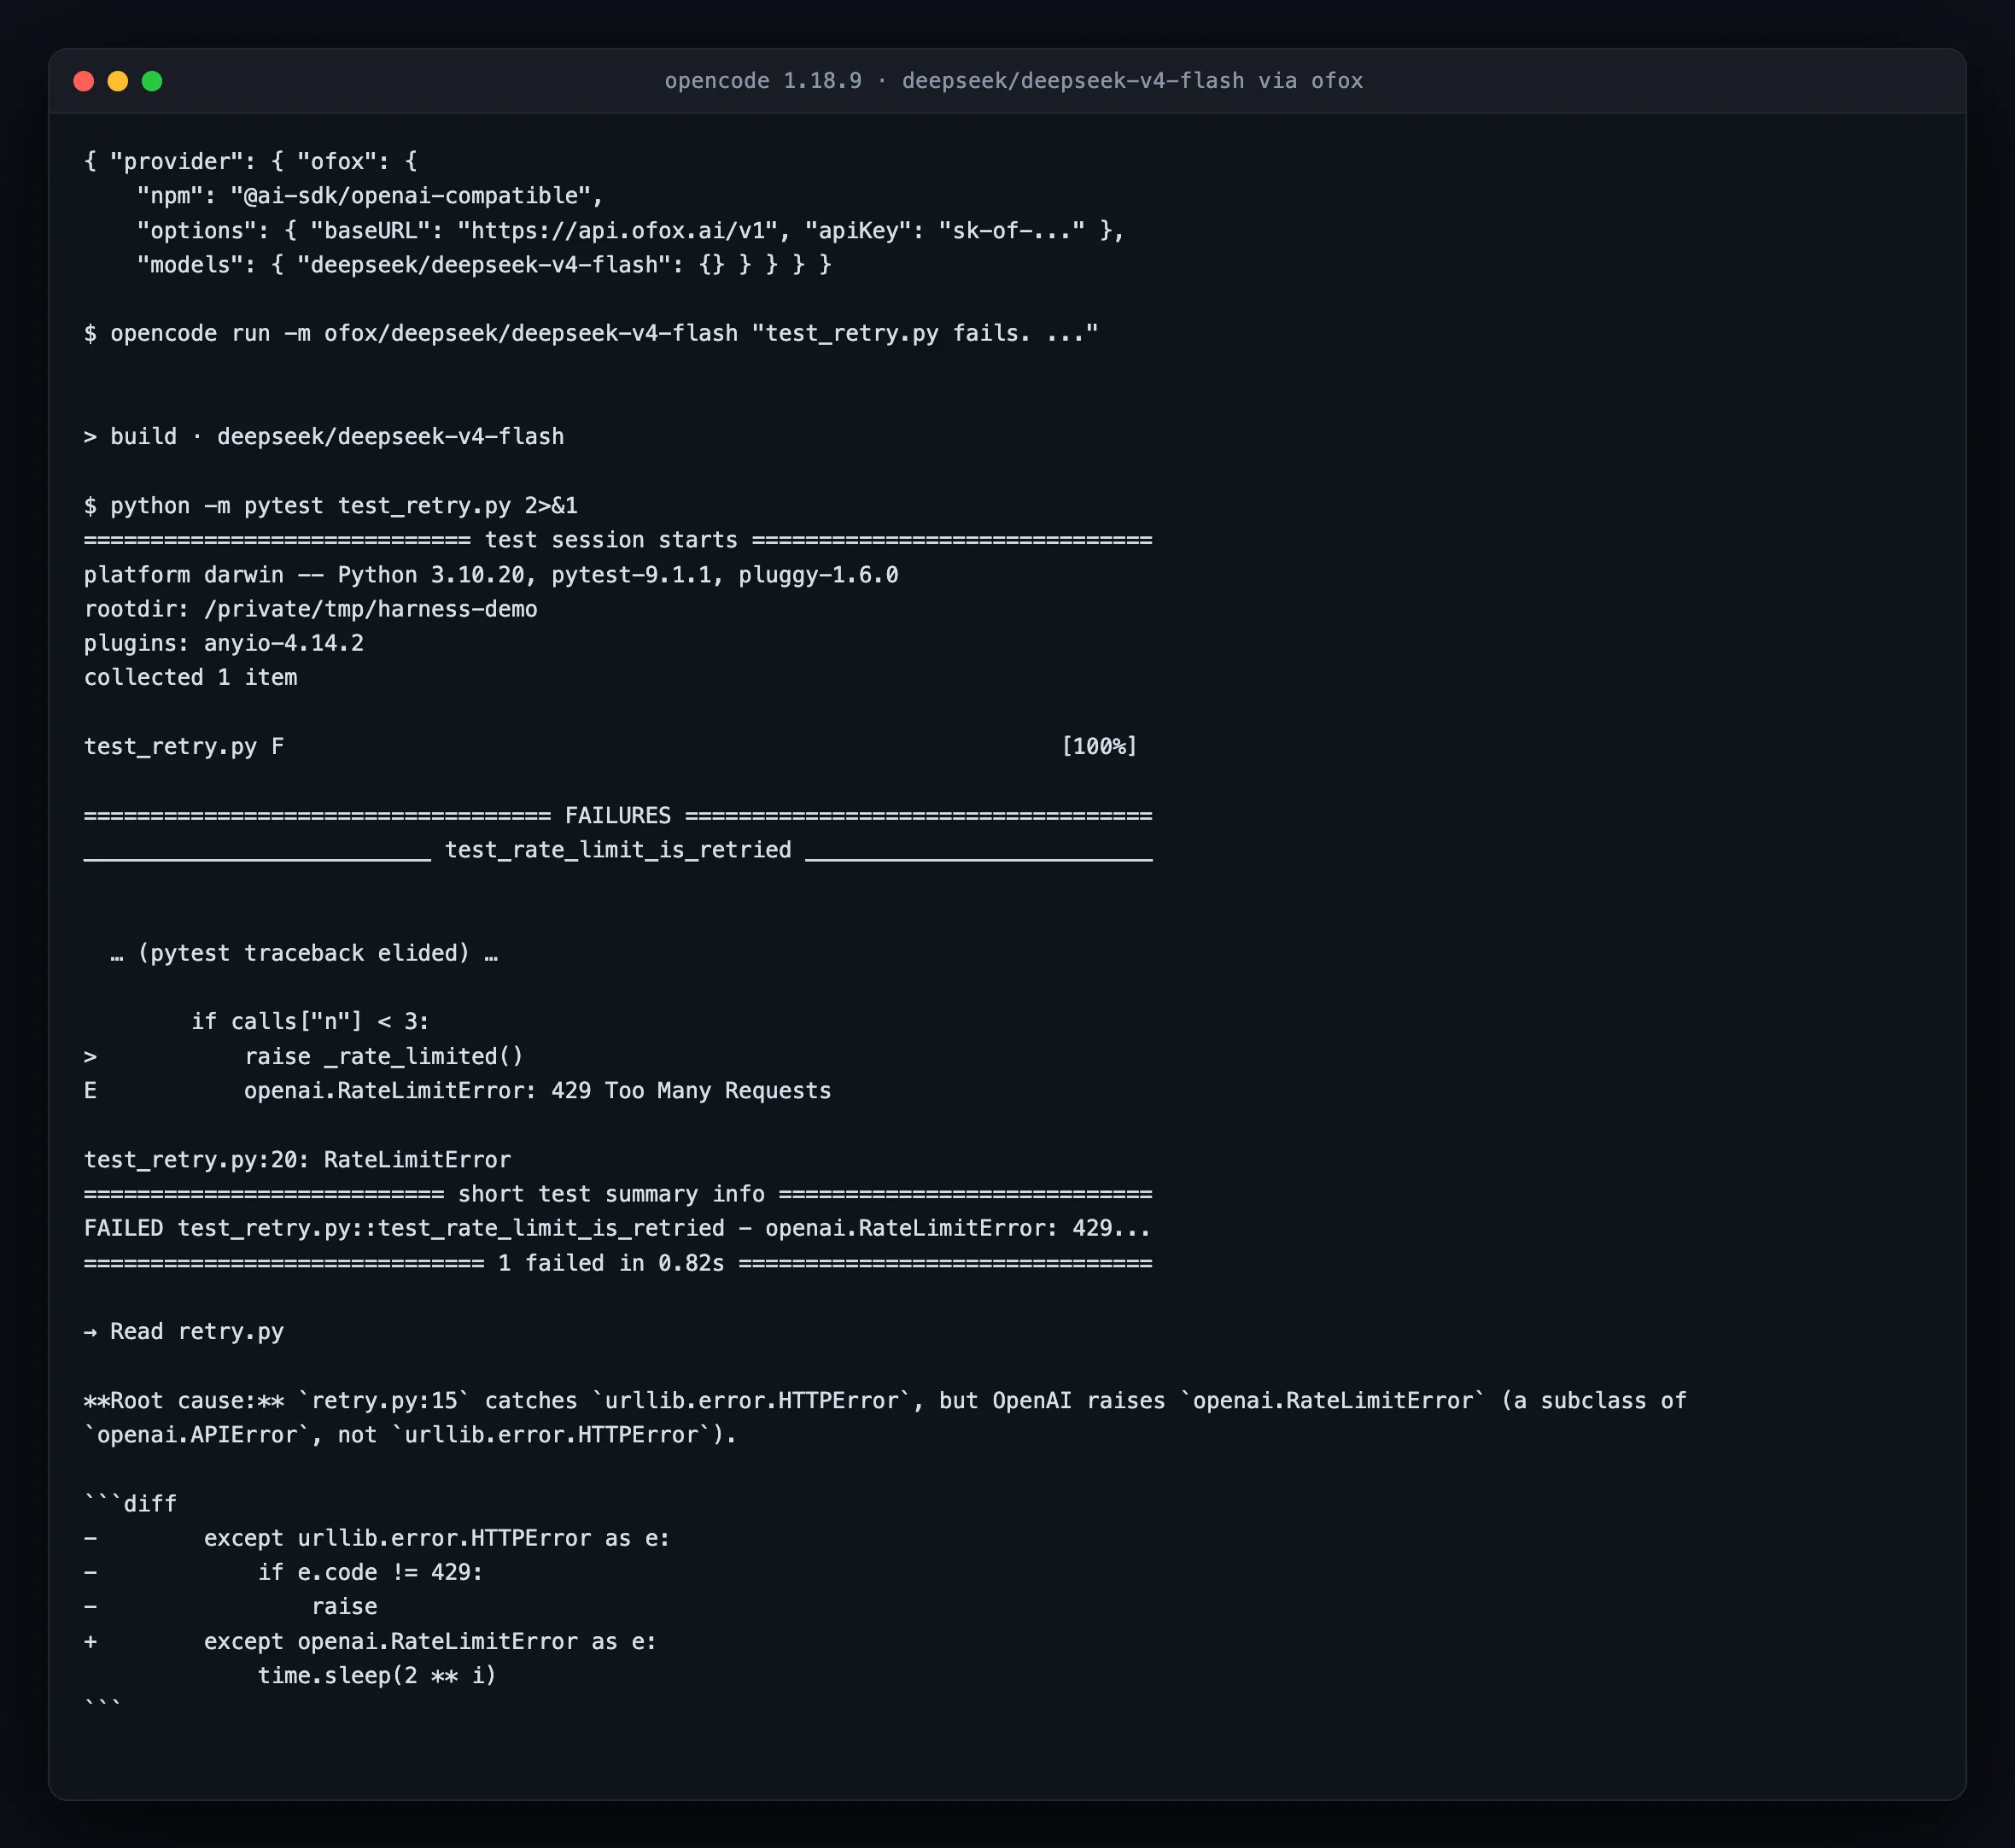
代价是:一个没有默认厂商的 harness,也就没有厂商替你调提示词,所以要把它调到最佳状态,配置量比 Claude Code 或 Codex 大。provider 配置见 ofox OpenCode 集成文档,两个终端 agent 的正面对比我们写在 OpenCode 与 Codex CLI 对比里。
Reasonix:社区出品,围着 DeepSeek 调,缓存优先
跑在哪
一个本地引擎带四个入口:CLI 加 TUI、桌面应用、浏览器界面,以及一个通过 ACP 连同一后端的 VS Code 扩展。它以单个静态 Go 二进制发布,CGO_ENABLED=0,任意系统上 npm i -g reasonix,macOS 上也可以 brew install esengine/reasonix/reasonix。原始测试使用的 1.23.0 版本于 2026-08-10 发布;仅凭这次发布不能判断当前维护状态。
名字这件事得先纠正。Reasonix 不是 DeepSeek 的产品。它是社区项目,仓库在 github.com/esengine/DeepSeek-Reasonix,MIT 协议,自己的站点是 reasonix.io。DeepSeek 官方文档里列的 agent 集成是 Claude Code、GitHub Copilot 和 OpenCode,没提 Reasonix。承载了它大部分报道的第三方站点,页面上自己写了是独立、无从属关系。工具本身是真的、也有意思,但挂在它上面的 DeepSeek 品牌不是官方的。
花多少钱
免费开源,外加你的模型花销。它的设计目标就是让后面这个数字保持很小。
靠什么扩展
MCP server 贡献工具和提示词,Extension Protocol v1 的 sidecar 更进一步,能拦截运行时事件、添加 provider、发布带版本的插件包。所有东西都声明在一份 reasonix.toml 里,不硬编码任何模型。它还配齐了长时间无人值守跑所需、而 Pi 刻意不做的那套安全设施:plan 模式、权限层、工作区沙箱,以及可读可撤销的逐轮 checkpoint。它文档中的设计包括让执行模型和规划模型在两个各自缓存稳定的会话里运行;本文没有证明这项能力为其独有。
会被锁在哪
协议层面没有:任何 OpenAI 兼容端点都是一条配置,reasonix.toml 就是全部:
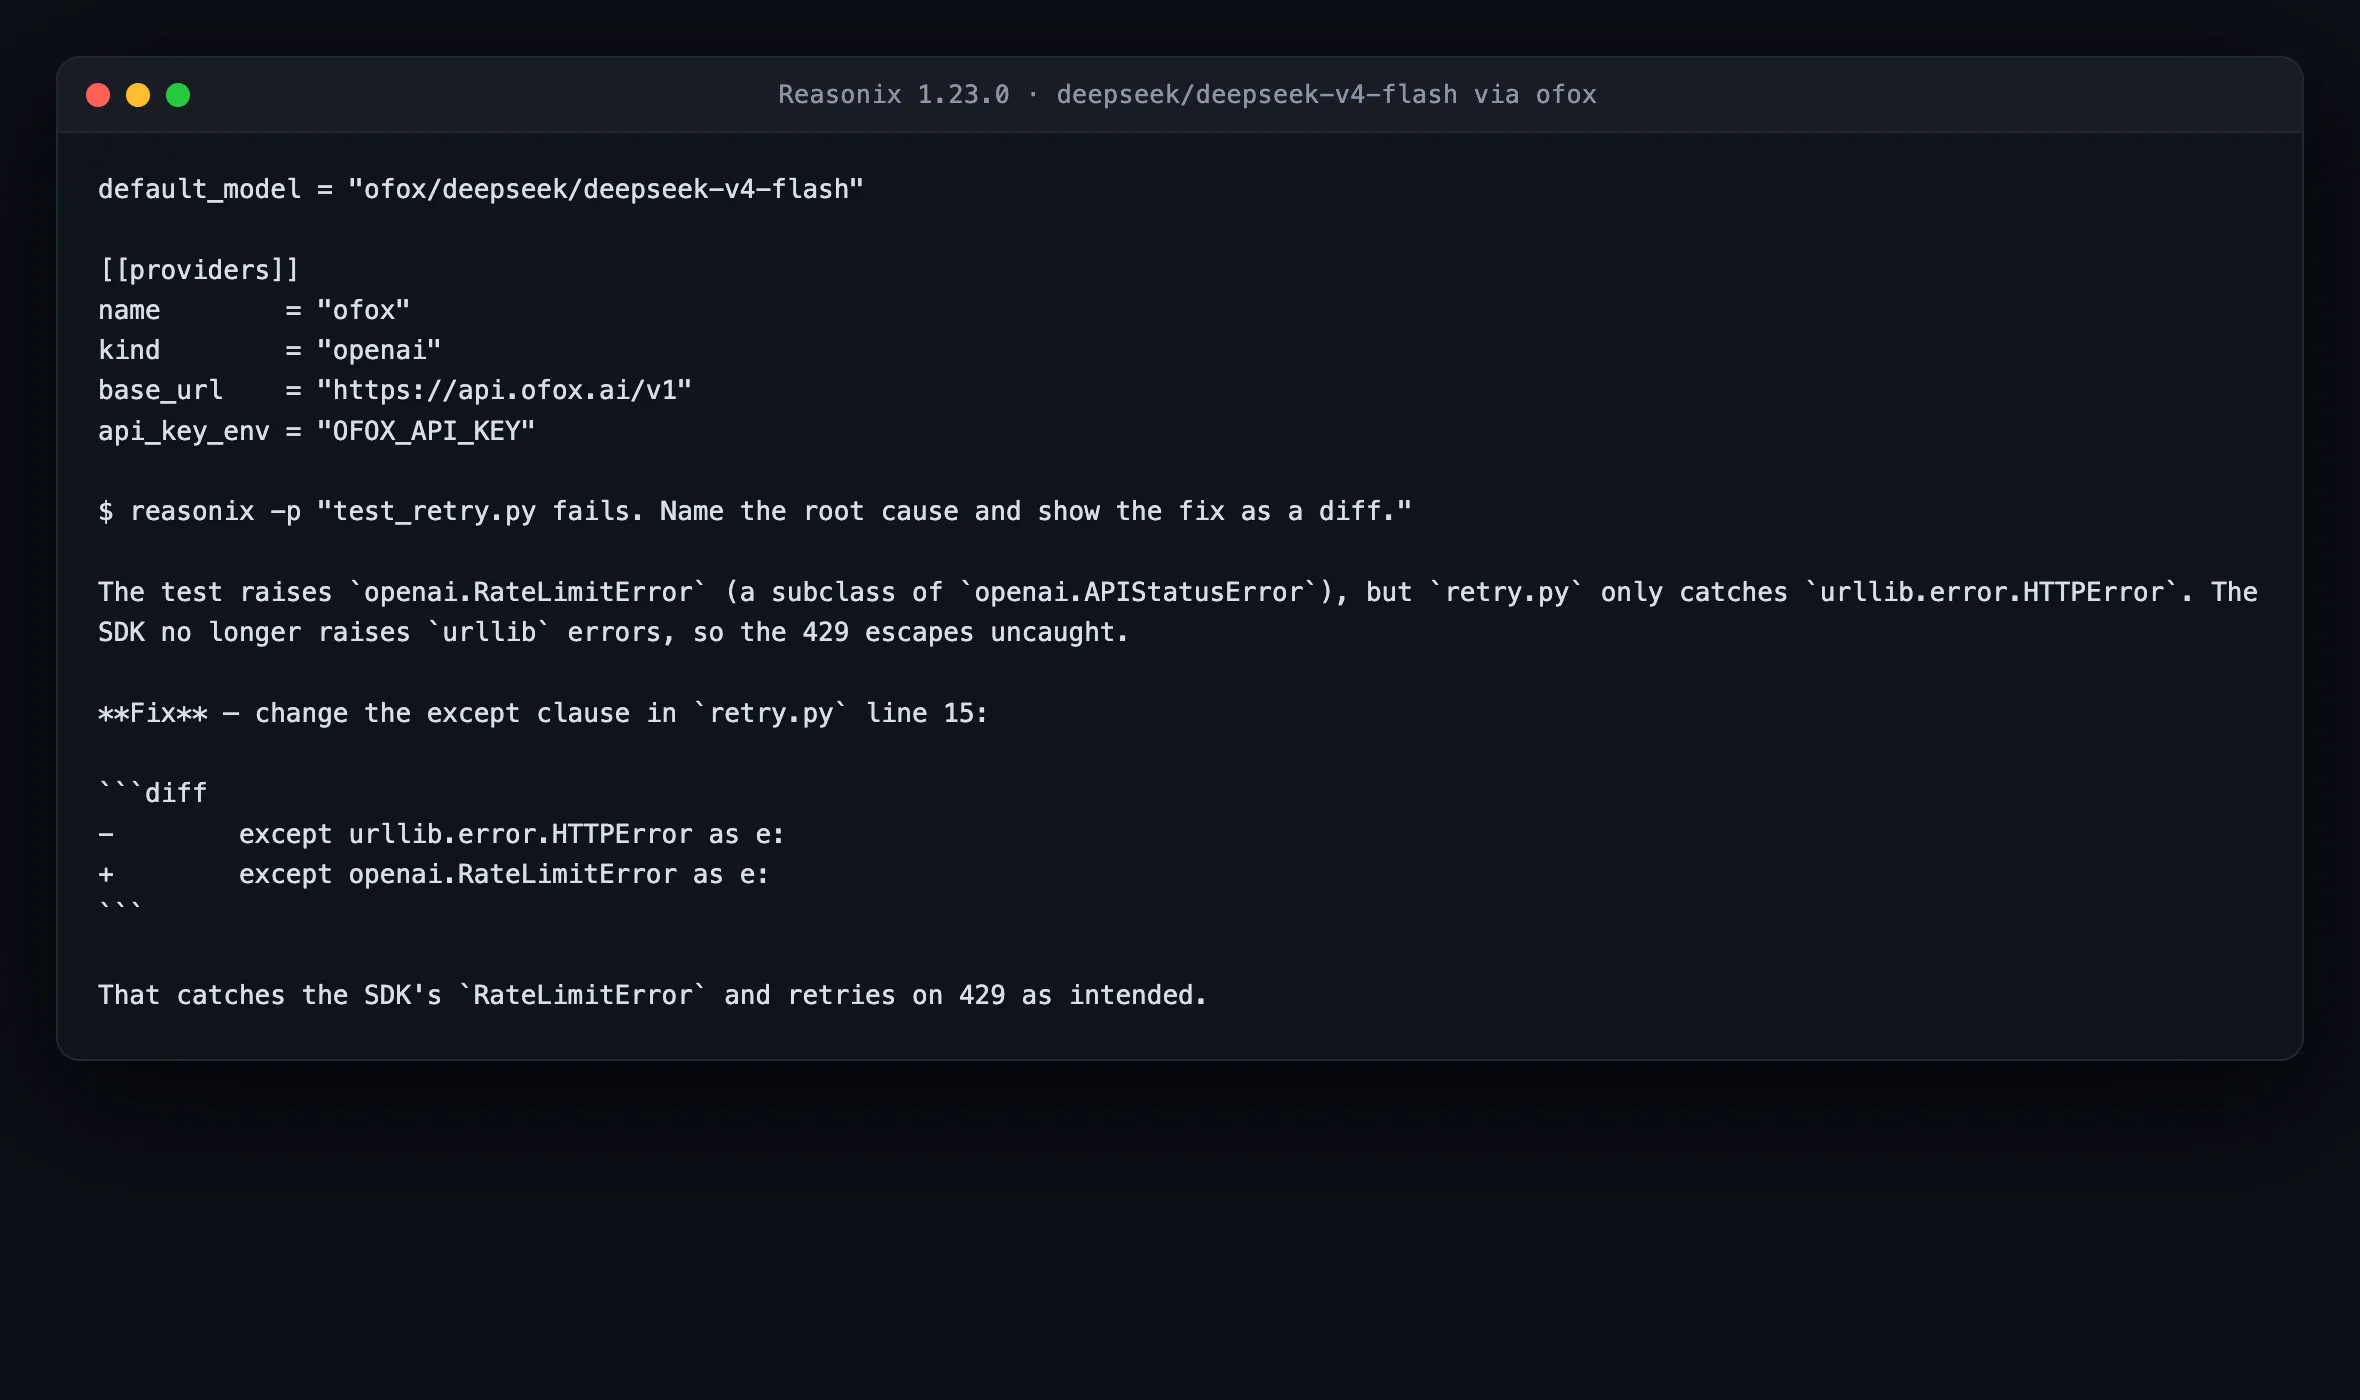
有意思的偏向在循环本身:它是照着 DeepSeek 的前缀缓存行为设计的,让长会话持续命中缓存而不是为上下文反复付费。如果你会让 agent 连着跑几个小时,这是真差异;如果你是短平快地用,那基本无关。另外,因为 DeepSeek 的缓存是按完整单元匹配而不是逐字节前缀匹配,省钱来得比大家预期的晚,所以要按你实际的工作形态来规划,不要照着宣传的缓存命中率算。
Pi:简洁核心、扩展与内置 MCP
跑在哪
终端,另外还有 print/JSON 输出、RPC 服务和可嵌入 SDK。npm i -g @earendil-works/pi-coding-agent 安装,0.84.1 版本 2026-08-07 落地。这个版本和 2.79T 的 OpenRouter 数字属于八月原始横评。Pi 仍采用 MIT 协议;新安装请参考当前安装说明。
花多少钱
免费开源。
靠什么扩展
10 月 20 日纠正: Pi 当前官网列出了扩展、skills、提示词模板、packages,以及内置 MCP 和 Codemode。旧文“不带 MCP”的说法已不正确。子 agent、权限弹窗和 plan 模式仍是各自独立的定制选择;默认配置简洁,不代表没有扩展和上下文管理能力。这是文档更新,不是对历史 Pi 0.84.1 截图所示配置的重新测试。
会被锁在哪
Pi 文档列出 15+ provider、通过 /model 会话中途切模型,以及通过 models.json 或扩展添加自定义 provider。能选提供商不代表省去协议和工具兼容性检查。下面保留的是原始 Pi 0.84.1 配置截图:
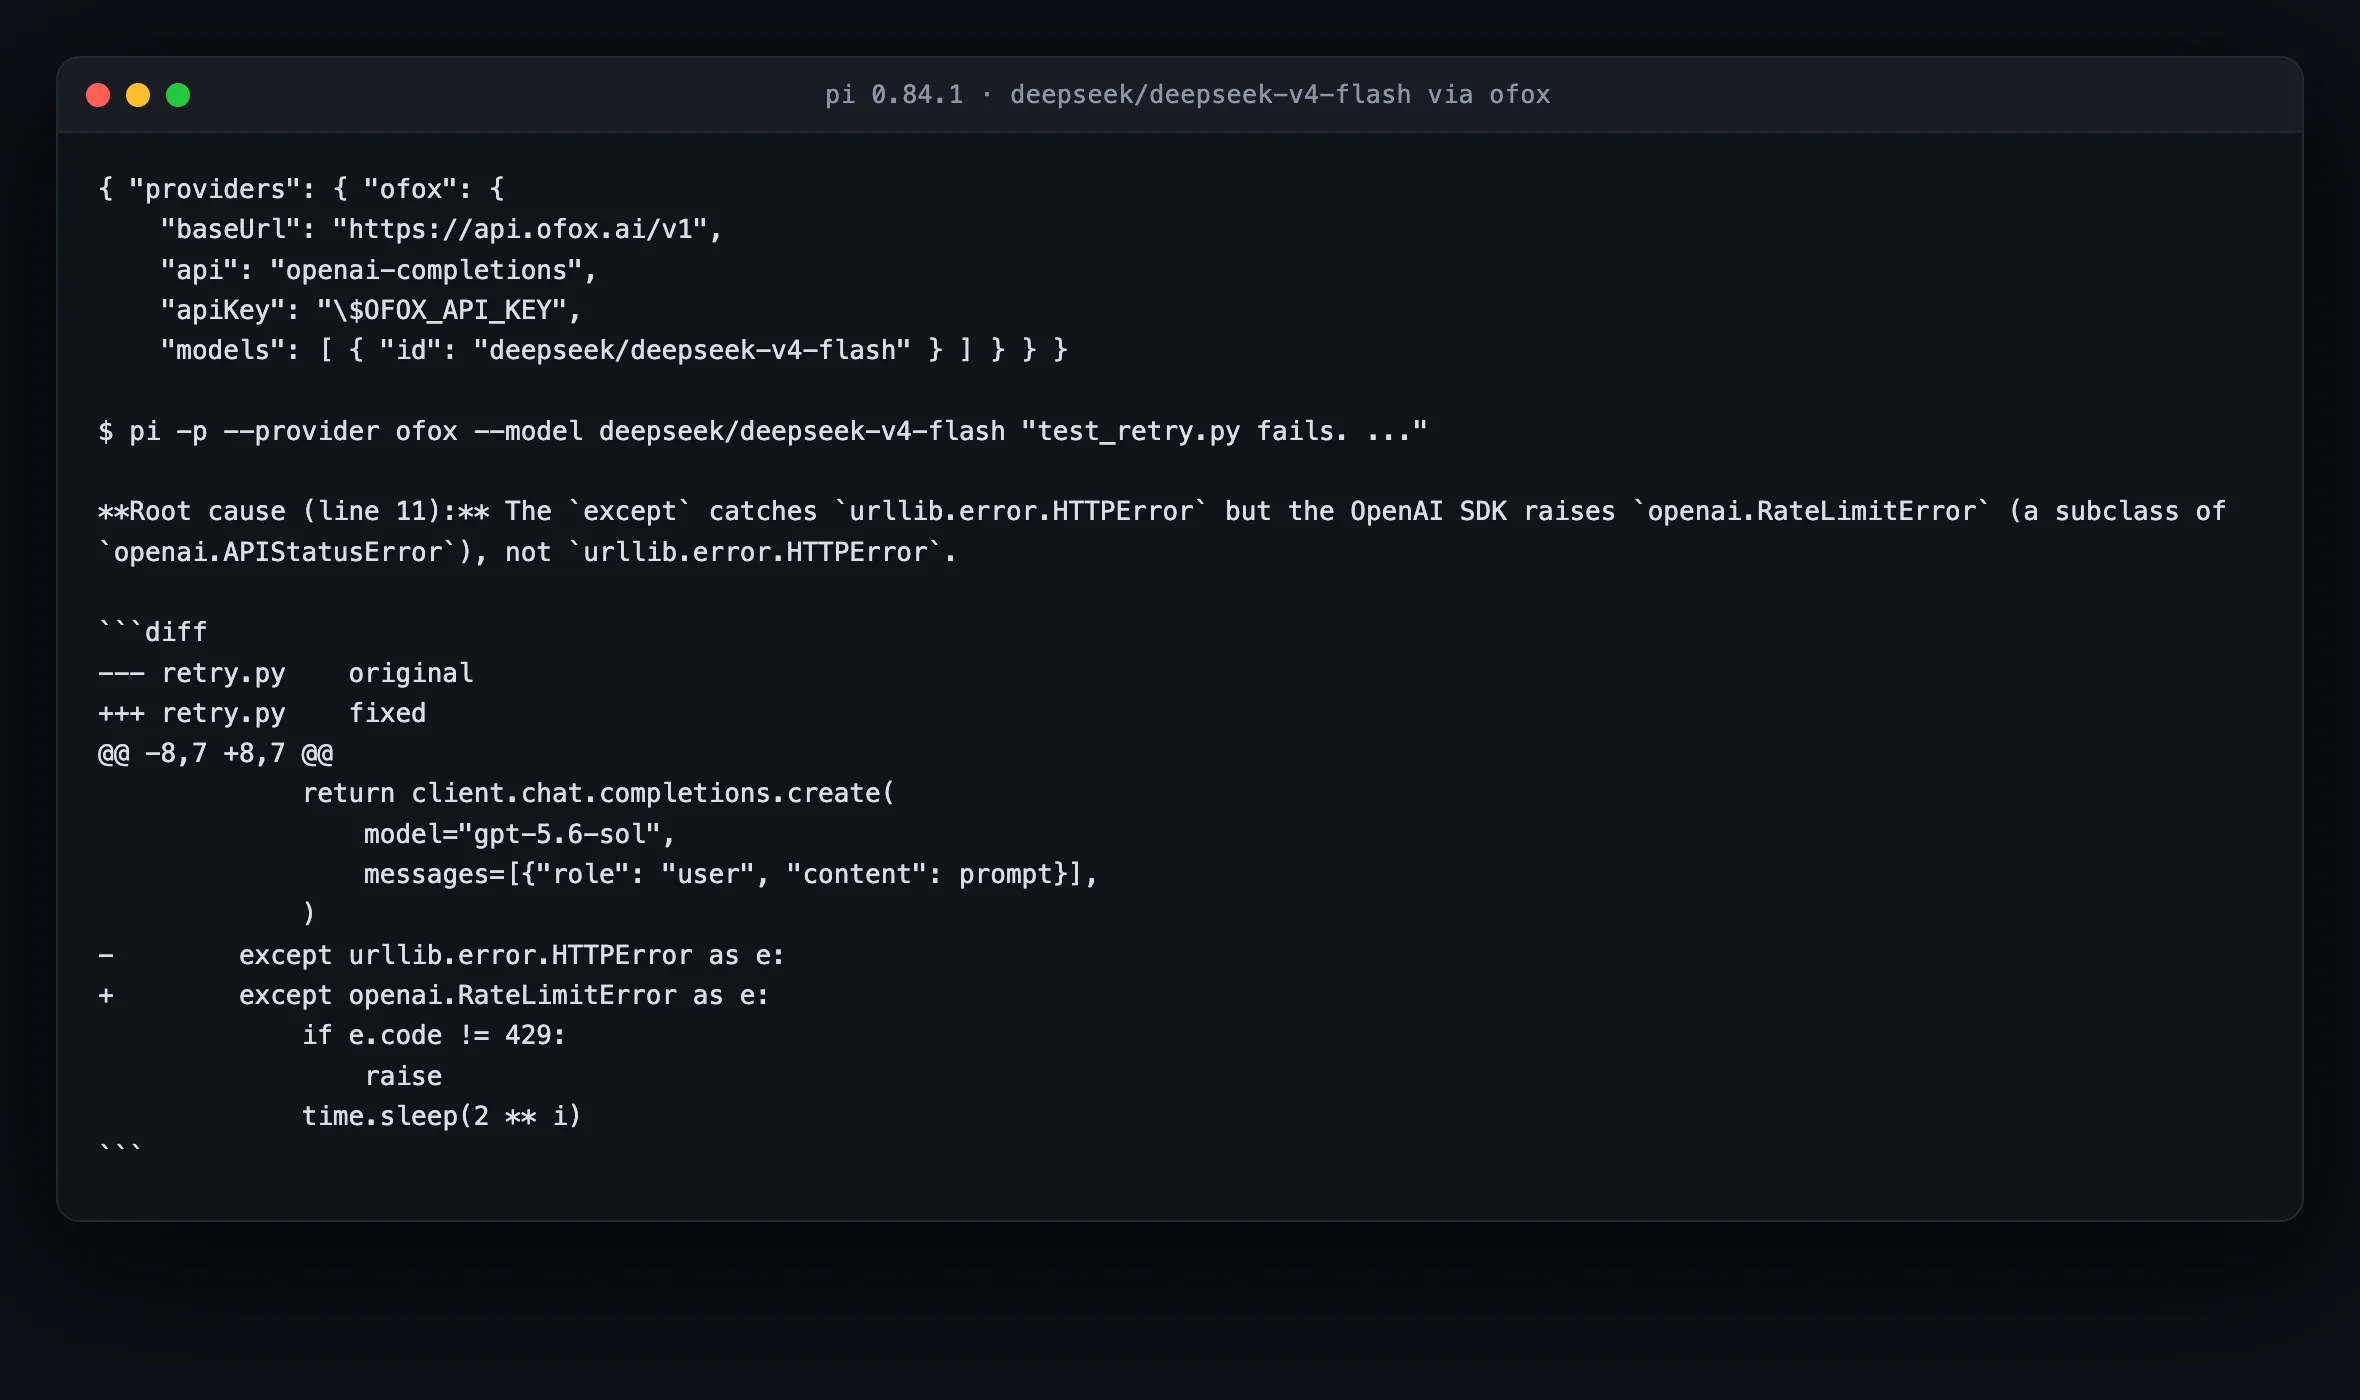 有一条得单独提醒,项目自己也写在明面上:Pi 没有内置的文件系统、进程、网络、凭据权限系统,沙箱要你自己做。要交给它敏感东西,就放容器里跑。社区的 token 用量反馈不是受控成本比较;得先测自己的任务和重试用量,再得出成本结论。
其他值得知道的 AI coding agent
这份补充列表中的排名属于八月原始快照。这些工具没有单独成节,要么覆盖面更窄,要么没能参加同一道上手测试。
| 工具 | 形态 | 值得注意的点 | ofox 文档 |
|---|---|---|---|
 Kilo Code | VS Code、JetBrains、CLI | OpenRouter 编程类第 3,排在 Cline 前面 | 无 |
 Roo Code | VS Code 扩展 | 一个工作区里多个专职 agent 角色 | 无 |
 Aider | 终端 | repo map,每次编辑前先发一份精简的代码库结构视图,减少改错文件 | 见其他 |
 Zed | 编辑器 | 原生编辑器,速度快,带 agent 面板;编程类榜单第 14 | 有 |
 OpenHands | 终端、云端 | 开源自主 agent,带浏览器和 API 访问 | 无 |
 goose | 终端 | Block 的开源 agent,扩展驱动 | 无 |
| Qwen Code | 终端 | 阿里的 CLI 工作流工具 | 无 |
 Crush | 终端 | Charm 出的 TUI agent,终端体验很好 | 无 |
 OpenClaw | 聊天驱动 | 从聊天软件里下命令;按量排编程类第 5 | 有 |
   Windsurf / Devin / Factory | IDE 与云端 | 商业自主 agent,订阅门槛 | 无 |
Antigravity 和 GitHub Copilot 是一回事吗
两者都属于编程助手,但要比较具体使用界面,不宜把一个品牌当成固定不变的客户端。原始 Antigravity 测试覆盖的是 CLI 1.1.12 及其登录要求。Copilot 横跨 IDE、CLI 和 GitHub 工作流;当前的本地 BYOK 选项也改变了“所有模型用量都从套餐额度扣除”的假设。
实际选型时,检查要使用的客户端如何访问仓库、在哪执行、能做哪些验证、如何审批和计费。本文没有在当前版本的 Antigravity 与 Copilot 上重跑同题任务,因此不能确定当前的性能或成本赢家。
哪些 harness 能远程或异步跑
终端原生的那些才是你能扔到服务器上的。Codex CLI、Claude Code、OpenCode、Reasonix、Pi 都能通过 SSH 无界面跑,Pi 走得最远,专门提供了 print/JSON、RPC 和 SDK 三种模式。原始对比覆盖的是 Cursor 编辑器,没有确定它当前所有远程或 CLI 产品的边界。Copilot 是另一个极端,云端 agent 接一个 issue 就还你一个 PR,全程不需要你的机器参与。Antigravity 2.0 能并行跑多个 agent,但那是本地窗口里的本地 agent。
这一列里的意外是 Cline。扩展确实要编辑器,但 CLI 不要:它会起一个本地 hub 守护进程和一个浏览器面板,能看到已连接的客户端和运行中的会话,所以 SSH 上去的机器也能用。
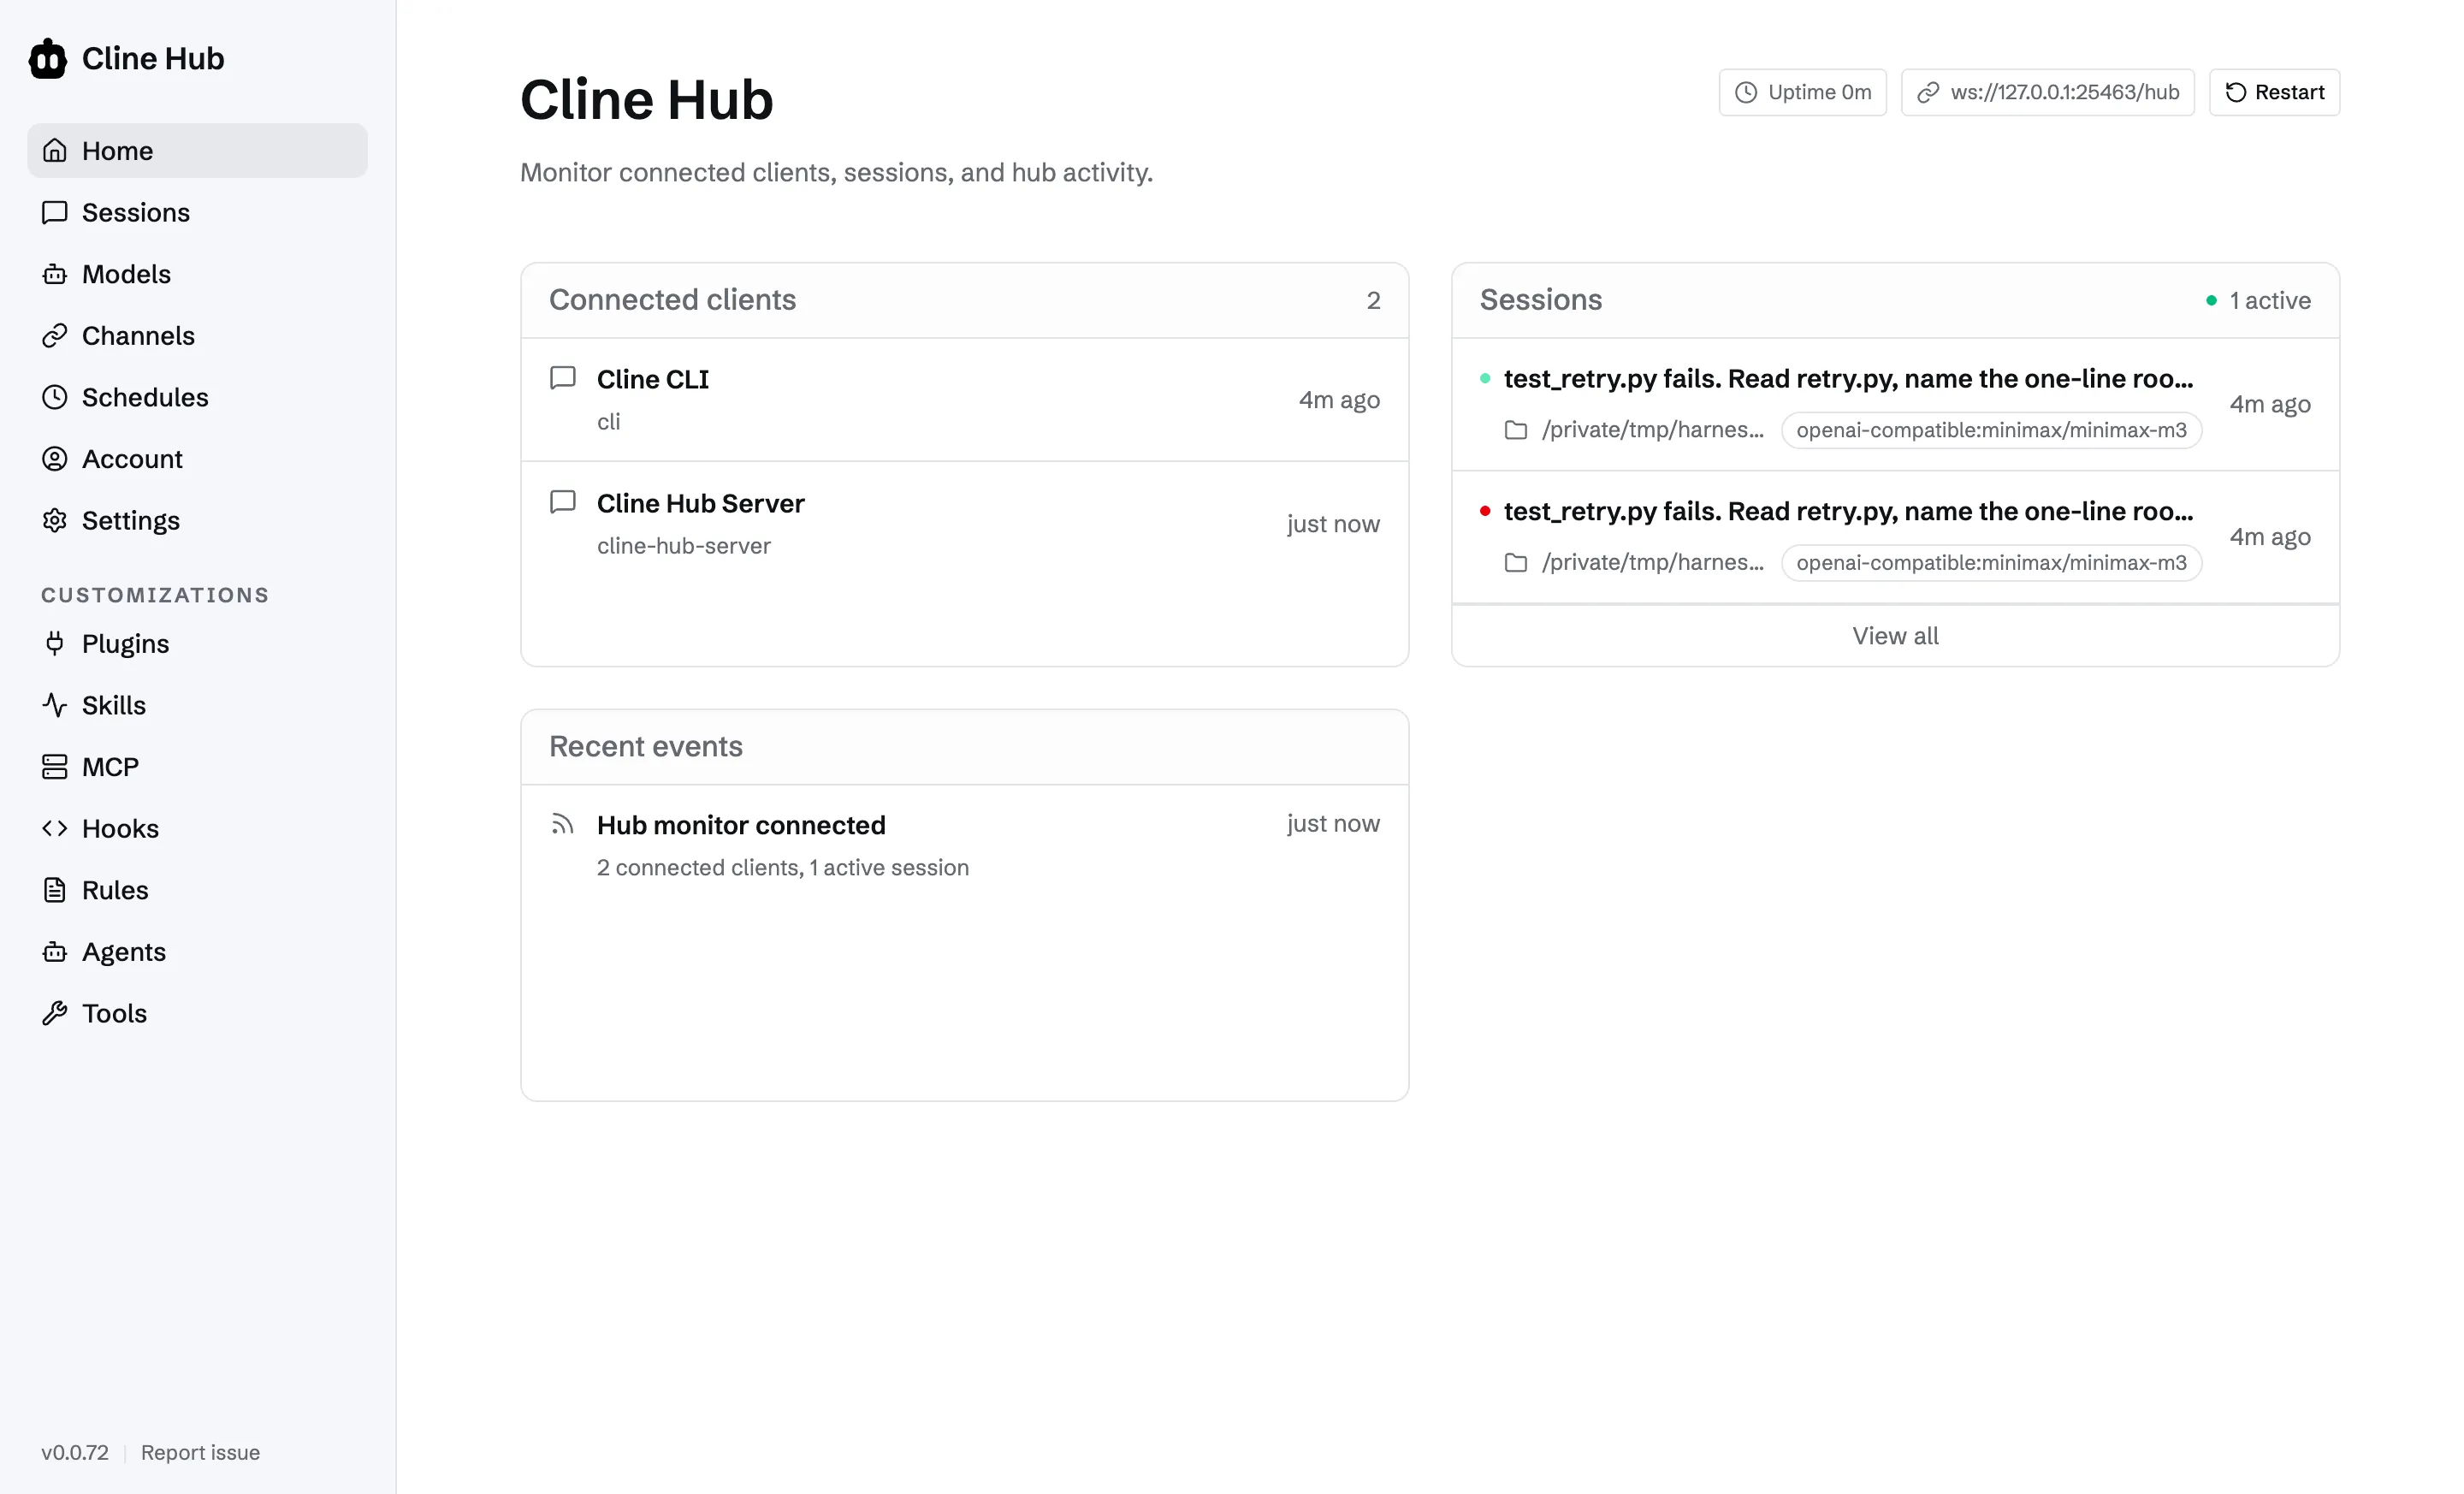
如果目标是无人值守的长任务,候选名单很短:一个终端 harness 加一个缓存稳定的模型,而这正是 Reasonix 被造出来要占的位置。
一个月的 agent 编程到底花多少钱
月度总额取决于完成并通过验收的工作,以及期间的失败尝试。未缓存输入、缓存读写、输出 token、重试、外部工具费用、席位或平台费用应分别记录。按提供商实际计费单位计算,不要把缓存 token 算两遍。
任务成本 = 所有尝试中已计费的模型用量 + 已计费的外部工具 + 可归属的平台费用。 重试已包含在这些用量合计中,不再作为单独费用重复相加。 做月度预算时,把固定订阅费与可变用量相加,不要再次加上套餐已包含的用量。费率和缓存条件取决于精确模型与路由;本次更新不引用 Ofox 当前报价,也不承诺节省费用。
比较时固定仓库版本和验收测试,记录模型 ID、harness 版本、路由、token 分类、耗时、失败尝试和最终测试结果。便宜但未通过验收的执行不能与完成的任务直接比较。要宣称某个 harness 更便宜,需要重复测量;OpenRouter 的 token 总量回答不了这个问题。
什么情况下该选哪一个
每个工具都有它赢的场景。依次是:
- Codex CLI:你活在 OpenAI 生态里,而且习惯自动放行 shell 命令。原始审查检查了它的操作系统级隔离原语,macOS 用 seatbelt,Linux 用 Landlock 加 seccomp。
- Claude Code:你想让 harness 承载团队流程。按团队所需流程评估它的 hooks、skills 和子 agent。
- Antigravity:它所支持的并行 agent 与可视化验证流程适合你的任务;另行核对当前套餐限制。
- GitHub Copilot:活儿发生在 PR 和评审里而不是编辑器会话里,而且团队里人人本来就有席位。
- Cursor:编辑速度对你最重要。评估它的 Tab 工作流,以及当前套餐能访问的模型。
- Cline:你想在 IDE 里要先规划后执行的纪律,后面配个便宜模型。
- OpenCode:模型自由是硬需求,而且你愿意花时间配置。
- Reasonix:会话动辄跑几个小时,缓存经济学主导你的账单。
- Pi:你对循环该怎么跑有明确主张,要的是地基而不是成品。
能同时用好几个吗
能。r/AI_Agents 那条帖子读下来,与其说是在找唯一赢家,不如说是在描述一个组合:编辑器负责快速改,IDE agent 负责本地上下文,终端 agent 负责带测试的多文件改动。有位评论者建议把这三条道明确分开,任何新工具都拿同样三道题试:修一个 bug、加一个小功能、做一次带测试的重构,然后留下那个「diff 最小最干净、需要人工纠偏最少」的。
这是针对具体任务的实用评测方法,不能替代所有基准测试。我们自己那篇 Claude Code、Codex、Gemini CLI 与 Cursor 四方对比和终端 agent 大乱斗走的都是这个路子:同一份活儿,一个工具一个工具地过。
大多数人不做这个测试,原因不是它难,而是跑三个 harness 意味着配三套凭据。
怎么让它们全指向同一个 key
这正是整篇对比底下那个实际的坎。这里每一个允许你选模型的工具,都要自己的凭据、自己的格式、自己的配置文件。Claude Code 要 ANTHROPIC_BASE_URL 和 ANTHROPIC_AUTH_TOKEN。Codex 要 TOML 里一个带 wire_api = "responses" 的 model_providers 块。Cline 要在扩展界面里填 provider 设置。OpenCode 要一条 provider 条目,Reasonix 要 reasonix.toml 里一段,Pi 要它自己的 provider 配置。即使使用同一个提供商账户,多个工具仍可能需要分别配置。
这个坎是真的,也不能怪任何单个工具。一个品类只统一到两种 wire 协议、别的什么都没统一,结果就是这样。
网关可以集中管理凭据和账单,但集成仍取决于协议和工具行为。Ofox 集成文档可以作为配置起点;请在实际客户端验证模型 ID、端点、工具调用和测试结果。共用 key 不代表功能支持相同,也不代表没有速率上限。
Copilot 本地 BYOK已不能准确描述为“只有个人席位的 Chat 能用”。Cursor 文档区分了受支持提供商的聊天 key 和内置 Tab 模型。两份文档都没有验证每条 Ofox 路由。原始 Antigravity 测试没有在所测 CLI 中找到纯 key 配置方式,但那不是对当前版本的新测试。
不要把凭据写进仓库或截图。接入生产仓库前,先用合成任务、有限预算和明确验收条件测试。
结论:先挑循环,再挑模型
按需要控制的工作选择 harness:IDE 交互、终端循环、自定义工具集成或远程任务。确认路由、权限和必要工具行为后再选模型。历史测试和 OpenRouter 当前用量列表都不能证明一个普遍适用的赢家。
API 接入可以从一个合成仓库任务开始,设定明确预算和真正可能失败的测试。记录精确 harness 版本、模型 ID、协议、预期 diff 和实际测试结果。凭据测试成功或补丁看起来合理,都不等于通过验收。编程之外的具体例子可看 n8n 自有 key 工作流,其中同时检查工具返回和最终输出。这里不承诺任何月度费用节省。
参考信息来源
- OpenRouter 编程类 agent 榜单
- OpenRouter app 页面:Claude Code
- OpenRouter app 页面:Codex
- OpenRouter app 页面:Cline
- OpenRouter app 页面:pi
- GitHub Copilot 套餐与定价
- Google Antigravity
- google-gemini/gemini-cli 仓库
- openai/codex 仓库
- cline/cline 仓库
- esengine/DeepSeek-Reasonix 仓库
- pi.dev
- DeepSeek API 文档
- r/AI_Agents:What AI harness for coding?
- ofox 集成文档
关于 9 月 10 日发布的托管服务,可以接着看 OpenAI Agents API 新闻解析:托管 Codex 底座与自己运行编程工具有什么区别,沙箱管理和计费又由谁负责。
常见问题
- 什么是 AI coding agent harness?
- harness 是包在模型外面、把它变成 agent 的那层程序。模型只负责生成 token,harness 决定哪些文件进上下文、模型能调哪些工具、执行 shell 命令要不要先问一句、测试跪了之后怎么办、会话被打断后还能不能接着跑。Claude Code、Codex CLI、Cline、OpenCode 都是 harness,GLM 5.2、GPT-5.6、DeepSeek V4 是模型。两样都得选,而且怎么配对比单看哪一个都重要。
- Claude Code 里能跑非 Anthropic 的模型吗?
- 兼容网关可以通过 ANTHROPIC_BASE_URL 和 ANTHROPIC_AUTH_TOKEN 提供接入,但仍须测试协议和工具兼容性。GLM 5.2 领先的是 8 月 11 日 OpenRouter 历史快照;10 月 20 日页面的月度列表由 Claude Opus 5.5 领先。这些数据不是整体市场份额。
- Reasonix 是 DeepSeek 官方出的吗?
- 不是。Reasonix 是社区项目,仓库在 github.com/esengine/DeepSeek-Reasonix,MIT 协议,npm 包名 reasonix,自己的站点是 reasonix.io。DeepSeek 官方文档里列的 agent 集成是 Claude Code、GitHub Copilot 和 OpenCode,没有 Reasonix。那个挂着 Reasonix 长文的 deepseek.ai 域名,页面上自己写了是独立站点、与 DeepSeek 无从属关系。
- Gemini CLI 是不是停服了、被 Antigravity CLI 取代了?
- 没有。截至 2026-08-11,google-gemini/gemini-cli 仓库没有归档、没挂弃用声明,preview、stable、nightly 三条发布通道都还在发。Antigravity 确实新增了自己的 CLI 界面,有些报道把这读成了替代,但 antigravity.google 和 Google Developers Blog 都没说 Gemini CLI 要下线。
- 哪个 harness 跑起来最便宜?
- 本文没有证明哪个 harness 最便宜。总成本取决于套餐、模型费率、输入与输出及缓存用量、重试和外部工具。token 热度不是成本测量,应比较同一个通过验收的任务,并计入产生费用的失败尝试。
- 每个 coding agent 都得单独配一个 API key 吗?
- 部分客户端可以共用提供商凭据,但同一个 key 不代表协议和工具都支持。Copilot 已在多个客户端提供本地 BYOK 文档,另有独立的企业机制。Cursor 支持指定提供商的聊天模型密钥,Tab 仍用内置模型。复用密钥前须核对具体客户端和提供商。
- 扩展能力最强的是哪个?
- 应按任务选择扩展能力。Claude Code 提供 hooks、子 agent、skills 和 MCP;Pi 当前文档包含扩展、skills、packages、内置 MCP 和 Codemode,旧文“不带 MCP”的说法已过时。内置能力、扩展、权限和沙箱责任应分别检查。