Gemini 3.8 Flash 如何迁移到 Hydrogen?保留上下文与工具调用
将 Gemini 3.8 Flash 迁移到 Hydrogen:明确思考配置、恢复缓存内容、保留工具历史,并建立回归检查与回滚步骤。
 Ofox
从 Gemini 3.8 Flash 迁移到 Gemini 4 Hydrogen,应先保留原来的 API 协议和应用上下文,再修改模型 ID、显式选择思考级别,并重新执行任务验收,最后才把生产任务切过去。 只替换模型名称,既不能恢复不再受支持的缓存引用背后的文档,也不能证明已有的服务端会话可以跨模型续接。
本文针对已经正常工作的应用,不重复讲第一次获取 Key。如果还没有跑通请求,请先看 Hydrogen API 接入教程。下面会建立一个迁移前后的完整请求,检查历史是否保留,并给出真实迁移需要的验收与回滚方法。“保留上下文”指需要执行的检查和恢复步骤,不保证两个模型给出完全相同的答案。
文档核验日期为 2026 年 11 月 14 日。下载工具包通过了 21 项离线请求审计测试,另用模拟 HTTP 传输检查了实际 google-genai==3.3.0 SDK 的请求序列化。我们没有调用两个模型,没有验证真实跨模型会话,也没有测量效果或比较账单。下文的回归标准是供应用执行的检查方案,不是已经测得的基准结果。
本文链接的 Google 官方文档及工具包 README 为英文。
分清真正发生变化的配置
请同时阅读 Hydrogen 迁移说明和 Gemini 3.8 发布文档。新版清单重新强调的限制,不一定是新引入的不兼容变化。
| 项目 | Gemini 3.8 Flash 原有行为 | 迁移到 Hydrogen 时的处理 |
|---|---|---|
| Google 模型 ID | gemini-3.8-flash | 改为 gemini-4-hydrogen,并单独确认目标账号有访问权限 |
| 默认思考级别 | medium | 默认变为 high;受控比较时显式设置级别 |
| 可选思考级别 | low、medium、high | 新增 xhigh;3.8 本来就不支持 minimal |
| 上下文预算 | 输入与输出上限分开 | 输入、思考和输出共用 1,048,576 token 窗口 |
| 显式上下文缓存 | 先检查原请求是否依赖缓存资源 | Hydrogen 不支持显式缓存;删除引用前必须恢复内容 |
| 采样参数 | 3.8 迁移说明已经将其列为弃用 | Hydrogen 忽略范围内的自定义值,越界值仍可能返回 400 校验错误 |
| 长输出 | 原应用可能假定一次响应即可完成 | 超过单次同步响应(每个 hop)的 65,536 token 上限时,需要后台执行或客户端续接设计 |
把 Hydrogen 设为 medium,只是控制一个配置变量,不代表内部思考量、延迟或回答质量相同。更大的输出上限,也不代表接近占满窗口的输入还能留下同样多的输出空间。应在共享窗口中同时计入思考与答案,并保留应用自己的输出和费用上限。
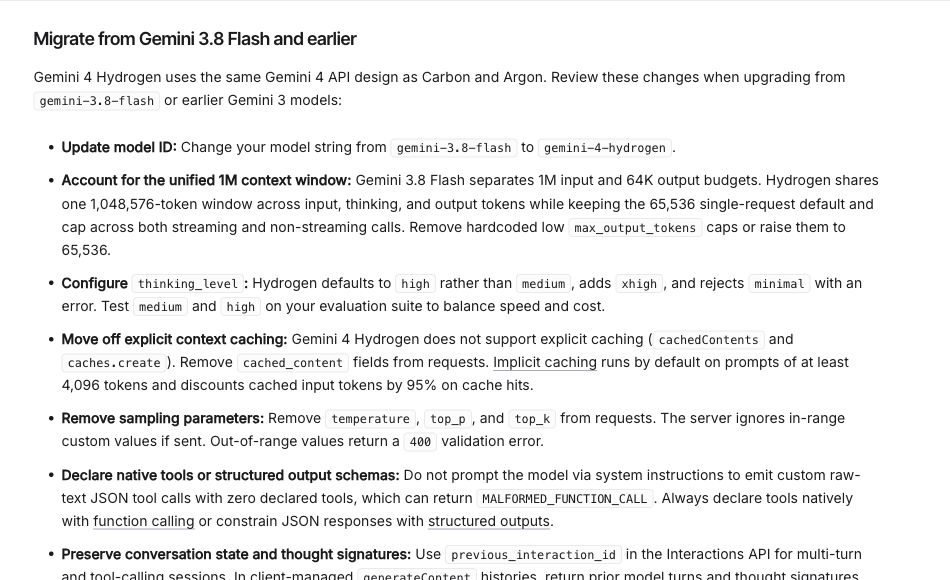
Google 英文迁移文档的真实截图,用于记录来源说明,不代表 API 已成功迁移,也不是 Ofox 性能测试。
具体输出机制见 Google 的长输出文档。单次响应的上限属于控制流程需要处理的边界,不能据此认定所有更大的输出参数都天然无效。
固定原配置,保持同一种协议
修改模型前,保存带版本的原配置和一组可重复的小任务。记录模型、端点、SDK 版本、系统指令、输入组装方式、工具、响应 schema、输出上限、存储设置、重试策略及供应商路由字段。原始文档和允许留存的用户输入应保存在日常受保护的存储中,不要把公开调试日志当作迁移档案。
需要区分三种请求结构:
| 现有调用方 | 必须保持的协议边界 | 不应直接混入的内容 |
|---|---|---|
| Google Interactions | input、generation_config、交互步骤和 ID | GenerateContent 的 contents 请求结构 |
| Google GenerateContent | contents、内容 part、工具声明和 SDK 配置 | 用 Interactions 的 previous_interaction_id 替代本协议历史 |
| Ofox OpenAI 兼容调用 | 文档规定的 messages、模型路由和响应协议 | 原封不动的 Google 原生 Interactions 请求 |
下一节的完整样例使用 Google Interactions。工具包另一个序列化测试使用 GenerateContent,因为它检查模型 part 和工具响应是否保留。这是两项独立检查,执行其中一项不会自动转换另一种协议。
Ofox 应用应先核对正在使用的具体路径:Gemini Generate Content 或 OpenAI 兼容 Chat Completions,并按对应的 Ofox Key 与鉴权说明配置。Google Key 与 Ofox Key 不能混用。Ofox 文档提供 Gemini 原生路径,并不等于已经支持全部 Google Interactions 功能或每个模型的缓存能力。
工具客户端迁移与应用迁移也应分开。如果请求由 Cline 或 OpenCode 组装,请按照 Hydrogen 编程工具配置教程操作,并检查客户端实际发送的内容,不能假定它会发送本文的 JSON。
建立清楚、可比较的迁移前后请求
先选择无需另一个模型就能判断答案的任务。源样例包含两条记录的状态,只有 B 被阻塞。将下面的完整对象保存为 source-request.json:
{
  "model": "gemini-3.8-flash",
  "input": "Records: A=ready; B=blocked. Return the blocked record IDs only.",
  "generation_config": {
    "max_output_tokens": 8192
  },
  "response_format": {
    "type": "text",
    "mime_type": "application/json",
    "schema": {
      "type": "object",
      "properties": {
        "blocked_ids": {"type": "array", "items": {"type": "string"}}
      },
      "required": ["blocked_ids"],
      "additionalProperties": false
    }
  }
}
创建 hydrogen-request.json,保留输入、schema 和输出上限,只修改模型并显式指定思考级别:
import json
from pathlib import Path

source = json.loads(Path("source-request.json").read_text())
target = json.loads(json.dumps(source))
target["model"] = "gemini-4-hydrogen"
target["generation_config"]["thinking_level"] = "medium"
Path("hydrogen-request.json").write_text(json.dumps(target, indent=2))
工具包内已经包含两份完整 JSON。8,192 token 上限只是这项受控样例的设置,不是生产环境通用推荐。即使最终 JSON 很短,思考也可能耗尽可用预算。应检查完成状态和截断,不要为了掩盖失败就自动把生产上限调到最大。
响应格式遵循 Google 当前的结构化输出协议:文本输出、application/json MIME 类型和 schema。Schema 约束数据形状,并不能证明模型选对了记录。
通过自己的密钥管理方式,将 Google 项目 Key 配置到 GEMINI_API_KEY 后,可以选择执行下面的真实请求。命令会连接 Google,可能消耗项目额度或产生费用;本文没有执行这项调用。
curl --fail-with-body --max-time 180 \
  'https://generativelanguage.googleapis.com/v1beta/interactions' \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  --data-binary @hydrogen-request.json \
  --output hydrogen-response.json
再将请求文件换成 source-request.json、响应保存到另一文件,取得原模型基线。保持账号、输入、schema 与执行条件可比。先检查交互状态,以及错误或未完成结果。只有完成且包含预期输出的响应,才应进入应用解析器。解析 JSON 文本后,这项样例应要求结果恰好为 {"blocked_ids":["B"]},不能多出键或记录 ID。HTTP 200、有效 JSON、任务答案正确,是三项不同的检查。
客户端超时时,保留已经取得的请求或交互标识,先查看服务端状态再决定重试。客户端超时本身不能证明服务端已经停止执行。
执行离线迁移工具,理解它能验证什么
下载 Hydrogen 迁移工具包,解压后进入 hydrogen-migration-kit 目录。使用整套工具应采用 Python 3.11 或更新版本;请求审计器仅依赖标准库:
python -m unittest test_audit.py -v
python migration_audit.py source-request.json
python migration_audit.py hydrogen-request.json
单元测试的预期结果为 21 项通过。审计器不会改写请求文件,而是输出未修改的副本及阻断项、复核项。退出码 2 表示发现阻断项;退出码 0 仅表示本工具检查范围内未发现阻断,并不表示可以发布。例如目标样例仍需要应用评测,也需要复核刻意设置的输出上限。
审计器面向完整的 Interactions 初始请求,检查错误的协议结构、缺失输入、显式缓存依赖、不合法的思考级别、异常输出上限,以及不兼容的存储与后台设置。它也会指出默认值掩盖的变化。但它不能恢复缓存文档、查看服务端历史、确认账号权限,或验证服务端接受的全部字段。
输出包含完整请求副本。先用工具包中不含敏感信息的样例,不要将机密提示词写入共享终端日志。API Key 不应出现在请求 JSON 中。
独立的 SDK 序列化检查需要隔离环境:
python -m venv .venv
source .venv/bin/activate
python -m pip install 'google-genai==3.3.0' httpx
python sdk_wire_check.py
Windows PowerShell 使用 .venv\Scripts\Activate.ps1 激活。安装依赖会访问包仓库;检查脚本本身使用明确标注的虚构 Key 和 httpx.MockTransport,不读取环境凭据,也不发送模型请求。
脚本通过已安装的 SDK 序列化两份 GenerateContent 请求,断言两者保留相同的三轮历史、工具声明和两个工具响应。模型轮包含两个并行函数调用;合成签名留在最初的第一个 part 上,不复制到第二个。目标请求指定 Hydrogen 和 MEDIUM 思考级别。可查看脚本旁边的 sdk-wire-requests.json 核对捕获的请求体。
这只能证明本地序列化行为。合成响应和签名不能证明服务端接受请求、允许跨模型续接或工具执行器正常工作。离线检查能在真实评测前发现意外丢失历史的问题,但不能替代真实评测。
恢复缓存内容,保留会话状态
显式缓存 ID 是引用,不是文档本身。直接删除 cached_content 或 cachedContent,可能让请求看起来更简洁,却悄悄丢掉应用依赖的材料。Google 的缓存文档区分隐式复用和显式管理的缓存资源;隐式缓存不会替你恢复没有发送的输入。
对每种依赖缓存的任务,执行以下恢复步骤:
- 找到调用方创建缓存时使用的原始系统指令、文档、媒体引用和工具声明。找不到就暂停该任务的迁移,不能把空内容当成等价替换。
- 记录内容版本和顺序,并确认外部文件引用对目标账号和请求路径仍然可访问。
- 使用当前协议对应的字段重建完整请求,保留系统与用户角色的区别及工具。不能为了删除缓存 ID,就把全部内容压成一个用户消息。
- 按 Hydrogen 共享窗口重新计算恢复后的上下文,为思考和答案留出空间;必要时拆分任务。
- 提出一个必须依赖恢复材料中已知事实才能回答的问题。先核对精确答案,再停止使用旧的缓存依赖路径。
会话状态需要另行处理。在 Interactions 中,可以用 previous_interaction_id 引用已存储的上一次交互。当前请求设置 store=false,本身不妨碍读取先前已存储的状态,但当前结果不会被存储,不能用于后续续接。后台执行与 store=false 不兼容。不能仅因存在旧 ID 就推断支持跨模型续接;应测试具体账号与模型组合,或为小范围试运行启动明确重建上下文的新会话。
无状态续接需要保留协议要求的完整顺序,包括思考相关步骤和内置工具签名。GenerateContent 则应按顺序保留完整模型内容及其 part,再附上相应工具响应。界面显示的文字聊天记录不足以作为完整历史存储。
出现缺失思考签名的错误时,可参照 Gemini 工具调用签名排查和官方签名规则。签名应留在原来的 part 上,不能复制给多个并行函数调用,也不能自行编造替代值。工具包的合成签名只用于离线发现序列化错误。
同时检查工具、输出和共享预算
迁移后的请求即使保留了所有文本,也可能丢失应用行为。应保持函数名、参数 schema、权限、调用与结果的对应关系,以及结果顺序一致。Google 的函数调用文档规定协议,而执行器仍需自行判断哪些操作被允许、每项操作是否真正成功。
先验证只读工具,再接入会写入数据的工具。例如让 lookup_record 返回 A 为 ready、B 为 blocked,再要求最终结构化答案识别 B。记录调用 ID、参数值和工具结果,但不记录密钥。模型发出两个调用时,应返回各自对应的两个结果,不能合成一段失去对应关系的自由文本摘要。
把模型输出当成需要应用验证的数据。记录样例先验证 schema,再根据已知记录检查答案;写入任务还要查看真实目标状态。模型文字说“保存成功”,并不证明写入发生。如果执行对象是界面而非函数工具,Computer Use 配置教程说明了额外需要的观察、批准、执行和验收循环。
预算不足容易被误认为任务能力不足。记录输入用量、输出用量、可获得的思考用量、完成状态和截断标志。缺失用量应记为未知,不能当成零。如果供应商的输出总量已含思考,不要再加一遍思考 token。计算费用前,先核对供应商定义的计量单位。
长答案应明确选择续接控制流程或后台路径,并设置停止条件。保留恢复标识,避免重放已经执行的副作用,并限制整个任务跨多次续接的总工作量。只增大单次参数,而不调整控制流程,无法得到可靠的长任务。
建立有独立验收标准的回归集
从真实应用案例中挑选任务,去除秘密信息并确保使用权限。既要覆盖正常成功,也要覆盖已知失败边界。下面是一组可复现的小型测试设计,不含已测得的模型结果。
| 案例 | 具体样例 | 通过条件 |
|---|---|---|
| 基础提取 | A=ready; B=blocked | 响应完成,解析后只包含被阻塞的 B |
| 缓存恢复 | 原文档写有 release_owner=team_amber,问题本身不含该事实 | 恢复完整文档后,正确返回 team_amber |
| 历史连续性 | 第一轮将 A 分配给 team_amber,下一轮询问负责人 | 通过应用选定的状态机制返回正确团队 |
| 并行工具 | 两个 lookup_record 分别查询 A、B | 两个结果对应关系正确,没有重复执行,最终答案符合样例 |
| 受控截断 | 给较大任务设置刻意不足的输出上限 | 应用识别未完成输出,不将其验收为成功 |
| 无效配置 | 越界采样值或不兼容的后台/存储组合 | 错误进入正确处理分支,而非无条件重试 |
| 带写入的回滚 | 测试操作已有操作 ID,但客户端响应不确定 | 重放前由操作人员或执行器检查目标状态 |
每次记录配置版本、模型 ID、提示词或样例 hash、SDK 版本、账号或路由环境、起止时间、完成状态、校验结果和可获得的用量。敏感原始响应只能按正常保留政策存储。应比较同条件任务;如果提示词、schema、执行器一起变了,就不能把改善全归因于模型。
在消耗费用或额度的评测之前先确定验收线。Schema 合法性和副作用安全可以采用严格要求;任务准确性、延迟与成本需要适合应用的阈值及有意义的样本。本文不提供万能百分比,也不把七个样例说成生产可靠性证明。逐个分析差异,尤其注意那些看似合理、却未通过确定性检查的答案。
逐步放量,并保留可用的回滚路径
先把数量受限的新建只读任务交给 Hydrogen。保留可独立选择的原配置和目标配置,使用同一版本、已认可的样例。在扩大范围前,检查失败和未完成响应。会写入数据的任务,则必须先通过执行器、去重与目标状态检查。
请求格式错误时应修改请求,不要原样重试。没有模型权限时,核对准确账号、路由和模型 ID。瞬时故障采用带退避的有限重试,保留标识。Ofox 调用方按错误处理与重试文档执行。已有的 Gemini 4 API 报错排查文章也能帮助区分权限、请求格式与限流问题,但其中的模型示例是 Argon,不能直接当作 Hydrogen ID 复制。
回滚是为符合条件的新任务恢复原配置,不是盲目重放所有执行中的交互。先暂停新的副作用,找出状态不确定的操作,查看目标实际状态,再决定续接、补偿或重新开始。旧路径只有在模型和账号权限仍有效时才能使用;保存了配置,也不能绕过供应商退役或权限失效。
只有应用在真实路径上证明上下文恢复、工具状态保留、输出验证、执行边界和回滚演练都满足要求,才算具备迁移条件。保留版本化证据,便于日后分清问题来自本次模型迁移,还是后续提示词、SDK 或供应商变动。