Gemini 3.8 FlashからHydrogenへ移行する方法:コンテキストとツール履歴を保つ
Gemini 3.8 FlashからHydrogenへ移行する際の思考設定、キャッシュ内容の復元、ツール履歴の保持、回帰テストとロールバックを解説します。
 Ofox
Gemini 3.8 FlashからGemini 4 Hydrogenへ移行するには、APIの仕様とアプリケーションのコンテキストを保ち、モデルIDを変更し、思考レベルを明示したうえで、タスク単位の検証をやり直してから本番処理を切り替えます。 モデル名の置き換えだけでは、非対応になったキャッシュ参照先の文書を復元できません。既存のサーバー保存会話を別モデルで継続できることの証明にもなりません。
この記事は、すでに動いているアプリケーションの移行を扱います。最初のキー取得とリクエストはHydrogen APIの設定ガイドを参照してください。ここでは移行前後の小さなリクエストを作り、履歴の保持を確認し、実際の移行に必要な合格条件とロールバックを定めます。コンテキストを保つとは、必要な点検と復元を行うことです。両モデルの回答が同一になるという保証ではありません。
文書の確認日は2026年11月14日です。配布キットでは21件のオフラインリクエスト監査テストと、モックHTTPトランスポートを使った実際の google-genai==3.3.0 のシリアライズ検証を実施しました。モデル呼び出し、実会話のモデル間継続、品質測定、請求額比較は行っていません。後述の回帰基準はアプリケーションで実施する検証案であり、測定済みベンチマークではありません。
リンク先のGoogle公式ドキュメントとキットのREADMEは英語です。
実際に変わる設定を見分ける
Hydrogenの移行説明とGemini 3.8のリリース文書を併せて確認してください。新しいチェックリストに再掲された制約を、新しい破壊的変更と誤認しないためです。
| 項目 | Gemini 3.8 Flashの従来の動作 | Hydrogenでの判断 |
|---|---|---|
| GoogleのモデルID | gemini-3.8-flash | gemini-4-hydrogen に変更し、対象アカウントのアクセスを別途確認 |
| 既定の思考レベル | medium | high に変わるため、条件をそろえる比較では明示する |
| 思考レベルの選択肢 | low、medium、high | xhigh を追加。minimal は3.8でも非対応 |
| コンテキスト予算 | 入力と出力の上限が別 | 入力・思考・出力で1,048,576トークンのウィンドウを共有 |
| 明示的コンテキストキャッシュ | 既存リクエストのキャッシュ依存を確認 | Hydrogenは明示的キャッシュに非対応。参照削除前に内容を復元 |
| サンプリング設定 | 3.8の移行説明ですでに非推奨 | 範囲内の独自値は無視されるが、範囲外は400検証エラーになり得る |
| 長い出力 | アプリが単一応答を前提にしている可能性 | 同期実行の1ホップ当たり65,536トークンを超える場合は、バックグラウンド実行かクライアント継続を設計 |
Hydrogenを medium にするのは、設定変数を一つそろえる操作です。内部の思考量、遅延、回答品質が同じになるとは限りません。最大出力が大きくても、入力がほぼ満杯なら同じ量の出力余地が残るわけではありません。思考と回答を含む共有予算を計算し、アプリ側の出力・支出上限も維持します。
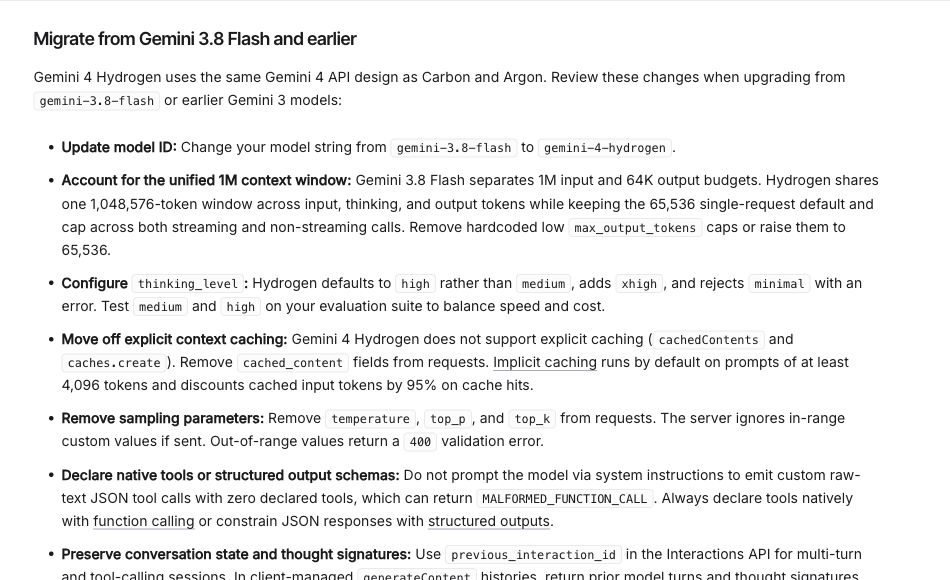
Googleの英語移行文書を撮影した実際の画面です。出典の説明を記録したもので、API移行の成功やOfoxの性能測定を示すものではありません。
出力の仕組みはGoogleの長い出力に関する文書を参照してください。1ホップの上限は制御処理の設計上の境界であり、それより大きな出力上限の指定がすべて無効になる根拠ではありません。
元の設定を保存し、同じプロトコルを使う
モデルを変える前に、元の設定をバージョン付きで保存し、再現可能な少数のタスクを用意します。モデル、エンドポイント、SDKバージョン、システム指示、入力の組み立て、ツール、応答スキーマ、出力上限、保存設定、再試行方針、プロバイダーのルーティング項目を記録してください。元文書と保存が認められたユーザー入力は通常の保護された保存先に置きます。公開デバッグログを移行記録の保管場所にしないでください。
次の三つのリクエスト形式を区別します。
| 既存の呼び出し元 | 維持する境界 | 混ぜてはいけないもの |
|---|---|---|
| Google Interactions | input、generation_config、インタラクションのステップとID | GenerateContentの contents エンベロープ |
| Google GenerateContent | contents、コンテンツpart、ツール宣言、SDK設定 | 履歴の代わりにInteractionsの previous_interaction_id を使うこと |
| OfoxのOpenAI互換呼び出し | 文書化されたmessages、モデルルーティング、応答形式 | GoogleネイティブのInteractionsリクエストの貼り付け |
次節の完全なサンプルは Google Interactions を使います。一方、キットのシリアライズ検証はモデルpartとツール応答を調べるため GenerateContent を使います。別々の検証であり、一方の実行がもう一方のプロトコルを変換するわけではありません。
Ofoxアプリでは、現在使っているGemini Generate ContentかOpenAI互換Chat Completionsの経路を確認し、それに対応するOfoxキーと認証の手順に従います。GoogleキーとOfoxキーは交換できません。Geminiネイティブ経路が文書化されていても、Google Interactionsの全機能やモデル固有のキャッシュ対応が確認できたことにはなりません。
ツールクライアントの移行も別に扱います。ClineやOpenCodeがリクエストを作る場合は、Hydrogenのコーディングツール設定を参照し、実際の送信内容を確認してください。この記事のJSONがそのまま送られるとは限りません。
小さく明示的な移行前後のリクエストを作る
別のモデルに採点させなくても正解を判定できるタスクを選びます。元のサンプルには2件のレコード状態があり、blockedなのはBだけです。次の完全なオブジェクトを source-request.json として保存します。
{
  "model": "gemini-3.8-flash",
  "input": "Records: A=ready; B=blocked. Return the blocked record IDs only.",
  "generation_config": {
    "max_output_tokens": 8192
  },
  "response_format": {
    "type": "text",
    "mime_type": "application/json",
    "schema": {
      "type": "object",
      "properties": {
        "blocked_ids": {"type": "array", "items": {"type": "string"}}
      },
      "required": ["blocked_ids"],
      "additionalProperties": false
    }
  }
}
入力、スキーマ、出力上限をそのまま保ち、モデルと明示的な思考設定だけを変更して hydrogen-request.json を作ります。
import json
from pathlib import Path

source = json.loads(Path("source-request.json").read_text())
target = json.loads(json.dumps(source))
target["model"] = "gemini-4-hydrogen"
target["generation_config"]["thinking_level"] = "medium"
Path("hydrogen-request.json").write_text(json.dumps(target, indent=2))
キットには両方の完全なJSONを含めています。8,192トークンはこの比較用サンプルの設定で、本番の普遍的な推奨値ではありません。最終JSONが短くても、思考で予算を使い切る場合があります。完了と打ち切りを確認し、失敗を隠すために本番上限を自動で最大まで上げないでください。
応答形式はGoogleの現在の構造化出力の仕様に従い、テキスト出力、application/json MIME型、スキーマを指定しています。スキーマが保証する形と、正しいレコードを選べたかどうかは別です。
通常の秘密情報管理方法でGoogleプロジェクトのキーを GEMINI_API_KEY に設定すると、必要に応じて次の実リクエストを実行できます。Googleに接続し、プロジェクトの割り当てや有料利用を消費する可能性があります。この記事では実行していません。
curl --fail-with-body --max-time 180 \
  'https://generativelanguage.googleapis.com/v1beta/interactions' \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  --data-binary @hydrogen-request.json \
  --output hydrogen-response.json
入力を source-request.json にし、出力ファイル名を変えて同じコマンドを実行すると、元モデルの基準結果を取れます。アカウント、入力、スキーマ、実行条件をそろえてください。最初にインタラクションの状態と、エラーまたは未完了結果を確認します。完了し、期待する出力を含む応答だけをアプリのパーサーへ渡します。JSONテキストを解析し、このサンプルでは正確に {"blocked_ids":["B"]} であることを要求します。余分なキーやIDは認めません。HTTP 200、有効なJSON、正しいタスク結果はそれぞれ別の確認です。
タイムアウト時は、取得済みのリクエストIDやインタラクションIDを残し、再試行前にサービスの状態を調べます。クライアントのタイムアウトだけでは、サーバーが停止したとは判断できません。
オフラインキットを実行し、検証範囲を理解する
Hydrogen移行キットをダウンロードして展開し、hydrogen-migration-kit ディレクトリへ移動します。全ツールを使う場合はPython 3.11以降を使用してください。リクエスト監査器自体は標準ライブラリだけで動きます。
python -m unittest test_audit.py -v
python migration_audit.py source-request.json
python migration_audit.py hydrogen-request.jsonユニットテストの期待結果は21件成功です。監査器はリクエストファイルを書き換えず、元のコピーとブロッカー・要確認事項を返します。終了コード 2 はブロッカーあり、0 はこの限定された監査でブロッカーを見つけなかったという意味です。デプロイの承認ではありません。例えばターゲットサンプルもアプリ評価が必要で、意図的に低く設定した出力上限の確認が残ります。
対象は完全なInteractions初回リクエストです。異なるプロトコルの構造、入力欠落、明示的キャッシュ依存、無効な思考レベル、出力上限の型や値、保存とバックグラウンド設定の矛盾を検出し、既定値に隠れた変更も指摘します。キャッシュ文書の復元、サーバー履歴の参照、アカウント権限の確認、サービスが受け付ける全フィールドの検証はできません。
出力にはリクエスト全体のコピーが含まれます。まず機密情報のない付属サンプルを使い、共有端末のログに秘密のプロンプトを出さないでください。APIキーをリクエストJSONに入れる必要はありません。
独立したSDKシリアライズ検証では仮想環境を作ります。
python -m venv .venv
source .venv/bin/activate
python -m pip install 'google-genai==3.3.0' httpx
python sdk_wire_check.py
Windows PowerShellの有効化は .venv\Scripts\Activate.ps1 です。依存関係のインストールはパッケージをダウンロードしますが、検証自体は明示的な架空キーと httpx.MockTransport を使います。環境変数の認証情報を読まず、モデルリクエストも送信しません。
スクリプトはインストール済みSDKで二つのGenerateContentリクエストをシリアライズします。同じ3ターンの履歴、ツール宣言、二つのツール応答が保たれることを検査します。モデルターンには並列の関数呼び出しが二つあり、合成署名は元の最初のpartにだけ残り、二つ目へ複製されません。ターゲットはHydrogenと明示的な MEDIUM 思考です。送信形式はスクリプトの隣に生成される sdk-wire-requests.json で確認できます。
これはローカルのシリアライズに関する証拠です。合成応答と署名は、サーバーでの受理、モデル間の会話継続、ツール実行器の動作を証明しません。実評価前に履歴の脱落を見つけられる点で有用ですが、実評価の代わりにはなりません。
キャッシュ内容を復元し、会話状態を保持する
明示的キャッシュIDは参照であり、文書そのものではありません。cached_content や cachedContent を削除すると、リクエストは簡単に見えても、必要な資料を黙って失うことがあります。Googleのキャッシュ文書は暗黙的な再利用と明示的なキャッシュリソース管理を区別しています。暗黙的キャッシュは、送っていない入力を復元してくれません。
キャッシュ依存の各タスクについて次を実行します。
- 呼び出し元がキャッシュ作成時に使ったシステム指示、文書、メディア参照、ツール宣言を見つけます。回収できなければそのケースの移行を止め、空の代替を同等と扱わないでください。
- バージョンと順序を記録し、外部ファイル参照が対象アカウントと経路から引き続き使えるか確認します。
- 現在のプロトコルに適したフィールドで完全なリクエストを再構築します。システムとユーザーの区別、ツールを保ち、IDを消すためだけに全内容を一つのユーザーメッセージに平坦化しないでください。
- 復元後の内容を共有予算に照らして再計算し、思考と回答の余地を残します。必要ならタスクを分割します。
- 復元資料にある既知の事実を使わなければ答えられない質問を出し、正解を確認してから旧キャッシュ依存経路を外します。
会話状態は別に判断します。Interactionsでは、保存済みの前回インタラクションを previous_interaction_id で参照できます。今回 store=false にしても、以前に保存した状態の読み出しまで禁止されるわけではありません。ただし今回の結果は保存されず、次の継続に使えません。バックグラウンド実行と store=false は両立しません。以前のIDが存在するだけでモデル間継続を推定せず、対象アカウントとモデルの組み合わせを検証するか、コンテキストを明示的に復元した新規会話で小規模に試します。
ステートレスな継続では、APIが要求する思考関連ステップや組み込みツール署名を含む完全な列を保持します。GenerateContentではモデルの内容全体とpartの順序を保ち、その後に対応するツール応答を置きます。画面に見える文章だけの会話記録では不十分です。
思考署名の欠落エラーはGeminiのツール署名エラー対処と公式の署名規則を参照してください。署名は元のpartに置き、並列関数呼び出しへ同じ署名を複製したり、代替署名を作ったりしないでください。キットの合成署名は、オフラインでシリアライズの誤りを見つけるためだけのものです。
ツール、出力、共有予算を一緒に検証する
文章を全部保持しても、アプリの動作が保たれるとは限りません。関数名、引数スキーマ、権限、呼び出しと結果の対応、結果の順序を維持します。Googleの関数呼び出しガイドはプロトコルを説明しますが、実行器は許可する操作と実際の成否を判断する必要があります。
書き込み可能なツールより先に、読み取り専用サンプルを使います。例えば lookup_record がAをready、Bをblockedとして返し、最終構造化回答がBを選ぶことを要求します。秘密情報を除いて呼び出しID、引数、結果を記録します。呼び出しが二つあれば、それぞれの対応結果を返します。対応関係が消える自由文の一括要約にしないでください。
モデル出力は、アプリが検証すべき候補データとして扱います。レコード例ならスキーマを検証し、既知のレコードと回答を照合します。書き込みなら実際の保存先を確認します。「保存できました」という生成文章は書き込みの証拠ではありません。関数ではなく画面操作を行う場合、Computer Use設定ガイドで観察、承認、実行、結果確認の追加ループを扱っています。
予算不足はタスクの失敗に見えることがあります。入力・出力使用量、取得可能な思考使用量、完了状態、打ち切りの兆候を記録してください。使用量の欠落は不明であり、ゼロではありません。プロバイダーの出力合計が思考を含む場合は二重加算しません。料金計算の前に計量単位を確認します。
長い回答では継続コントローラーかバックグラウンド経路を明示的に選び、停止条件を決めます。再開IDを保持し、完了済みの副作用を再実行せず、複数ホップを通したタスク全体の作業量を制限します。単一リクエストの上限を上げるだけでは、信頼できる長時間タスクにはなりません。
独立した合格条件を持つ回帰テストを作る
秘密情報を除去し、適切な権限のある実アプリのケースから始めます。成功ケースだけでなく、既知の失敗境界も含めます。次の表は小規模で再現できるテスト設計であり、モデルの測定結果は含みません。
| ケース | 具体的なサンプル | 合格条件 |
|---|---|---|
| 基本抽出 | A=ready; B=blocked | 完了応答を解析するとblockedのIDがBだけになる |
| キャッシュ復元 | 文書に release_owner=team_amber とあり、質問には含めない | 完全な文書を復元した後に team_amber と答える |
| 履歴の継続 | 最初にAを team_amber に割り当て、次に担当者を聞く | 選択した状態管理を通じて正しい担当が返る |
| 並列ツール | AとBへの二つの lookup_record | 対応を保持し、重複実行せず、最終結果がサンプルと一致 |
| 意図的な打ち切り | 大きめのタスクに不足する出力上限を設定 | 未完了を検出し、成功扱いにしない |
| 無効な設定 | 範囲外サンプリング値、または保存とバックグラウンドの不整合 | 無条件再試行ではなく適切なエラー処理に入る |
| 書き込みを伴うロールバック | 操作IDはあるがクライアント応答が不確定 | 再実行前に担当者か実行器が保存先を確認する |
各実行で設定バージョン、モデルID、プロンプトまたはサンプルのhash、SDKバージョン、アカウントや経路、開始終了時刻、完了状態、検証結果、取得可能な使用量を保存します。機密の生応答は通常の保持方針に従います。条件をそろえて比較し、プロンプト・スキーマ・実行器も変更したのに改善をモデルだけに帰属させないでください。
料金や割り当てを消費する評価を始める前に、合格条件を定めます。スキーマ妥当性と副作用の安全性には厳格な基準を置けます。正答率、遅延、費用には用途に合った閾値と意味のあるサンプル数が必要です。この記事は万能な割合を示さず、七つのサンプルだけで本番信頼性を証明したとも扱いません。特に、もっともらしく見えて正解を機械的に判定できる検証に通らなかった回答を個別に調べてください。
段階的に切り替え、使えるロールバックを残す
まず件数を絞った新規の読み取り専用タスクをHydrogenへ送ります。元と移行先の設定を独立に選べる状態に保ち、同じ承認済みサンプルのバージョンを使います。範囲を広げる前に失敗と未完了応答を確認します。書き込みタスクは、実行器、重複防止、保存先の確認が合格してから追加します。
形式不正は同じ入力を再送せず修正します。モデルにアクセスできなければアカウント、経路、正確なIDを調べます。一時的な障害はバックオフ付きの有限回再試行とし、識別子を残します。Ofox利用時はエラー処理と再試行の文書に従ってください。Gemini 4 APIエラーの診断記事も権限、形式、レート制限の切り分けに役立ちます。ただしモデル固有の例はArgonなので、HydrogenのIDとしてそのまま使えません。
ロールバックは対象にできる新規タスクの設定を元へ戻すことで、進行中のすべてのインタラクションを無条件に再実行することではありません。新たな副作用を止め、不確定な操作を特定し、保存先を見てから再開、補償処理、やり直しを選びます。旧経路はアクセスとモデル提供が有効な期間だけ使えます。保存済み設定では提供終了や権限喪失を回避できません。
実際の経路でコンテキスト復元、ツール状態の保持、出力の正しい検証、実行制限、ロールバックの演習を示せたときに、移行準備が整います。バージョン付き証拠を残し、後のプロンプト、SDK、プロバイダー変更と今回のモデル移行を区別できるようにしてください。