Opusで作った動画に音声を追加:OfoxのGemini TTSからMP4まで
Ofoxで実際に生成した5つの音声を測定し、シーンからはみ出すナレーションを調整してMP4に合成。Pythonコード、WAV、再現用動画を公開します。
 Ofox
Opusを使って制作した動画にAIナレーションを付けるには、まず音声を生成し、その実際の長さを測り、映像のタイムラインに配置してから書き出します。この記事ではOfox API経由のGemini 3.8 Flash TTSとPython、FFmpegを使い、32秒のMP4を作ります。配布する音声は2026年10月9日に実際のAPIレスポンスから取得したものです。
本記事はOpus動画制作ガイドの音声工程を扱います。映像は同シリーズの既存の30秒デモを再利用しており、画面は9月30日に撮影した過去の参考素材です。現在の製品画面をすべて表しているわけではなく、今回新たにOpusで映像を生成したという主張でもありません。音声生成はGemini、配置と書き出しはローカルコードが担当します。
再現用キットをダウンロード、ナレーション付きMP4を見る、合成済みWAVをダウンロード。保存済み音声からの再合成にはAPI利用料がかかりません。サンプル音声は英語であり、この記事の日本語化は日本語音声の検証を意味しません。
1. ナレーションをシーンごとに分ける
連続した音声はポッドキャストに向いています。一方、画面操作のデモでは、ドキュメントについて話しているときに、そのドキュメントが表示されている必要があります。今回は説明を5つに分け、各シーンの音声を個別に生成しました。修正が必要な文だけを作り直せるため、音声全体の再生成を避けられます。
内容は、制作の目的、モデル一覧、ドキュメント、APIリファレンス、最後の確認です。モデル数、割引、性能順位には触れません。過去の画面を再利用するとき、そこに写っている数字を現在の製品仕様として語らないためです。
生成前に、開始位置、許容する終了位置、発話する全文を記録します。元の音声を置き換えるのか、ミックスするのかも決めてください。このサンプルは元の音声を置き換えます。BGM、声のクローン、リップシンク、単語単位の字幕同期は含みません。それぞれ別の素材と検証が必要です。
映像側の構成はスクリーンショットから作るデモ動画、字幕の時間管理はナレーションと字幕の同期ガイドを参照してください。この記事で追加するのは、Ofoxへの実際のTTSリクエストと、その出力の測定です。
2. モデルID、音色、出力形式を確認する
検証した設定はgoogle/gemini-3.8-flash-tts、音色Kore、言語en-US、speed: 1.0、response_format: wavです。Gemini TTSモデルページから正確なIDを確認し、通常のGeminiテキストモデル名と混同しないでください。取得したファイルは24,000 Hz、モノラル、16ビットPCMのWAVでした。拡張子だけでは形式を確認できないので、ストリーム情報とデコード結果も調べます。
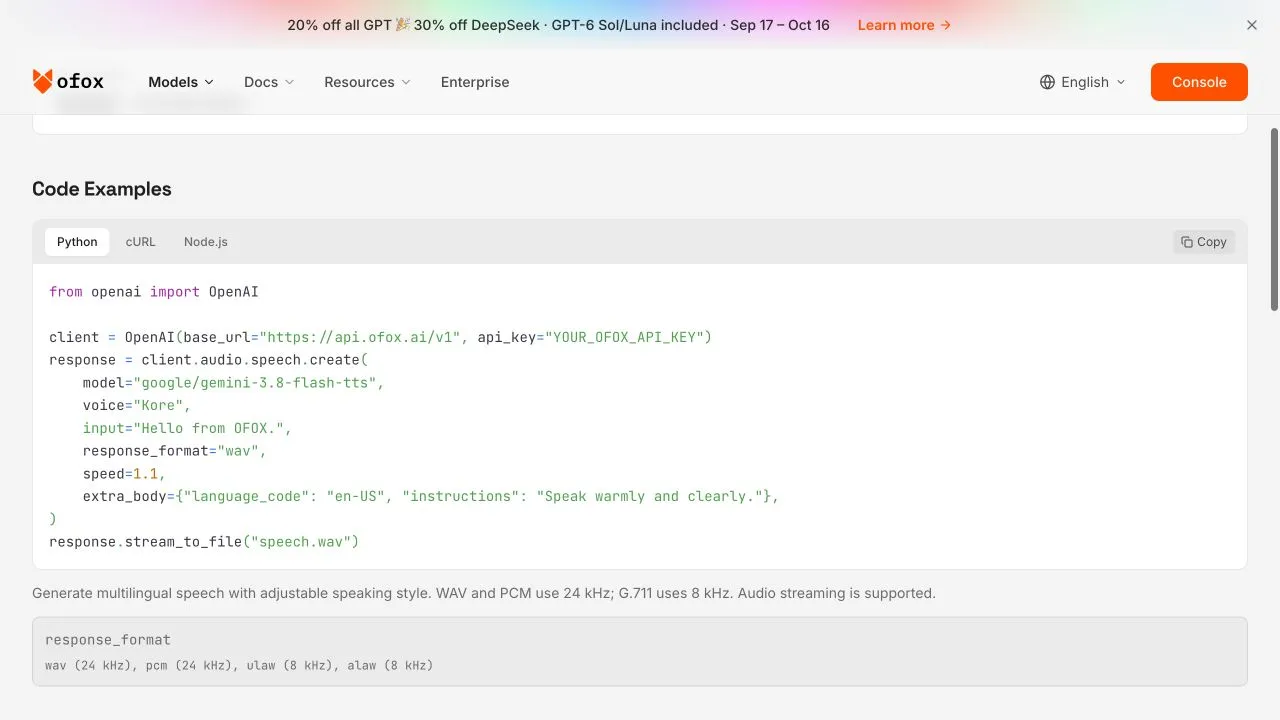
2026年10月9日の実際の英語画面です。画面例のspeedは1.1ですが、本検証の記録は1.0です。画面が証明するのは表示されている接続方法であり、生成成功は配布WAVとリクエスト記録で確認します。
Python 3、requests、FFmpeg、ffprobeを準備します。APIキーはOFOX_API_KEY環境変数から読み込み、共有コードやブラウザー側のコード、Gitに含めないでください。以下はUnix系シェルの例です。Windowsでは環境変数設定や仮想環境の有効化方法が異なりますが、Pythonのリクエスト処理は共通です。
python3 -m venv .venv
. .venv/bin/activate
python3 -m pip install requests
ffmpeg -version
ffprobe -versionWAVは圧縮音声より大きいものの、検査と編集が容易です。最終MP4を作る段階でAACに変換し、中間素材の再圧縮を避けます。Googleの音声生成・形式ドキュメントと、Ofox側の公開インターフェースは区別してください。上流で使える設定が、すべてのゲートウェイで使えるとは限りません。
3. 小さなリクエストから始める
キットのaudio_api.pyは、接続先をOfoxに固定しています。有料リクエストの前にメディアツールの存在を確認し、HTTPステータスとContent-Typeを検証してから音声を保存します。続いて長さを測定し、ファイル全体をデコードします。Authorizationヘッダーは記録せず、課金される可能性のあるPOSTを自動再試行しません。
python3 audio_api.py speech --engine gemini \
  --text narration.en.txt --output first-take.wav --language en-US
これは同梱した短い全文から連続音声を作るコマンドです。完成動画では5つの文を個別に生成しています。基本的なPythonリクエストは次のとおりです。検査や証拠保存まで必要なら、キットのクライアントを使用してください。
import os
from pathlib import Path
import requests

response = requests.post(
    "https://api.ofox.ai/v1/audio/speech",
    headers={"Authorization": "Bearer " + os.environ["OFOX_API_KEY"]},
    json={
        "model": "google/gemini-3.8-flash-tts",
        "voice": "Kore",
        "input": "A clear product video starts with a clear brief.",
        "language_code": "en-US",
        "speed": 1.0,
        "response_format": "wav",
    },
    timeout=(15, 120),
)
response.raise_for_status()
if not response.headers.get("content-type", "").startswith("audio/"):
    raise RuntimeError("Expected audio; inspect the response before saving")
Path("line.wav").write_bytes(response.content)
最初の連続音声はHTTP 200で、長さは10.4秒でした。その後、5つの文も個別に生成できました。この結果は今回の呼び出しの成功を示すもので、再生成時の長さや常時のサービス容量を保証しません。設定と音声ハッシュを一緒に保管し、台詞を変更したあとに古い音声を新しい結果として扱わないようにします。
タイムアウトでは、再送前に元の処理状況と利用量を確認します。レスポンスが届かなかったからといって、生成されていないとは限りません。JSONのエラーをWAVとして保存してしまった場合も、音声コーデックの問題として調べる前に、HTTPレスポンスの保存方法を修正してください。
4. 測定結果に合わせて時間枠を修正する
次のコマンドで各WAVを測ります。表の長さには末尾の無音が含まれる場合があり、音素単位の発話境界ではありません。
ffprobe -v error -show_entries stream=codec_name,sample_rate,channels \
-show_entries format=duration -of json scenes/line-1.wav| シーン | 実際の英語台詞 | 開始 | WAV長 | 音声終了 |
|---|---|---|---|---|
| 目的 | A clear product video starts with a clear brief. | 0.35秒 | 3.56秒 | 3.91秒 |
| 一覧 | Show the real interface. Here, we begin with the model catalog. | 4.35秒 | 4.64秒 | 8.99秒 |
| 文書 | Then show where a viewer can find the documentation. | 11.35秒 | 3.44秒 | 14.79秒 |
| API | Connect each scene to an actual page, such as this API reference. | 18.35秒 | 4.96秒 | 23.31秒 |
| 締め | Keep the message simple. Plan, build, and verify. | 25.35秒 | 5.44秒 | 30.79秒 |
最初の文は予定した3.60秒の終了位置を0.31秒超えました。次のシーンより前の4.00秒まで枠を広げています。最後の文は29.50秒の終了位置を1.29秒超え、元の30秒動画にも収まりませんでした。そこで最終フレームを2秒保持し、動画を32秒に延長しました。新しい終了枠は31.50秒です。
語尾を切ったり、説明なしに再生速度を上げたりはしていません。厳密に30秒の納品が必要なら、この32秒版は条件を満たしません。最後の台詞を短くしてその文だけ再生成し、もう一度測定します。speedの指定は、5.44秒の音声を正確な目標時間に変換する演算ではありません。
5. 保存済み素材で合成する
解凍したキットには、scenes/line-1.wavからline-5.wav、時間情報、以前に作成した音声なしの参考動画source.mp4が入っています。キットのディレクトリで実行します。
python3 assemble_scenes.py scenes source.mp4 rebuiltこの処理はAPIを呼び出さず、APIキーも不要です。ハッシュ、PCM形式、修正後の時間枠を検証してから、開始位置に音声サンプルを配置し、残りを無音で埋めます。元の映像と新しい音声だけを選び、H.264/AACのMP4にします。枠を超える音声は拒否し、-shortestで語尾を黙って切り落とす設計にはしません。
24 kHzの音声クロックと映像のフレームクロックは別です。サンプル単位で配置しても、単語単位の字幕時刻が得られるわけではありません。汎用のmux.pyは完成した音声を動画に差し替える用途で、動画より長い音声を拒否します。この例のように最後を延長する編集判断は、専用のシーン合成スクリプトで処理してください。
自分の動画プロジェクトをOpusに編集させるなら、測定後に次のような依頼を使えます。これは再利用用のテンプレートで、新たなモデル実測の記録ではありません。
既存の動画合成と時間データだけを更新してください。
承認済みのスクリーンショットとシーン順序は維持します。
添付WAVを使い、音声を再生成せず、発話を削らないでください。
timing.jsonの実測開始時刻に各文を配置します。
書き出し前にはみ出しを報告し、延長する場合は変わる切点と総時間を示します。
表示文字を省略せず、変更ファイル、書き出しコマンド、確認フレームを返してください。
文単位の時刻からリップシンクや単語単位の同期を主張しないでください。
6. エディターではなく書き出したファイルを検査する
ffprobe -v error -show_streams -show_format -of json rebuilt/narrated.mp4
ffmpeg -v error -i rebuilt/narrated.mp4 -f null -
配布動画のタイムラインは32秒で、映像はH.264、音声はAACです。合成元WAVは正確に32秒です。圧縮音声のパディングにより、コンテナやストリームがわずかに異なる時間を示す場合があります。小数点以下の差だけで、発話が切れたとは判断できません。
最初の文、各切点、最長の文、最後の語を確認してください。製品名や略語の発音、間の取り方は実際に聞く必要があります。記録した検査は生成成功、形式、長さ、配置、デコードであり、人による比較試聴の結果ではありません。Geminiが他サービスより自然だという比較結論も出していません。
日本語、韓国語、ロシア語にする場合は、台詞を別途生成して検査します。語数、発音、間が変わるため、英語版の時刻をそのまま使えません。字幕を翻訳することと、音声をローカライズすることも別の工程です。
7. エラーの発生箇所を切り分ける
| 症状 | 確認箇所 | 対処 |
|---|---|---|
| 401とquota表示 | エラー本文、request ID、プロバイダーの制限か | Ofox残高ゼロと決めつけず、該当経路の利用枠を確認 |
| 形式指定で400 | 正確なモデルと形式の組み合わせ | この例は検証済みのWAV設定から始める |
| WAVを開けない | JSONエラーを保存していないか | HTTP状態とContent-Typeを確認し、エラーを別保存 |
| 音声がシーンを超える | 実測長と次の切点 | 文を短くするか映像を延長し、再検査 |
| MP4に音がない | 最終ファイルのストリームとマッピング | 新しい音声を明示的に選び、書き出しをデコード |
| 再試行で重複費用 | 元リクエストの結果と利用量 | 有料POSTを無条件に再送しない |
準備時には、同じOfoxキーでGeminiは成功し、ElevenLabs音声とScribeは401の利用枠エラーを返しました。Ofox残高の読み取り結果は正でした。この証拠からOfoxへの追加入金を求めることはできず、影響を受けた上流経路の確認が必要です。具体的な上流アカウント状態は未確認です。ElevenLabsはこの種の401 quotaエラーを説明しています。これは検証日の観察で、サービス全体の恒常的な障害という意味ではありません。
費用も、表示料金、消費量、確定請求を分けます。音声トークン課金では動画の秒数だけから正確な請求を計算できません。本記事は請求照合を完了していないため、合計費用や削減率を掲載していません。大量生成の前にモデルページと自分の利用明細を確認してください。
台詞、5つの元音声、時間情報、合成WAV、MP4を一つの版として保存します。次回は変更した文だけを入れ替え、再測定して書き出してください。文字数が似ていることは、同じ長さになる証拠ではありません。
よくある質問
- この音声はOpus 5.5が生成したものですか?
- いいえ。WAVはOfox経由のGemini 3.8 Flash TTSで生成し、映像と音声はFFmpegでローカル合成しました。Opusは動画プロジェクトの編集に利用できますが、今回は新たなOpus呼び出しの検証ではありません。
- APIを使わずに完成動画を再現できますか?
- できます。配布キットには生成済みの5つのWAVと元のMP4が含まれ、ローカル合成ではAPIを呼びません。音声を再生成する場合は、有効なキー、モデル利用権限、利用枠が必要です。
- speedを上げれば指定時間に正確に収まりますか?
- 保証はありません。生成結果を測定し、必要に応じて台詞を短くするか映像を延長します。音声の末尾を黙って切り落とさないことが重要です。