Gemini 4 Carbon API 怎么收费?算清一个完整任务的成本
用经过离线测试的 Python 账本计算 Gemini 4 Carbon 任务成本,区分当前与 12 月费率,并计入缓存、思考、重试、Agent 多轮调用和独立工具费用。
 Ofox
估算 Gemini 4 Carbon 的任务成本,要把每次独立尝试和续接步骤中已经确认的费用加起来:未命中缓存的输入、缓存命中的输入、包含思考的生成 token,以及单独计费的工具。计算前先选对费率生效期间。 用户最终看到的答案只是其中一部分。重试或前面的 Agent 调用,即使没有产出被接受的结果,也可能消耗资源。
本文提供可下载的完整 Python 计算器、统一的输入格式和可复算例子。采用的是 Google 对 gemini-4-carbon 公布的 Standard 美元费率,核验日期为 2026 年 11 月 15 日。不适用于 Batch、Flex、Priority、协商合同或 Ofox 路由的报价。如果还没有完成首次请求,可先阅读 Carbon API 接入教程。
本文由 Ofox 发布。计算器及命令行工具通过了 24 项离线测试。下文的 token 数量和任务结果全部是假设样例,不是真实模型运行记录或供应商账单。工具包不会调用 API、加载密钥,也不会自动解释供应商的原始 usage 数据。它用于复算已经核实口径的用量账本,并发现常见重复计数问题。
先确认模型、服务档位和价格生效日期
Google 的 Carbon 价格表(英文) 列出了以下 Standard 价格。所有费率的单位都是 美元/百万 token,不是每次请求或每个成功任务。
| 计费类别 | 截至 2026 年 11 月 30 日 | 自 2026 年 12 月 1 日起 | 对应的用量 |
|---|---|---|---|
| 普通输入 | $2.00 | $4.00 | 未命中缓存的输入 token |
| 缓存输入 | $0.10 | $0.20 | 实际命中缓存的输入部分 |
| 输出,含思考 | $10.00 | $20.00 | 已确认合并口径的计费生成量 |
在本文核验日,12 月这一列仍是未来价格场景,不是当前价。在 token 数量完全相同的情况下,这三个 token 费率翻倍;单独的工具费用不会因此自动翻倍。Google 没有为 Carbon 列出 Free 档位,工具额度也不意味着 Carbon 的 token 处理免费。
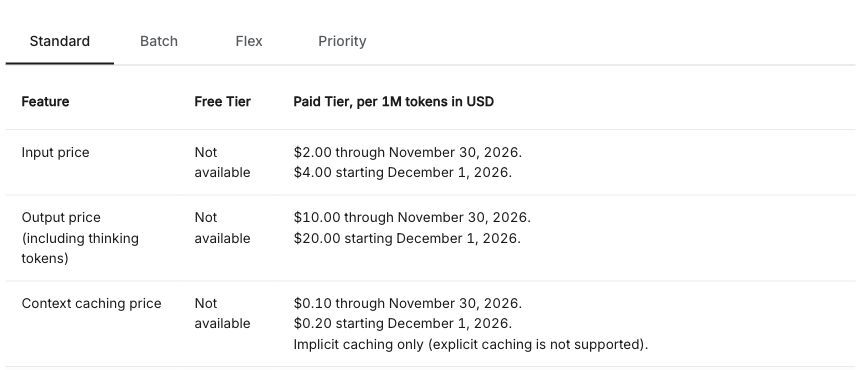
截图来自英文官方 Carbon 价格页面,仅裁取 Standard token 费率区域,不含账户信息。它是价格来源,不是账单,也不是 Ofox 报价。
记录价格时,要同时保留模型 ID、服务档位、币种、单位和生效期间。从相邻 Gemini 型号或另一推理档位抄来的价格,不能直接用于 Carbon 请求。Google 模型选择指南 讨论任务适配;本文没有证明 Carbon 是获得同等结果最便宜的选择。
Google 还对部分工具单独收费。Search grounding 的说明指出,一个客户请求可能触发多次搜索查询,工具计费需要按实际查询口径核对。共享额度和限制应查看当前工具价格部分。除非实际计费单位就是应用请求,否则不要把一个固定工具单价乘以应用请求数。计算器接收的是已经确认的独立美元工具费用,不是猜测的工具调用次数。
先统一用量口径,再代入公式
账本使用本文自定义的字段名,不是 Google 或 Ofox 的响应字段名。填入真实数值之前,先确认具体端点、SDK 版本和执行模式的字段约定,并私下保留原始用量记录,以便说明转换过程。
| 账本字段 | 必须满足的含义 | 要避免的错误 |
|---|---|---|
id | 一次独立计数的尝试或续接步骤的唯一标识 | 把同一请求的不同记录快照重复记账 |
input_total | 该行全部计费输入,包含其中的缓存部分 | 把仅统计未缓存输入的字段当作输入总量 |
cached_input | input_total 内已确认命中缓存的部分 | 假定所有符合缓存条件的 token 都命中了缓存 |
generated_including_thinking | 思考只计入一次的合并计费生成量 | 给已经包含思考的字段再加一次思考 token |
tools_usd | 用十进制字符串表示的已知独立工具费用;只有确认无费用时才填 "0" | 把未知费用或工具 token 数当作零美元费用 |
Google 的 token 计数文档(英文) 展示了 total_input_tokens、total_output_tokens、total_thought_tokens、total_cached_tokens 和 total_tool_use_tokens 等独立字段。仅凭名称,无法得出适用于所有账单的映射规则。本文核对的文档和 SDK 注释,也不足以证明所有 Carbon 路由及模式下,输出与思考都具有同一种包含关系。
因此需要按条件转换:如果对应接口约定确认输出总量已经包含思考,就使用该合并值一次;如果确认可见输出和思考是互不重叠的计费量,就相加一次,得到统一字段。无法确认关系时,应停止计算并标记为未知,不能因为数字看起来合理就任选一种算法。工具使用 token 数同样不自动等于额外的货币费用。
还要确认 usage 对象覆盖的是单次请求、单个续接步骤,还是累计交互。不要把流式返回的累计快照逐个相加。如果最终总量已经包含前面的步骤,要么只用最终值一次,要么使用已确认互不重叠的逐步用量,不能两者混加。
统一口径后,每行公式如下:
ordinary_input = input_total - cached_input
row_cost_usd = (
    ordinary_input * ordinary_input_rate
    + cached_input * cached_input_rate
    + generated_including_thinking * generated_rate
) / 1_000_000 + tools_usd

task_cost_usd = sum(cost of each non-overlapping row)
这就是为什么缓存输入必须是总输入的子集。如果先把全部输入按普通费率计费,再额外加上缓存部分,这些 token 就被算了两次。也不要给这个 Carbon 公式添加显式缓存存储费用:这里引用的是隐式缓存命中输入的价格,Carbon 不支持显式缓存。
在本地运行完整计算器
下载 Carbon 任务成本工具包,解压后进入 carbon-task-cost-kit。其中包含 cost.py、命令行入口 calculate.py、两个测试模块、两份示例账本和英文 README。程序只依赖 Python 标准库,不需要模型 SDK、密钥或网络调用。
使用 Python 3.11 或更新版本。替换示例数据前,先运行测试:
python -m unittest test_cost.py test_cli.py -v预期结果为 24 项测试通过,其中包含 16 项计算器检查和 8 项命令行检查。覆盖十进制运算、缓存子集校验、缺失用量、重复 ID、无效费率期间、重复 JSON 字段、错误账本及精确命令行输出。这些测试证明的是本地计算器行为,不是供应商计费实现正确。
工具包中的 single-attempt.json 是一次假设调用:
[
  {
    "id": "illustrative-success",
    "input_total": 50000,
    "cached_input": 40000,
    "generated_including_thinking": 6000,
    "tools_usd": "0"
  }
]
运行内置的三个场景:
python calculate.py single-attempt.json --period through-2026-11-30
python calculate.py single-attempt.json --period from-2026-12-01
python calculate.py retry-task.json --period through-2026-11-30
总费用的美元结果依次为 "0.084"、"0.168" 和 "0.234"。JSON 输出也会把每行拆分成普通输入、缓存输入、生成 token 和工具费用。金额以十进制字符串输出,保留精确运算结果,不在每个中间步骤都四舍五入到美分。应先保存精确结果,再按展示需求格式化。
使用自己的数据时,先把示例复制为一个新 JSON 文件,填入已经确认含义的数值,再执行 python calculate.py your-ledger.json --period through-2026-11-30,或明确选择另一费率期间。扩大到大量记录之前,先手算一条,对照各组成部分。空账本会被拒绝,不能把空记录当作任务成本为零的证据。
遇到缺失数量、负数或非整数 token、缓存输入大于总输入、重复 ID、重复 JSON 字段及未知字段,程序都会报错退出。工具费用必须是已知的非负十进制值,在 JSON 中可写成 "0.01" 这样的字符串。单独追加思考量、逐行覆盖价格等额外字段也会被拒绝,以保证输入口径明确。人工备注和原始记录引用应另存文件,不要不加区分地塞进计算字段。
复算三个完整任务场景
以下算式使用假设的、已经统一口径的用量,不预测 Carbon 对你的提示词会消耗多少 token、是否命中缓存,也不预测结果是否达到质量要求。
按当前价格计算一次被接受的尝试
假设输入共 50,000 token,其中 40,000 命中缓存;包含思考的生成量为 6,000 token;单独工具费用确认为零。普通输入就是 10,000 token。
- 普通输入:
10,000 × $2 / 1,000,000 = $0.020。 - 缓存输入:
40,000 × $0.10 / 1,000,000 = $0.004。 - 含思考的生成量:
6,000 × $10 / 1,000,000 = $0.060。 - 合计:$0.084。
最终文本的可见 token 可以少于 6,000;本例生成量已经包含思考,不能再加一次思考数量。
按已公布的 12 月价格计算相同用量
保持用量不变,得到 $0.040 + $0.008 + $0.120 = $0.168。由于这三个 Standard token 费率均翻倍,结果恰好是纯 token 场景的两倍。这是在相同用量下比较两个费率期间,不是预测真实任务到了 12 月仍消耗相同 token。
如果两个期间都另外有一笔已知的 $0.01 工具费,总额就分别是 $0.094 和 $0.178。把第一个总额直接翻倍为 $0.188,会错误地把没有变化的工具费也翻倍。这里的 $0.01 是举例假设,不是 Google 工具报价。
第一次失败,第二次才产出被接受的结果
内置 retry-task.json 在上面的成功示例之前,增加了一次用量已知的尝试:50,000 个未缓存输入 token、5,000 个包含思考的生成 token。两次都假设独立工具费为零。
[
  {
    "id": "illustrative-failed-attempt",
    "input_total": 50000,
    "cached_input": 0,
    "generated_including_thinking": 5000,
    "tools_usd": "0"
  },
  {
    "id": "illustrative-success",
    "input_total": 50000,
    "cached_input": 40000,
    "generated_including_thinking": 6000,
    "tools_usd": "0"
  }
]
第一行费用为 $0.100 + $0.050 = $0.150,加上成功的一行后,整个任务花费 $0.234,尽管被接受的那次尝试单独只花了 $0.084。这里的“失败”是指假设中已有独立计费用量记录的尝试,不代表所有被拒绝的 HTTP 请求都会产生这笔费用。
只改变一个条件,可以看到计算结果对哪些量敏感:
| 假设场景 | 总费用(美元) | 变化的条件 |
|---|---|---|
| 当前费率,40,000 缓存命中,6,000 生成 token | $0.084 | 上述基准 |
| 当前费率,无缓存命中,总输入和生成量不变 | $0.160 | 50,000 输入全部按普通费率 |
| 当前费率,40,000 缓存命中,16,000 生成 token | $0.184 | 合并生成量增加 10,000 |
| 12 月费率,基准 token 用量 | $0.168 | 只改变费率期间 |
| 当前费率,基准加已知 $0.01 工具费 | $0.094 | 只增加独立工具费 |
| 12 月费率,基准加相同 $0.01 工具费 | $0.178 | token 费率变化,工具费不变 |
这些是计算例子,不是模型基准测试,也不承诺修改某个提示词就能省下表中的差额。
理解缓存门槛和 Agent 的短轮次
Google 的 缓存指南(英文) 列明,Carbon 隐式缓存的最低门槛为 4,096 个输入 token。达到门槛并不保证命中缓存。引用的缓存费率比普通输入低 95%,但只适用于实际命中的 token,不表示全部 token 或整个任务的费用都降低 95%。
Carbon 不支持显式创建缓存,也不支持 cached_content 引用。不要为了套用优惠列而添加显式缓存 ID。保持稳定的共同前缀,并在相近时间发送相似请求,可能提高隐式复用机会,但账本应以真实报告的命中用量为准。文档用 usage.total_cached_tokens 报告缓存命中量;转换时仍需确认它与该端点输入总量的关系。
同一指南还描述了 Gemini 4 多轮对话和 Agent 循环的另一条规则:只有新请求增加至少 2,050 token,才会缓存整个前一请求;新增量包含模型输出、思考和函数结果。新增量不足时,前一请求最后的 2,050 token 会按普通输入费率重新处理。
这条 2,050 token 规则与 4,096 token 缓存资格门槛不是一回事。它没有说整段对话的缓存全部失效,也没有定义每轮固定加收一笔费用。如果统一后的输入和缓存数量已经反映了实际处理量,再追加 2,050 就会重复计数。应把规则用于解释意外用量,而不是在已测字段上凭空加量。
例如,两种 Agent 设计即使保留了相同的长指令,也可能因为每轮追加的新内容不同而产生不同输入费用。比较时查看实际缓存和输入记录;不要为了跨过门槛刻意填充提示词,却不评估新增处理量和任务结果是否真的改善。
把思考、历史和续接纳入预算
Carbon 文档(英文) 说明,max_output_tokens 限制的是思考与输出的合计,不是整个 Agent 任务的美元预算。输入、工具费、重试和后续调用,仍可在单次响应生成上限之外继续增加费用。
Carbon 支持 low、medium、high 三种思考级别,文档默认值为 medium。降低思考级别可能同时改变消耗量和产出有用结果的概率。如果需要更多重试,单次更便宜不意味着完成任务更便宜。应以相同任务和验收标准比较后再选择;本文没有提供三个级别的质量实验。
长输出可能跨越多个续接步骤。服务端后台续接可能提供累计交互数据,而客户端循环可能产生独立记录。Carbon 的共享上下文包含输入、推理和输出,因此较大的上下文窗口不代表三部分分别都有独立额度。Carbon 配置教程 说明了请求配置和续接方式;费用账本要遵循实际返回用量的统计边界。
对于多轮 Agent,应追踪每次请求带入哪些历史和工具结果。即使用户只增加一句话,计费输入也可能包含保留上下文;反过来,如果统一字段已经正确区分缓存部分,也不应把这部分再按普通输入收费。不要把最终累计交互与组成它的各个步骤相加。
实际费用控制应结合单响应生成上限、Agent 最大步数、不确定结果的处理策略,以及步骤之间检查的任务预算。计算器可以复算已知用量,或明确标注为假设的预测值;它无法保证正在执行的请求恰好在某个美元金额停止,也不能推断未报告的费用。
重试和缺失用量需要先核账
客户端超时不能证明服务端有没有执行请求。HTTP 报错不能证明所有这类尝试都收费;缺少 usage 也不能证明没有消耗。保留请求标识,先将该记录标为未知,等待供应商记录确认。不要为了让计算器接受账本而填入虚构的零。
重试前要区分鉴权、访问资格、额度、无效参数和暂时性失败。Gemini 4 API 报错指南 提供了有用的排查分类,但其中模型示例是 Argon,不是 Carbon。使用 Ofox 自有 API 的应用,可参考对应的 错误处理与重试文档;引用它不表示 Ofox 已支持本文的 Carbon 路由。
每次真正独立的尝试只记录一次。重试可能是新请求,而读取结果的 GET 可能只是取回已经执行的工作;没有检查接口约定前,不能把两者都当成第二次生成。同一底层请求的应用日志和供应商日志,也不能因为来源不同就变成两行费用。
成功应在任务层面定义。编程任务的验收记录可以写明要求的改动、对应测试结果和最终产物是否被接受;信息提取任务则可以记录 schema 是否有效、内容是否与核验过的来源匹配。HTTP 200 本身不能证明这两类任务成功。把验收证据与账本放在一起,并保护其中的私有材料。
比较替代方案时,使用相同任务集和验收规则,纳入已知失败尝试,并单独报告未解决的用量。每个被接受任务的成本,才能用可归属的总支出除以通过验收的任务数。如果没有任务通过,应如实报告,不能编造一个有限的每成功任务成本。本文只是给示例设定了验收标签,没有测量成功率。
将账本与供应商记录逐项核对
先挑一个能解释清楚用量边界的小任务。私下保存原始响应、口径转换说明、精确模型和档位、价格快照、计费期间、独立尝试 ID、计算器版本及验收结果。运行账本后,把各组成部分与供应商记录对照;在把估算扩大到上千个任务之前,先查明差异。
如果一个任务跨越价格调整日,把记录分到对应期间,分别计算后再加总精确金额。命令行工具有意让一份输入只采用一个明确的价格期间,不推断计费日期或时区,也拒绝逐行价格覆盖。真实记录归属哪个期间,应按供应商实际生效日期规则判断。即使运算完全精确,未来价格模拟仍然只是预测。
用量计算结果还应与发票层面的税、汇率、协商调整及舍入分开。计算时保留完整十进制精度,并记录之后为展示做的舍入。不要用今天的价格重写历史账单。
对于 Ofox 已支持的模型,用量追踪文档 说明请求、token 和费用拆分,计费文档 则指向费用视图和模型目录。11 月 15 日的核对追溯了 ofoxai/home-page 仓库提交 0e0c8cc6e655b606466142aae0929a666fbaaf0e 中的 catalog 代理,并保存了当前公开响应的全部 133 条记录。该快照没有 Carbon 条目。这不能证明它永远不可用,但意味着本文没有经过核实的 Ofox Carbon 报价;上面的 Google 价格不能作为 Ofox 价格。
Ofox 的 请求内容日志 与用量、费用记录是不同功能。内容留存默认关闭,只有获授权的团队管理员启用后,才在配置范围内记录后续请求。不要假定可以找回以前的提示词,也不要认为核算成本必然需要保留完整内容。采集证据时应遵循团队的数据处理要求。
最终要交付的是一份能追溯到已知用量、指定费率期间和任务验收结果的账本。如果某个量仍不确定,就保留这个限制。口径清楚、可以复算的结果,比建立在未验证假设上的精确数字更有价值。