Images API
Zwei Endpunkte: Generieren (Text → Bild) und Bearbeiten (Bild + Text → Bild). Beide Antworten folgen der OpenAI-Standardstruktur data[0].b64_json.
Seedream und Qwen-Image unterstützen /v1/images/edits nicht. Bild-zu-Bild läuft bei ihnen über den Endpunkt generations, allerdings mit unterschiedlichen Feldern für Referenzbilder: Seedream verwendet image, Qwen verwendet input_images — verwechseln Sie die beiden nicht. Wenn Sie bei Gemini die Auflösung steuern möchten (512 bis 4K), nutzen Sie das native Gemini-Protokoll. Die Parameterunterschiede der einzelnen Reihen finden Sie auf der jeweiligen Seite der Reihe.
Schnellstart
Eine minimale, lauffähige Anfrage: ein Bild mit 1024×1024 generieren, dekodieren und als output.png speichern.
https://api.ofox.ai/v1https://api.ofox.ai/v1/images/generationshttps://api.ofox.ai/v1/images/editsopenai/gpt-image-2.5-flarePython
import base64
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_OFOX_API_KEY",
    base_url="https://api.ofox.ai/v1",
    timeout=600,  # die Bild-API antwortet synchron und braucht oft länger
)

resp = client.images.generate(
    model="openai/gpt-image-2.5-flare",
    prompt="Ein roter Apfel auf einem weißen Tisch",
    size="1024x1024",
    quality="low",
)

with open("output.png", "wb") as f:
f.write(base64.b64decode(resp.data[0].b64_json))Die API antwortet synchron; setzen Sie das Timeout Ihres Clients auf 600 Sekunden. Anfragen mit hoher Qualität, großen Formaten sowie Bearbeitungen können mehrere Minuten dauern; siehe gemessene Latenz.
Alle Reihen werden auf dieselbe Weise aufgerufen; für einen Modellwechsel ändern Sie nur model. Wertebereiche und reihenspezifische Parameter unterscheiden sich; siehe die einzelnen Parameter unten.
Bilder generieren
POST https://api.ofox.ai/v1/images/generationsAnfrageparameter
Die folgenden Werte und Standardwerte gelten für die Reihe GPT Image (gpt-image-2.5-flare, gpt-image-2.5-sunburst, gpt-image-2). Abweichungen anderer Reihen sind jeweils vermerkt. Gemessene Details: Reihe GPT Image.
Modell-ID; Groß- und Kleinschreibung wird unterschieden. Eine falsche Schreibweise liefert 404 model_not_found.
▸ Details
Die unterstützten Modelle stehen in der Tabelle oben auf dieser Seite. Verwenden Sie die vollständige ID mit Anbieterpräfix, z. B. openai/gpt-image-2.5-flare.
Beschreibt das zu generierende Bild.
Ausgabegröße. Breite und Höhe sind frei wählbar, müssen aber vier Regeln erfüllen, andernfalls erhalten Sie 400 Invalid size.
▸ Details
Die vier Regeln:
- Breite und Höhe jeweils durch 16 teilbar
- Längste Kante ≤ 3840
- Seitenverhältnis zwischen 1:3 und 3:1
- Gesamtpixelzahl ≥ 655.360 (
768x768ist unzulässig,1024x768ist zulässig)
Weggelassen oder auto: Das Modell entscheidet; gemessen wurden 1254×1254. Geben Sie die Größe explizit an, wenn Sie eine feste Größe benötigen. Für andere Reihen gelten andere Größenregeln; siehe die jeweilige Seite der Reihe. Details: GPT Image · Größe.
Qualitätsstufe; bestimmt direkt den Preis. gpt-image-2 hat kein xhigh / max.
▸ Details
gpt-image-2hat keinxhigh/max; diese Werte liefern 400.- Die Werte
standard/hdaus der DALL·E-Ära werden nicht angenommen und liefern 400. - Weglassen ist nicht gleichbedeutend mit
medium: Das Modell wählt selbst eine Stufe (gemessen:low). Setzen Sie den Wert explizit, wenn Sie stabile Qualität und Kosten benötigen.
Die meisten anderen Reihen haben keine Qualitätsstufen; siehe die jeweilige Seite der Reihe. Details: GPT Image · Qualität.
Anzahl der Bilder; jedes Bild wird einzeln abgerechnet. Von Gemini-Modellen nicht unterstützt; senden Sie den Parameter dort nicht.
Dateiformat der Ausgabe.
▶Erweitert · 7output_compression · background · moderation · stream · partial_images · input_images · extra_body.provider.typeExpand
Komprimierungsgrad; wirkt nur bei jpeg / webp.
Hintergrund. transparent erfordert ein Format mit Alphakanal (png / webp).
Strenge der Inhaltsmoderation.
Antwort per Streaming übertragen. Zusammen mit partial_images erhalten Sie während der Generierung Zwischenbilder.
Anzahl der per Streaming übertragenen Zwischenbilder; erfordert zusätzlich stream: true. Laut OpenAI-Dokumentation werden pro Zwischenbild zusätzlich 100 Ausgabe-Tokens berechnet.
Array von Referenzbildern (URL oder base64); nur von der Reihe Qwen unterstützt, 1–3 Bilder.
▸ Details
Andere Reihen melden keinen Fehler, ignorieren den Parameter aber; bei Seedream heißt das Feld für Referenzbilder image.
Legt den Anbieter fest. Optional und in der Regel nicht nötig; das Gateway leitet automatisch weiter. Sinnvoll, wenn Sie Anforderungen an die Inhaltsmoderation haben. Ist ein Anbieter festgelegt und nicht verfügbar, wird nicht automatisch auf einen anderen Anbieter ausgewichen.
▸ Details
Gleichwertig ist der Header X-OfoxAI-Provider-Type. Siehe Erweitert: Anbieter festlegen.
Antwort
{
  "created": 1777385517,
  "data": [
    { "b64_json": "iVBORw0KGgoAAAANSUhEUgAA…", "index": 0 }
  ],
  "model": "openai/gpt-image-2.5-flare",
  "size": "1024x1024",
  "quality": "low",
  "usage": {
    "input_tokens": 13,
    "input_tokens_details": { "text_tokens": 13 },
    "output_tokens": 196,
    "output_tokens_details": { "image_tokens": 196 },
    "total_tokens": 209
  }
}Das Bild als base64, ohne das Präfix data:image/png;base64,.
▸ Details
Dekodieren Sie es und schreiben Sie die Datei; zur Anzeige im Browser müssen Sie das Präfix selbst ergänzen. Ein Feld url enthält die Antwort nicht.
Bildindex; unterscheidet die Bilder bei n > 1.
Die tatsächliche Ausgabegröße. Wurde size weggelassen oder auf auto gesetzt, lesen Sie die tatsächliche Größe hier ab.
Die tatsächlich verwendete Qualitätsstufe. Wurde quality weggelassen, sehen Sie hier, welche Stufe verwendet wurde.
Tatsächlich verwendeter Hintergrund und tatsächlich verwendetes Format. Nicht immer enthalten; verlassen Sie sich nicht auf diese beiden Felder.
Abrechnungsrelevante Nutzung. output_tokens sind die Tokens des ausgegebenen Bildes, input_tokens_details.text_tokens sind die Tokens des Prompts.
▸ Details
Berechnen Sie die Kosten eines Aufrufs anhand dieser Werte.
Bilder bearbeiten
POST https://api.ofox.ai/v1/images/editsDieser Endpunkt unterstützt GPT Image, Nano Banana (Gemini) und MAI Image. Aufrufe mit Seedream und Qwen-Image liefern 400 endpoint_not_supported; verwenden Sie stattdessen das Referenzbildfeld des Generierungs-Endpunkts, siehe Seedream und Qwen-Image.
Anfrageparameter
multipart/form-data: Die Parameter werden als Formularfelder gesendet, die Bilddatei wird hochgeladen. Werte und Standardwerte gelten auch hier für die Reihe GPT Image.
Modell-ID; gleiche Regeln wie beim Generierungs-Endpunkt. Die unterstützten Modelle stehen in der Tabelle oben auf dieser Seite.
Referenzbild als lokale Datei (in cURL mit dem Präfix @), keine URL.
▸ Details
Für mehrere Bilder wiederholen Sie das Feld unter dem Namen image[]. Höchstens 15 MB pro Datei, höchstens 50 MB pro Request-Body; das Gateway begrenzt die Anzahl nicht zusätzlich, empfohlen sind höchstens 16 Bilder.
Die Bearbeitungsanweisung.
Maske für das lokale Neuzeichnen: ein PNG mit Alphakanal in derselben Größe wie image; transparente Bereiche werden neu gezeichnet.
▸ Details
Wirkt nur an diesem Endpunkt; beim Generierungs-Endpunkt wird sie stillschweigend ignoriert. Erstellung und gemessene Wirkung: GPT Image · Inpainting mit Maske.
Ausgabegröße; gleiche Regeln wie beim Generierungs-Endpunkt.
▸ Details
Weggelassen oder auto: Das Modell entscheidet, die Größe entspricht nicht zwingend dem Original. Geben Sie sie explizit an, um die Originalgröße beizubehalten.
Qualitätsstufe; gleiche Regeln wie beim Generierungs-Endpunkt: gpt-image-2 hat kein xhigh / max.
Anzahl der Bilder; jedes Bild wird einzeln abgerechnet.
▶Erweitert · 1X-OfoxAI-Provider-TypeExpand
Legt den Anbieter fest. Optional und in der Regel nicht nötig; das Gateway leitet automatisch weiter. Sinnvoll, wenn Sie Anforderungen an die Inhaltsmoderation haben. Ist ein Anbieter festgelegt und nicht verfügbar, wird nicht automatisch auf einen anderen Anbieter ausgewichen.
▸ Details
Dieser Endpunkt ist ein Multipart-Upload; um einen Anbieter festzulegen, funktioniert nur der Header. Ein Formularfeld extra_body wird stillschweigend ignoriert. Siehe Erweitert: Anbieter festlegen.
Antwort
Gleiche Struktur wie beim Generierungs-Endpunkt; usage enthält zusätzlich die Eingabe-Tokens der Referenzbilder:
{
  "created": 1777385669,
  "data": [
    { "b64_json": "iVBORw0KGgoAAAANSUhEUgAA…", "index": 0 }
  ],
  "model": "openai/gpt-image-2",
  "size": "auto",
  "quality": "low",
  "usage": {
    "input_tokens": 1041,
    "input_tokens_details": { "image_tokens": 1024, "text_tokens": 17 },
    "num_input_images": 1,
    "output_tokens": 358,
    "total_tokens": 1399
  }
}Die für die Referenzbilder berechneten Eingabe-Tokens. Gemessen wurden 1.024 für ein Referenzbild mit 1024×1024. Dieser Posten ist der Hauptgrund, warum eine Bearbeitung mehr kostet als Text zu Bild in derselben Größe.
Anzahl der Referenzbilder. Damit können Sie prüfen, ob das Modell die Referenzbilder tatsächlich eingelesen hat.
Die übrigen Felder entsprechen der Antwort des Generierungs-Endpunkts.
Unterstützte Modelle und Preise finden Sie im Modellkatalog .
Aufruf
Python
import base64
from openai import OpenAI

client = OpenAI(api_key="YOUR_OFOX_API_KEY", base_url="https://api.ofox.ai/v1", timeout=600)

with open("apple.png", "rb") as f:
    resp = client.images.edit(
        model="openai/gpt-image-2",
        image=f,
        prompt="Färbe den Apfel grün, lass alles andere unverändert",
        size="auto",
        quality="low",
    )

with open("apple_edited.png", "wb") as out:
out.write(base64.b64decode(resp.data[0].b64_json))Das Feld image erwartet einen lokalen Dateipfad (in cURL mit dem Präfix @), keine URL.
Gemessener Vergleich:
| Original | Bearbeitet |
|---|---|
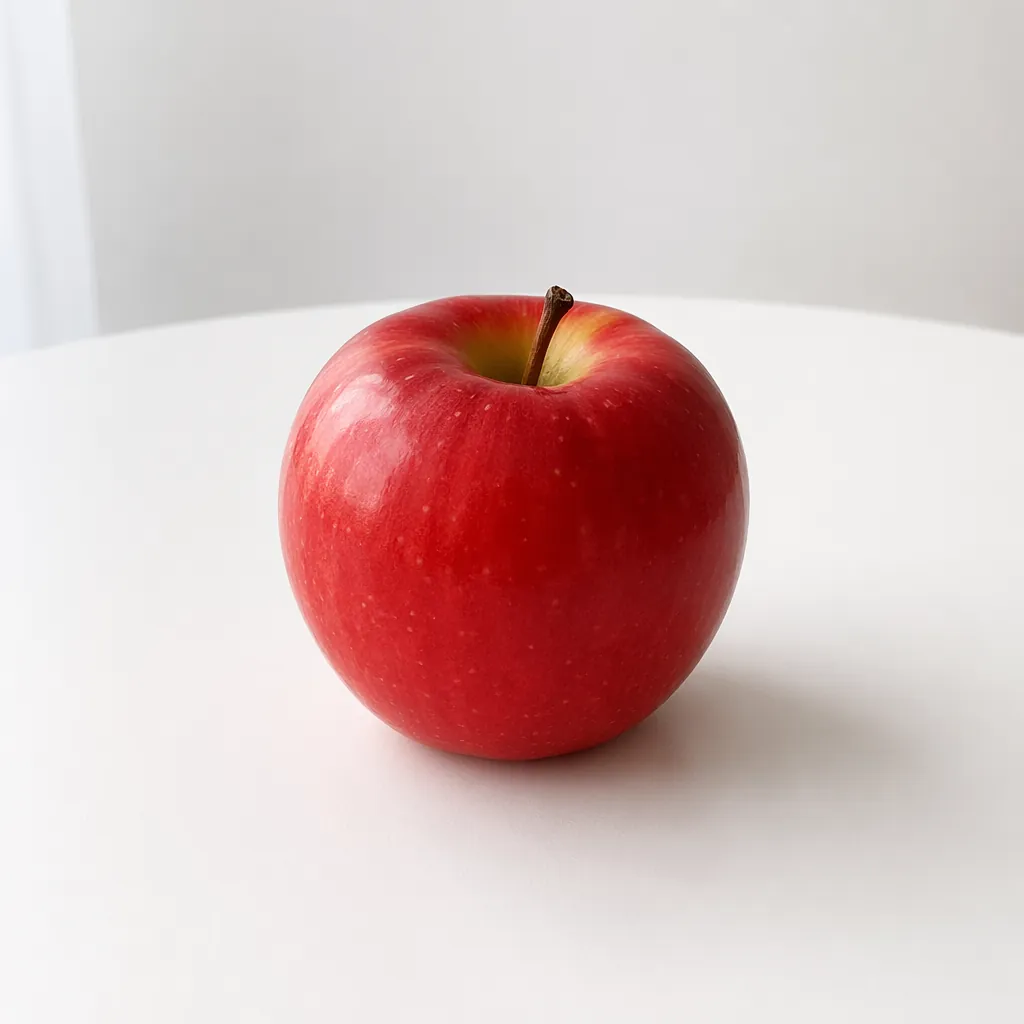 | 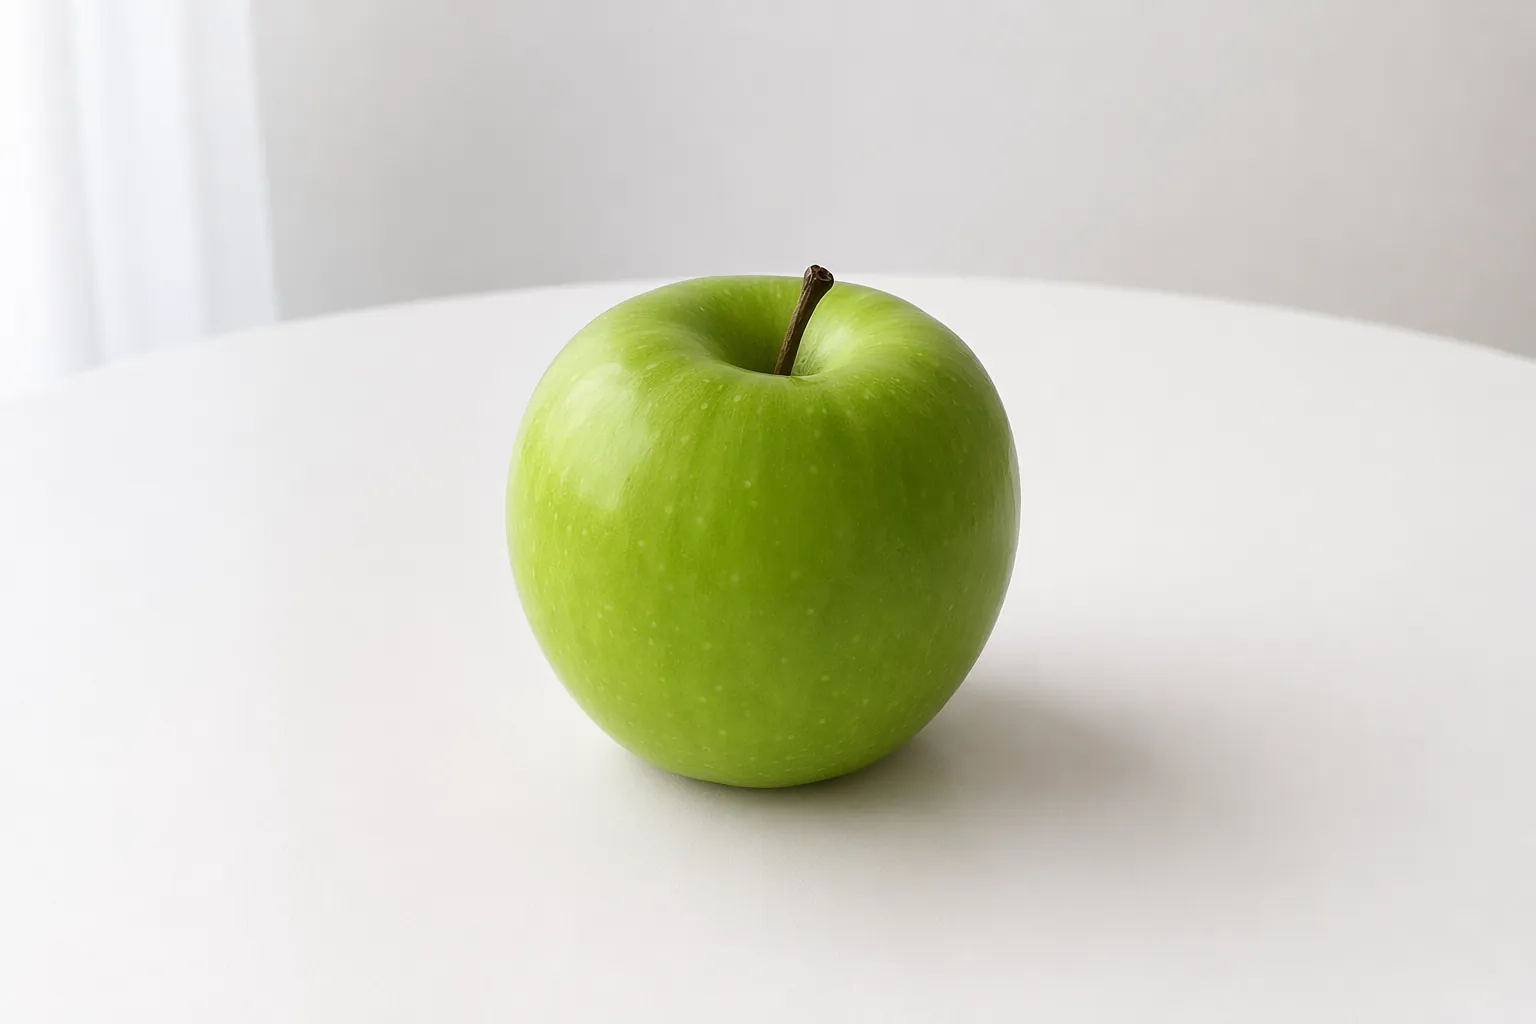 |
Fehler
Im Fehlerfall erhalten Sie einen HTTP-Fehlerstatus und folgende Struktur (gemessen):
{
  "error": {
    "code": null,
    "message": "The model 'gpt-image-2' does not support quality 'xhigh'.",
    "param": null,
    "request_id": "fbe4f24c-779d-41a0-8b3a-c62886cdd1ae",
    "type": "image_generation_user_error"
  }
}
code kann null sein. Werten Sie den HTTP-Status und message aus.
Geben Sie bei Anfragen an den Support die request_id aus der Antwort und die Fehlerinformationen (HTTP-Status und error.message) an. Wir empfehlen, diese Werte zu protokollieren.
Erweitert: Anbieter festlegen
Optional und in der Regel nicht nötig. Alle drei GPT-Image-Modelle (gpt-image-2.5-flare, gpt-image-2.5-sunburst, gpt-image-2) werden sowohl von azure_foundry als auch von openai bereitgestellt, jeweils für Generierung und Bearbeitung. Ohne Festlegung leitet das Gateway automatisch weiter.
Wenn Sie Anforderungen an die Inhaltsmoderation haben, können Sie einen Anbieter festlegen. Anfragen gehen dann nur an diesen Anbieter; ist er nicht verfügbar, wird nicht automatisch auf einen anderen Anbieter ausgewichen.
Die Angabe eines Anbieters, der das Modell nicht bereitstellt, liefert 400 provider_type_unavailable.
Die beiden Anbieter von openai/gpt-image-2 moderieren unterschiedlich streng. Wird ein Prompt wiederholt abgelehnt, können Sie openai explizit festlegen. Ohne Festlegung werden Anfragen gewichtet verteilt und können bei azure_foundry landen.
Text zu Bild /v1/images/generations
JSON-Request-Body: Sowohl das Body-Feld extra_body.provider.type als auch der Header X-OfoxAI-Provider-Type funktionieren.
Python
resp = client.images.generate(
    model="openai/gpt-image-2",
    prompt="A simple red apple on a white table",
    size="1024x1024",
    extra_body={"extra_body": {"provider": {"type": "openai"}}},
)Bei den offiziellen OpenAI-SDKs muss extra_body als wörtlicher Schlüssel im Request-Body stehen. Im TypeScript-SDK schreiben Sie extra_body direkt in das Parameterobjekt. Das Argument extra_body= des Python-SDK führt seinen Inhalt auf der obersten Ebene des Bodys zusammen; verschachteln Sie ihn daher eine Ebene tiefer oder verwenden Sie den Header.
Bild zu Bild /v1/images/edits
Ein Multipart-Upload hat keinen JSON-Body, in den sich extra_body verschachteln ließe; hier funktioniert daher nur der Header.
curl https://api.ofox.ai/v1/images/edits \
  -H "Authorization: Bearer $OFOX_API_KEY" \
  -H "X-OfoxAI-Provider-Type: openai" \
  -F "model=openai/gpt-image-2" \
  -F "prompt=..." \
  -F "image=@input.png"
Mit den SDKs: In Python übergeben Sie extra_headers={"X-OfoxAI-Provider-Type": "openai"}; in TypeScript übergeben Sie { headers: { 'X-OfoxAI-Provider-Type': 'openai' } } als zweites Argument.
An /v1/images/edits wird ein als Formularfeld gesendetes extra_body stillschweigend ignoriert: Das Bild wird normal generiert, die Festlegung greift aber nicht. Verwenden Sie stattdessen X-OfoxAI-Provider-Type.
Vollständige Referenz: API · Provider-Routing.
Offizielle Dokumentation und weitere Seiten
Die offizielle Dokumentation beschreibt das Verhalten bei direktem Aufruf von OpenAI. Weicht sie von den gemessenen Ergebnissen bei OfoxAI ab, gelten die gemessenen Ergebnisse auf dieser Website.
OpenAI
- Leitfaden zur Bildgenerierung · Bilder generieren
- Leitfaden zur Bildgenerierung · Bilder bearbeiten
- Leitfaden zur Bildgenerierung · Mit Maske lokal bearbeiten
- Leitfaden zur Bildgenerierung · Größe und Qualität
- Leitfaden zur Bildgenerierung · Kostenberechnung
- Referenz der Images API
OfoxAI-Seiten der Reihen
- Überblick über die Reihe GPT Image: Modellwahl, Größe, Qualität, Latenz, Fehler
- Text zu Bild
- Bearbeiten und mehrere Bilder
- Inpainting
- Reihe Nano Banana (Gemini Image) und Fehlerbehebung
- Reihe Seedream
- Reihe Qwen-Image
- Reihe MAI Image